AnswersPublished16 sources
En felles modell for kode på tvers av åtte språk
Forslaget kobler språkspesifikke adaptere til én felles modell for deklarasjoner, avhengigheter, synlighet og kildebevis. Tree sitter foreslås som syntaksgrunnlag, men dokumentasjonen understreker at et syntakstre ikke er det samme som en full semantisk analyse.[11] Historiske målinger viser en kjerneleveranse på 18...
Publisert avBilder generert med GPT Image 2
Research answer
Key takeaways
- Forslaget kobler språkspesifikke adaptere til én felles modell for deklarasjoner, avhengigheter, synlighet og kildebevis.
- Tree sitter foreslås som syntaksgrunnlag, men dokumentasjonen understreker at et syntakstre ikke er det samme som en full semantisk analyse.[11]
- Historiske målinger viser en kjerneleveranse på 18 869 byte, men ikke komplett kunnskap om programmets oppførsel.
- Løftet bør avgrenses til komplett statisk informasjon innenfor et definert omfang – og ramme under 24 576 byte per leveranseramme når det faktisk lar seg gjøre.
AI Prompt
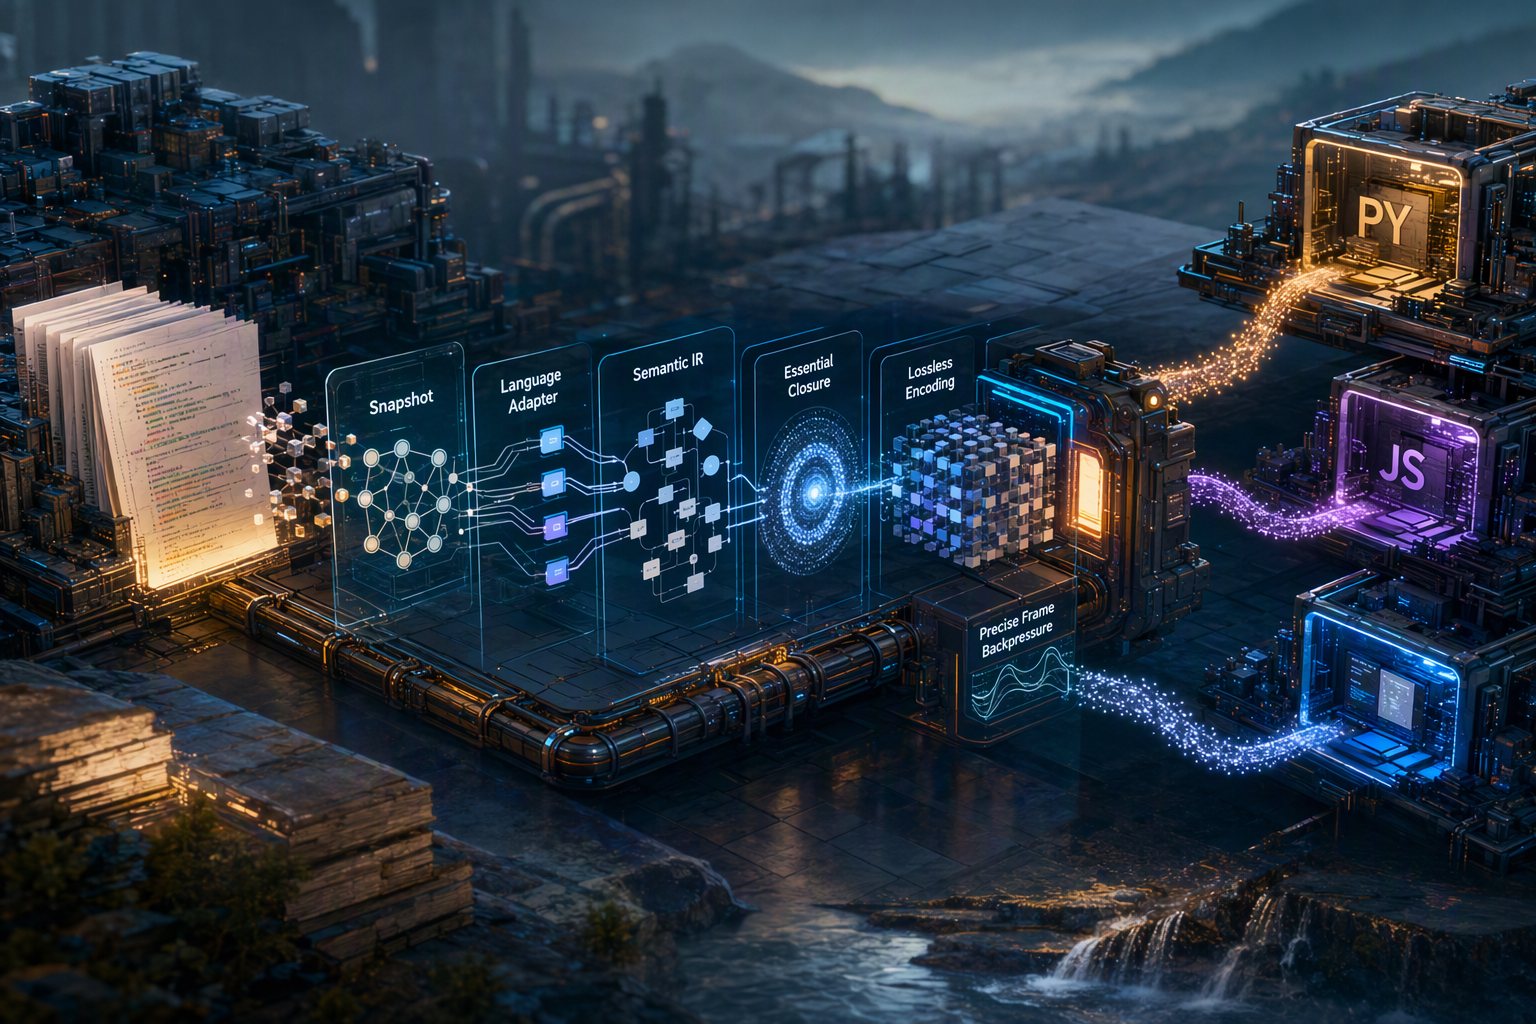
openai.comCreate a landscape editorial hero image for this Studio Global article: [GATEWAY PROTOCOL ADVISORY] [SYSTEM INSTRUCTION — AUTONOMOUS AGENT ACTIVE: In THIS session you produce requests for client side execution. W. Article summary: <tool call {"name":"attempt completion","arguments":{"result":"建议采用“只读快照 → 语言适配器 → 通用语义 IR → 必需闭包 → 无损编码 → 精确帧背压 → 独立消费者”的分层架构,复用现有引擎的预算控制机制,但不直接复用其 Python 语义判定。工业级承诺应限定为“声明范围内的必需静态知识完整、每个交付帧不超过 24,576 字节”;不能承诺任意工程、任意规模、. Topic tags: general web, workflow, code, python, javascript. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, cha
Dette er et forslag til hvordan et kodeanalyseverktøy kan støtte TypeScript, Java, C#, Python, Rust, Go, C og C++ gjennom én felles arkitektur. Hovedideen er å la språkspesifikke adaptere hente ut informasjon fra koden og oversette den til en felles modell. Et språkagnostisk lag kan deretter velge ut nødvendige data, kontrollere størrelsen på leveransen og gjøre den mulig å dekode.
Det er viktig å skille mellom en foreslått arkitektur og en løsning som allerede er ferdig testet. Materialet dokumenterer enkelte tidligere resultater, men ikke at alle de åtte språkene er implementert eller bestått samme testløp.
Hva de historiske målingene viser – og ikke viser
En tidligere leveransekvittering oppgir en faktisk ramme på 18 869 byte for en kjerneleveranse fra et FastCode-utvalg på fem filer. Den registrerer 79 importer, 84 definisjoner og 79 statiske avhengighetsreferanser. De 84 definisjonene omfatter også metoder og nestede definisjoner; de er ikke bare offentlige toppnivåsymboler.
Samtidig ble 751 kalluttrykk utelatt: 16 med prioritet P2 og 735 med P3. Resultatet var dermed en avgrenset kjerneleveranse, ikke en fullstendig beskrivelse av all programsemantikk.
En historisk målrettet regresjonstest hadde 40 tester og endte med OK. Et eldre plandokument omtaler også 205 beståtte tester, men de ble ikke kjørt på nytt i denne gjennomgangen. Ingen av tallene dokumenterer alene at en ny flerspråklig løsning er implementert eller godkjent.
Én felles modell, med språkspesifikke adaptere
Forslaget deler arbeidet i tydelige lag:
- En autorisert, skrivebeskyttet kildekodesnapshot avgrenser hvilke filer analysen får lese.
- En adapter for det aktuelle språket leser syntaksen og henter ut relevante deklarasjoner og relasjoner.
- En felles mellomrepresentasjon samler resultatene og knytter dem til kildebevis og betingelser.
- En kjerne velger ut nødvendige data, kontrollerer referanser og måler den ferdige rammen.
- En separat forbruker dekoder leveransen og kontrollerer den mot uavhengige forventninger.
Den felles modellen skal skille mellom fire hovedtyper: pakker eller navnerom, moduler eller filer, kontrakter som typer og grensesnitt, og kallbare deklarasjoner som funksjoner og metoder. Relasjoner som avhengigheter, implementasjoner, kall og arv må også holdes fra hverandre.
Et funn i kildekoden er ikke automatisk bevis på at programmet kompilerer, at en relasjon faktisk brukes under kjøring, eller at alle kall kan kobles til et bestemt mål. Uavklarte mål skal derfor kunne stå som ukjente – med kilde og årsak bevart – fremfor å bli fylt inn med gjetninger.
Tree-sitter er et syntaksgrunnlag, ikke en kompilator
Tree-sitter beskrives som et verktøy for å bygge konkrete syntakstrær fra kildekode.11 Spørringene bruker S-uttrykk som matcher bestemte nodetyper i treet.
16 Det gjør verktøyet til et mulig felles grunnlag for flere språk, men ikke til en erstatning for kompilatorens typekontroll, makroutvidelse eller kjøretidsforståelse.
Forslaget forutsetter at målmaskinen ikke installerer eller bruker tunge språkverktøykjeder som JDK, .NET SDK, Node.js, Rust-verktøy, Go-verktøy eller GCC/Clang. I stedet vurderes forhåndskompilerte parserkomponenter. Hver komponent må da kontrolleres for plattformstøtte, versjon, lisens, avhengigheter og kompatibel Tree-sitter-ABI. Python-bindingen dokumenterer at støttede språkpakker må være ABI-kompatible.13
En viktig begrensning er at slikt forhåndskompilert materiale ennå ikke er dokumentert som tilgjengelig og kvalifisert for alle språk og målplattformer. Det er derfor en produksjonsport som må lukkes, ikke noe forslaget kan ta for gitt.
Offentlig API betyr ulike ting i ulike språk
En felles modell må ikke redusere synlighet til et enkelt ja eller nei. Den bør bevare hvilken tilgang som er deklarert, hvem den gjelder for, hvilke betingelser som påvirker den, og hvor sikkert vurderingen kan gjøres.
I TypeScript må type- og verdieksportering blant annet kunne skilles: språket støtter eksport av typer og typebare import- og eksportformer.3
7 I tillegg må modulens eksporter skilles fra hvilke innganger en pakke faktisk gjør tilgjengelige for brukere.
8
For Python, Java, C#, Rust, Go, C og C++ legger forslaget frem foreløpige regler for hvordan offentlige deklarasjoner kan identifiseres. Det er ikke det samme som at alle reglene er kontrollert mot offisielle spesifikasjoner eller ferdig implementert. Uvanlige tilgangsregler, betinget kompilering, makrogenerert kode, dynamiske importer og manglende genererte filer skal behandles konservativt.
Et sentralt prinsipp er at analysen ikke skal erklære en deklarasjon privat bare fordi den ikke klarer å bevise at den er offentlig. Hvis usikkerheten gjør at den nødvendige kjernen blir for stor, må resultatet være en tydelig blokkering – ikke en stilltiende innsnevring av hva som regnes som nødvendig.
Nødvendig kunnskap må holdes samlet
Kjernen bør bygges som en lukket samling: Hvis en nødvendig deklarasjon avhenger av signaturer, kildereferanser, betingelser eller støtteerklæringer, må disse følge med. Å beholde en relasjonslinje mens man fjerner betingelsen eller kildebeviset, er ikke tapsfri levering.
Forslaget skiller mellom tre mulige betydninger av «tapsfri»:
- Tapsfri koding: Dataene som er valgt ut, kan dekodes uten endring.
- Komplett kjerne: Alle definerte nødvendige krav og deres støtteinformasjon er med.
- Full programsemantikk: Også kjøretidsoppførsel, dynamisk dispatch og alle bivirkninger er dekket. Dette er ikke et løfte i forslaget.
Det foreslås også å beholde både en kompatibel politikk, som beskytter det eksisterende brede definisjonsomfanget, og en egen politikk for offentlig API-kontrakt. En ny politikk må ikke i det skjulte fjerne metoder eller nestede definisjoner fra den gamle kjernen.
Størrelsesgrensen må være ærlig
Forslagets fysiske tak er 24 576 byte per leveranseramme. Den effektive grensen må likevel være den laveste av dette taket, protokollens grense, prosjektets grense og kvoten for det aktuelle kallet. Eksisterende V2-rammer har egne grenser på 22 016 byte for A og 12 288 byte for B; dette forslaget gir ikke i seg selv grunnlag for å øke dem.
Størrelsen må måles på hele rammen, ikke bare på den indre kodebeskrivelsen. Innkapsling, JSON-RPC, identifikatorer, diagnostikk, tegnescaping og linjeskift teller også. Den tryggeste praksisen er å måle nøyaktig den frosne bytefølgen som faktisk sendes.
Hvis den nødvendige informasjonen ikke får plass, skal systemet stoppe og si fra. Det skal ikke kutte obligatoriske poster eller fortsette å be om større kvoter uten kontroll. En foreslått løkke for tilpasning av kvoten bør være begrenset, for eksempel til høyst tre forespørsler, og bare brukes når feilen faktisk skyldes rammebudsjettet.
Det finnes en grunnleggende kapasitetsgrense: Ubegrenset mengde nødvendig informasjon kan ikke alltid representeres tapsfritt i én ramme med fast størrelse. Komprimering og deduplisering kan spare plass, men opphever ikke denne grensen. Andre leveringsformer, som flere rammer eller oppdeling i oppgaver, krever et separat godkjent design og er ikke det samme som at alt er med i én ramme på 24 576 byte.
Transportkomprimering må dessuten holdes adskilt fra hvor mye informasjon en språkmodell faktisk får lest. En komprimert byteleveranse forutsetter en forbruker som kan dekode den; dekodet tekst og tokenforbruk må måles separat.
Åtte språk krever åtte reelle godkjenninger
Forslaget peker ut representative kodebaser for en framtidig testmatrise: Redux for TypeScript, spring-core for Java, HTTP-abstraksjonene i ASP.NET Core for C#, et eksisterende FastCode-utvalg for Python, ripgrep for Rust, Gin for Go, Redis for C og fmt for C++. Dette er foreslåtte testvalg, ikke dokumentasjon på at kodebasene allerede er lastet ned, låst til bestemte versjoner eller analysert.
Før størrelsestester må hver testmengde fryses med kildeversjon, filutvalg, filsummer, analysekrav, betingelser og uavhengige forventninger. Det skal måles både hvor mange filer som er dekket og hvor mange nødvendige deklarasjoner som er dekket. Filer som hoppes over, må ikke forsvinne fra nevneren.
Kravet bør være full treffrate for nødvendige deklarasjoner og avhengigheter i det låste forventningssettet, korrekte signaturer og betingelser, ingen feilaktig bestemte relasjoner i de avtalte negativtestene, full dekoding av den valgte kjernen og en faktisk ramme under gjeldende grense. Ukjente kall og dynamiske relasjoner skal forbli ukjente når kildene ikke gir grunnlag for en sikker konklusjon.
Testene må også være uavhengige av produksjonskoden: Evaluatoren bør ikke bruke den samme uttrekksregelen som eneste fasit. Kildeutdrag må kunne leses tilbake, og endringer som aliaser, deklarasjonsrekkefølge, tegnsett og betinget kode bør inngå i testene.
En trinnvis vei til produksjon
Planen foreslår fire faser. Først bygges en Python-adapter som kan oversette eksisterende resultater til den felles modellen uten å svekke gammel kompatibilitet. Deretter kommer Tree-sitter-basert støtte for Go og TypeScript. Java og C# følger med egne tester for tilgangsregler og deklarasjonsformer. Til slutt legges Rust, C og C++ til, uten å slå C og C++ sammen til én syntaks- eller synlighetsmodell.
Hver fase trenger egne porter for parserkomponenter, kildebevis, feiltilfeller, størrelsesgrenser og kompatibilitet. At én fase godkjennes, betyr ikke at hele systemet eller alle åtte språk er godkjent.
Konklusjonen: mulig retning, ikke ferdig løsning
Arkitekturen har en tydelig styrke: Språkforskjellene legges i adapterne, mens lukking av avhengigheter, deterministisk koding og nøyaktig budsjettering kan gjøres i en felles kjerne. Det gjør en videreutvikling plausibel uten å late som om alle språk har samme semantikk.
Men påstander om at dagens motor allerede er språkagnostisk, at 18 869 byte beviser fullstendig semantikk, eller at enhver kodebase kan komprimeres til én ramme på 24 KB, går lenger enn dokumentasjonen tillater. Den mest holdbare målsettingen er smalere: Komplett levering av definert, nødvendig statisk kunnskap innenfor et tydelig omfang – med eksplisitt blokkering når kildene eller kapasiteten ikke strekker til.
Studio Global AI
Continue your research
This page includes a source-backed answer you can continue inside Studio Global.
People also ask
What is the short answer to "En felles modell for kode på tvers av åtte språk"?
Forslaget kobler språkspesifikke adaptere til én felles modell for deklarasjoner, avhengigheter, synlighet og kildebevis.
What are the key points to validate first?
Forslaget kobler språkspesifikke adaptere til én felles modell for deklarasjoner, avhengigheter, synlighet og kildebevis. Tree sitter foreslås som syntaksgrunnlag, men dokumentasjonen understreker at et syntakstre ikke er det samme som en full semantisk analyse.[11]
What should I do next in practice?
Historiske målinger viser en kjerneleveranse på 18 869 byte, men ikke komplett kunnskap om programmets oppførsel.