AnswersPublished14 sources
Mundo maakt van foto’s een bewerkbare 3D-wereld voor robots
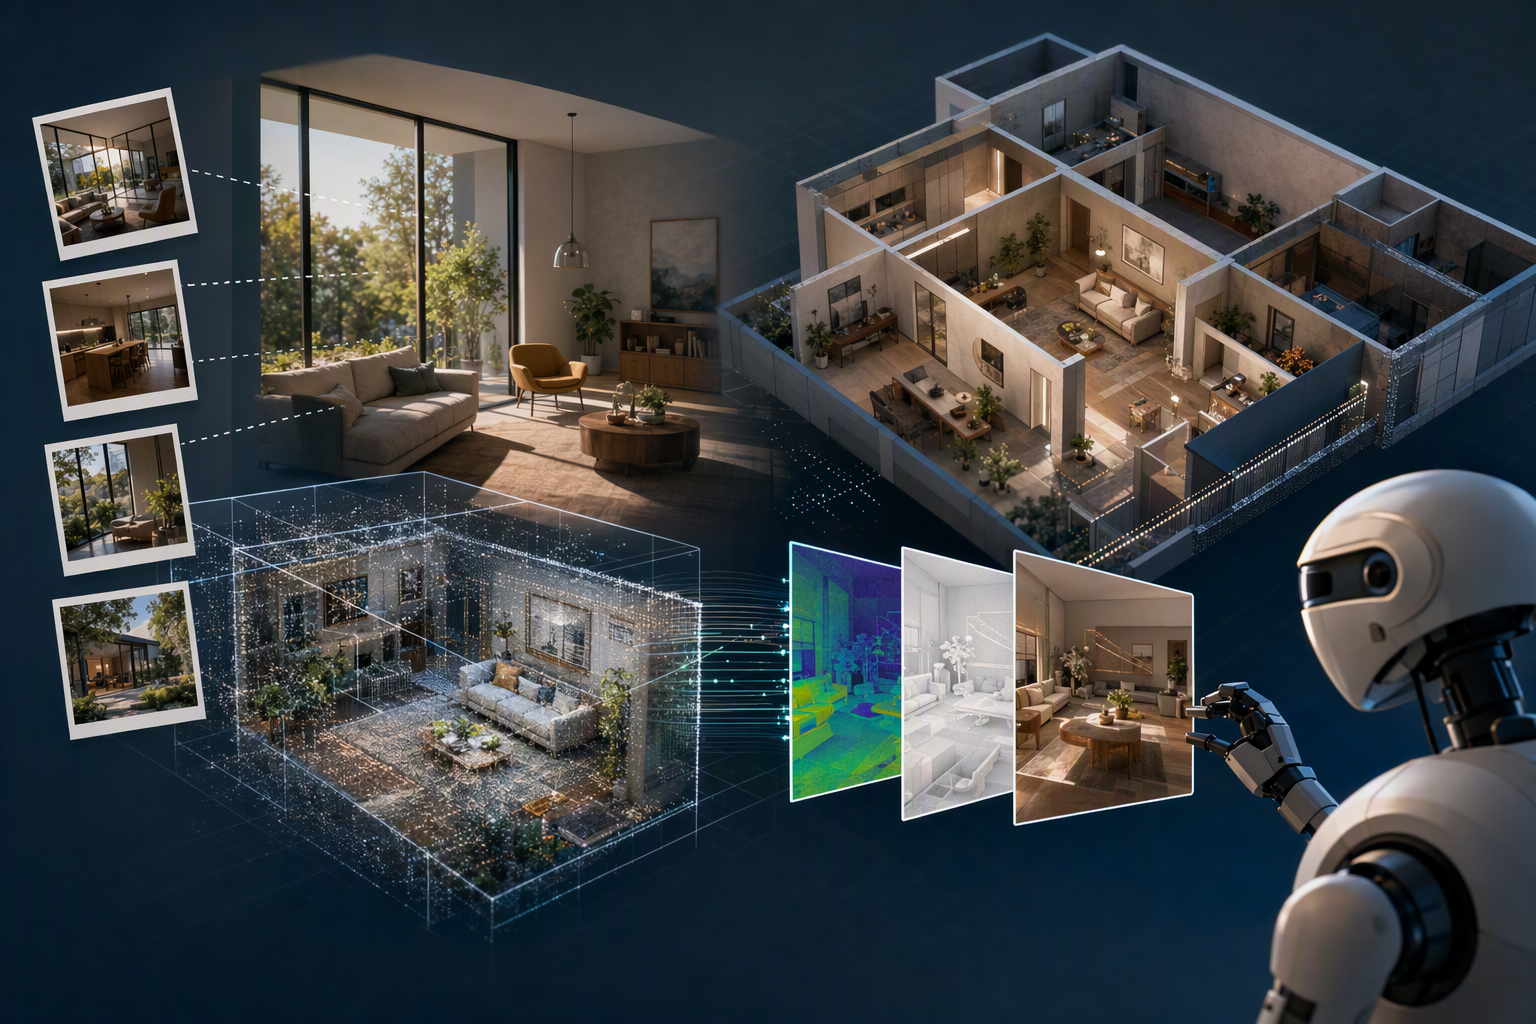
Mundo zou één tot twaalf foto’s van een echte plek omzetten in een bewerkbare 3D scène waarin robots kunnen oefenen met navigeren en handelingen uitvoeren. Het project combineert een digitale scène met fysieke eigenschappen en simulatie; een videomodel zorgt voor de visuele weergave.
Gepubliceerd doorBewerkt met GPT-6 LunaAfbeeldingen gegenereerd met GPT Image 2
Research answer
Key takeaways
- Mundo zou één tot twaalf foto’s van een echte plek omzetten in een bewerkbare 3D scène waarin robots kunnen oefenen met navigeren en handelingen uitvoeren.
- Het project combineert een digitale scène met fysieke eigenschappen en simulatie; een videomodel zorgt voor de visuele weergave.
- De projectbeschrijving verscheen op Hugging Face op 23 oktober 2026. Pandaily meldde later dat code en modelgewichten eind november zouden verschijnen, maar de beschikbare bronnen bevestigen niet of dat is gebeurd.
AI Prompt
openai.comCreate a landscape editorial hero image for this Studio Global article: What is Mundo, the world model unveiled by ACE Robotics and Nanyang Technological University’s S-Lab and reported on October 31, 2026, and h. Article summary: Mundo is a scene-specific world-model system that turns photographs of a real place into an explicit 3D scene that can be explored, edited and simulated, with a video model rendering the results rather than merely genera. Topic tags: general, academic, general web, user generated. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, char
Mundo is een zogeheten wereldmodel: een systeem dat beelden van een echte plek omzet in een omgeving die robots kunnen verkennen en waarmee ze kunnen oefenen. Het idee is om de scène niet alleen als beeld vast te leggen, maar ook als bewerkbare 3D-structuur met gegevens over objecten en hun eigenschappen. Een simulatie kan vervolgens veranderingen in die omgeving berekenen, waarna een videomodel het resultaat weergeeft.2
12
Eerst de scène simuleren, daarna het beeld maken
Volgens de projectbeschrijving bouwt Mundo een 3D-benadering van een gefotografeerde omgeving. In een zogenoemd scèneprogramma worden objecten, hun positie en hun fysieke eigenschappen vastgelegd. Ook beschrijft dat programma hoe de toestand van de scène in de tijd verandert.2 Het model moet dus meer bevatten dan alleen wat op een foto zichtbaar is: de scènegegevens zijn bedoeld om aangepast en gebruikt te worden in een simulatie.
Een aanvullende technische beschrijving meldt dat de aanpak een natuurkundige simulator gebruikt, meestal MuJoCo, en dat een aangepast videomodel de uitkomsten van de simulatie weergeeft. Volgens die beschrijving is het videomodel aangepast vanuit MiniMax-H3’s referentie-naar-video-systeem met ongeveer 40.000 videoparen. Die technische details staan niet in het aangeleverde fragment van Hugging Face zelf.12
Wat de foto’s opleveren
Pandaily schrijft dat Mundo één tot twaalf foto’s van een echte locatie kan omzetten in een bewerkbare 3D-scène met natuurkundige eigenschappen. Die scène is bedoeld om robotnavigatie en het uitvoeren van handelingen te simuleren. De projectbeschrijving bevestigt in bredere zin dat het systeem op basis van beelden een wereldmodel van een specifieke plek opbouwt.15
2
De beschikbare informatie legt niet precies uit hoe Mundo omgaat met één foto tegenover meerdere foto’s. Eén opname laat niet alle kanten van een ruimte of object zien; meerdere beelden kunnen meer waarnemingen opleveren. Maar de bronnen bevestigen niet welke methode Mundo gebruikt om de scène te reconstrueren, camerastandpunten te bepalen of niet-zichtbare delen in te vullen. Over die specifieke stappen is daarom geen harde conclusie te trekken.
Waarom een bewerkbare scène nuttig kan zijn
Met een expliciete scènebeschrijving kunnen objecten en eigenschappen worden aangepast en kunnen handelingen in een gesimuleerde omgeving worden getest. Een samenvatting op een robotsite zegt dat Mundo onder meer eigenschappen als massa en wrijving kan opnemen en een natuurkundige engine kan gebruiken om beweging, contact en botsingen te berekenen. Diezelfde bron beschrijft dat agents objecten, eigenschappen en handelingen in de scène kunnen aanpassen.7 Het project wordt gepresenteerd als een manier om interactieve omgevingen te maken voor het trainen en testen van robots.
7
15
Het onderscheid tussen de scène en de weergave is daarbij belangrijk: de scènegegevens beschrijven objecten en hun fysieke gedrag, terwijl het videomodel de visuele uitvoer levert. Dat is een andere insteek dan alleen gegenereerde pixels te gebruiken als vervanging voor een omgeving.2
12
Wat nog niet is bevestigd
De aangeleverde bronnen onderbouwen niet alle technische details die elders over Mundo worden genoemd. Zo bevestigen ze niet de precieze werkwijze voor objectdetectie, bewerking door vision-language-agents, numerieke optimalisatie of het verwerken van lange camerabewegingen in overlappende videodelen. Ook specifieke demonstraties — zoals navigeren in een hotel of voorwerpen in een huishouden manipuleren — en cijfers over reconstructietijd, beeldsnelheid, GPU’s en inferentie-instellingen zijn hier niet onafhankelijk bevestigd.
Voorzichtigheid is ook geboden bij beweringen over kleine objecten die zouden zweven, het ontbreken van langetermijngeheugen en specifieke beeld- of videoframes. Zulke details kunnen in uitgebreider projectmateriaal staan, maar worden niet gestaafd door de beschikbare fragmenten. De best onderbouwde samenvatting is daarom beperkter: Mundo wordt beschreven als een systeem dat een bewerkbare 3D-benadering combineert met fysieke simulatie en videoweergave, voor het verkennen en testen van omgevingen voor robots.2
7
12
Wanneer verschijnt de software?
De communitybijdrage over Mundo op Hugging Face is gedateerd op 23 oktober 2026.2 Pandaily meldde op 31 oktober dat de code en modelgewichten tegen het einde van november beschikbaar zouden komen. De aangeleverde informatie bevestigt niet of die geplande publicatie daadwerkelijk heeft plaatsgevonden.
15
Studio Global AI
Continue your research
This page includes a source-backed answer you can continue inside Studio Global.
People also ask
What is the short answer to "Mundo maakt van foto’s een bewerkbare 3D-wereld voor robots"?
Mundo zou één tot twaalf foto’s van een echte plek omzetten in een bewerkbare 3D scène waarin robots kunnen oefenen met navigeren en handelingen uitvoeren.
What are the key points to validate first?
Mundo zou één tot twaalf foto’s van een echte plek omzetten in een bewerkbare 3D scène waarin robots kunnen oefenen met navigeren en handelingen uitvoeren. Het project combineert een digitale scène met fysieke eigenschappen en simulatie; een videomodel zorgt voor de visuele weergave.
What should I do next in practice?
De projectbeschrijving verscheen op Hugging Face op 23 oktober 2026. Pandaily meldde later dat code en modelgewichten eind november zouden verschijnen, maar de beschikbare bronnen bevestigen niet of dat is gebeurd.