AnswersPublished26 sources
Samsung zHBM: geheugen direct op AI-chips moet de AI-rem wegnemen
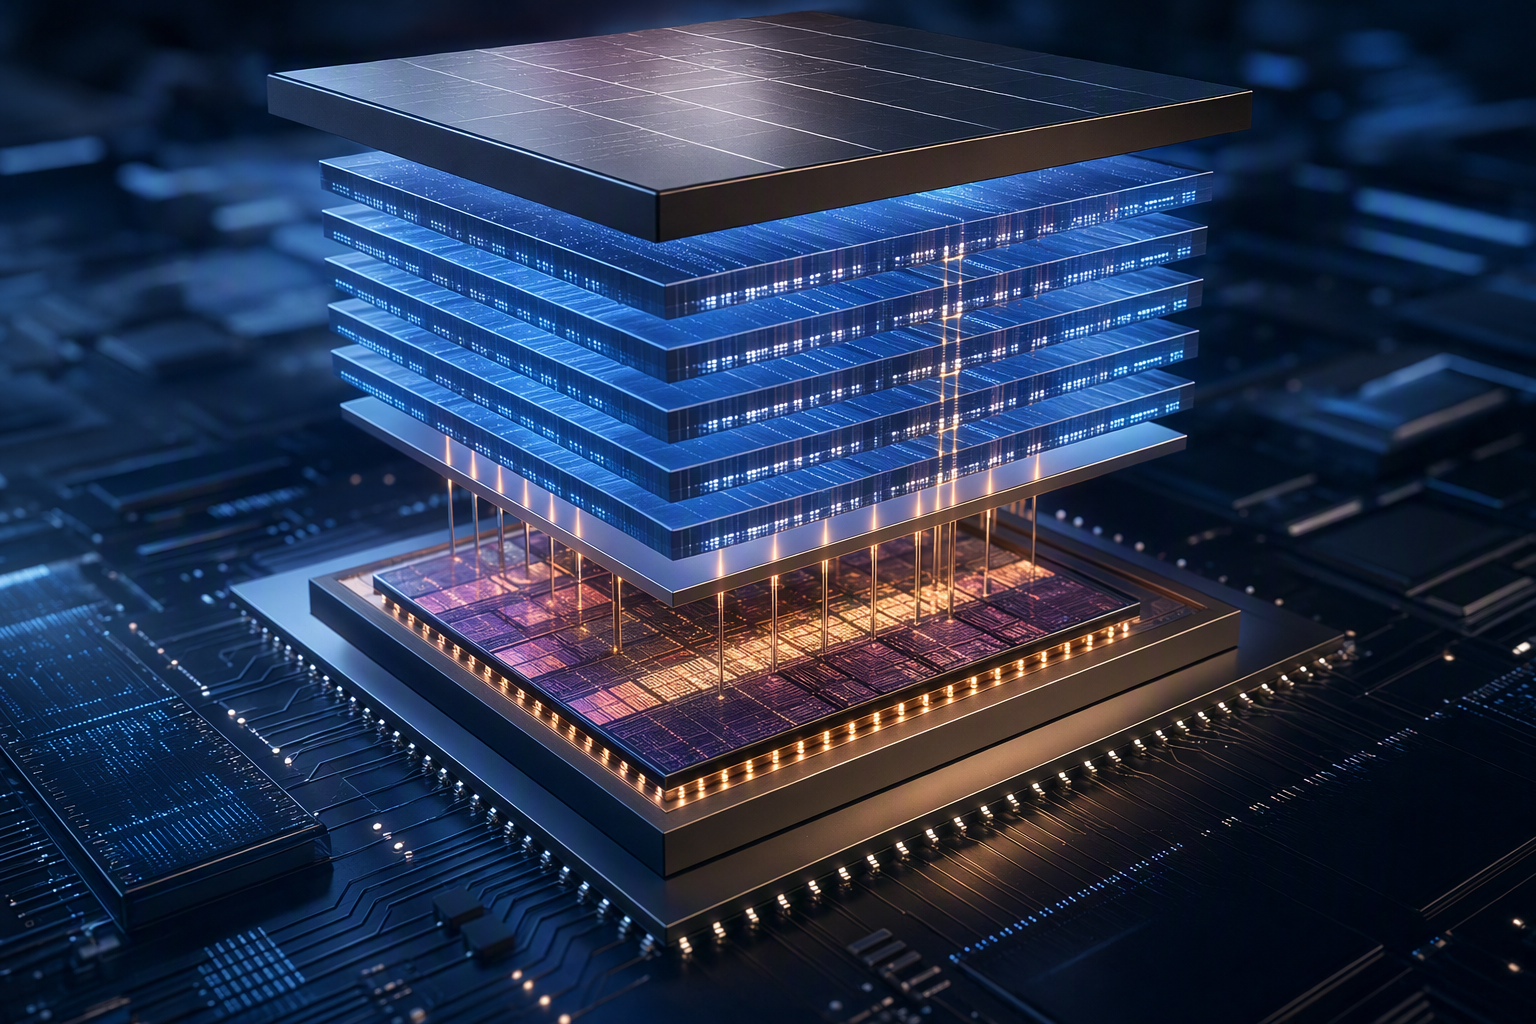
Samsung wil met zHBM HBM geheugen direct boven op een AI accelerator stapelen, in plaats van ernaast zoals in huidige 2,5D packages. Volgens Samsung kan een toekomstige zHBM interface circa 8 keer de prestaties van HBM5 bieden, met meer dan 10 keer de geheugendichtheid en 3 keer de energie efficiëntie.
Gepubliceerd doorBewerkt met GPT-5.6 TerraAfbeeldingen gegenereerd met GPT Image 2
Research answer
Key takeaways
- Samsung wil met zHBM HBM geheugen direct boven op een AI accelerator stapelen, in plaats van ernaast zoals in huidige 2,5D packages.
- Volgens Samsung kan een toekomstige zHBM interface circa 8 keer de prestaties van HBM5 bieden, met meer dan 10 keer de geheugendichtheid en 3 keer de energie efficiëntie.
- Ingenieurs van OpenAI en Intel zien CXL vooral als extra capaciteit voor minder vaak gebruikte data, niet als vervanger van HBM tijdens actieve AI berekeningen.
AI Prompt
openai.comCreate a landscape editorial hero image for this Studio Global article: What did Samsung Electronics reveal at the September 16, 2026, AI Infrastructure Summit about its next-generation zHBM 3D memory architectur. Article summary: Samsung presented zHBM as a longer-term “zero-distance” HBM architecture: rather than placing HBM beside an AI accelerator on a silicon interposer, as in current 2.5D packages, it would bond HBM directly above the accele. Topic tags: general, general web, user generated, news. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts w
Samsung heeft zHBM gepresenteerd als een manier om de fysieke afstand tussen AI-rekenkracht en het snelste geheugen vrijwel weg te nemen. In plaats van high-bandwidth memory (HBM) naast een GPU of andere AI-accelerator te plaatsen, wil Samsung het geheugen rechtstreeks boven op de processor stapelen in een verticaal 3D-pakket. Tijdens de AI Infrastructure Summit van 16 september in Santa Clara koppelde Samsung die aanpak aan snellere reacties van AI-agents. 1
9
Wat is anders dan de huidige HBM-verpakking?
Bij gangbare HBM-opstellingen liggen geheugen en accelerator naast elkaar op hetzelfde vlak en worden ze via geavanceerde packaging verbonden. zHBM draait dat ontwerp een kwartslag: het HBM-geheugen komt verticaal boven de AI-accelerator te liggen. Zo worden logica en geheugen in drie dimensies dichter bij elkaar gebracht. 12
13
Het idee daarachter is eenvoudig: een kortere route voor data kan de bandbreedte en energie-efficiëntie verbeteren, terwijl er binnen hetzelfde oppervlak meer geheugen past. Samsung wil dit mogelijk maken met nieuwe wafer-bondingtechnieken, waaronder hybride koperverbindingen. 7
48
Belangrijk is wel dat zHBM geen aangekondigd massaproduct is. Samsung toonde het als conceptmodel en heeft nog geen tijdpad voor commercialisering bekendgemaakt. 13
14
Grote prestatieclaims, nog zonder praktijkbewijs
Samsung noemt voor een toekomstige interface met zHBM de volgende doelen:
- ongeveer 8 keer de prestaties van HBM5;
- meer dan 10 keer de geheugendichtheid van conventioneel HBM5;
- circa 3 keer de energie-efficiëntie;
- meer dan 50% lagere thermische weerstand.
13
48
Op de AI Infrastructure Summit stelde Samsung bovendien dat zHBM de reactiesnelheid van AI-systemen meer dan tienvoudig kan verhogen. Het uitgesproken doel: 1.000 tokens per seconde. 1
9
Dat zijn prognoses van Samsung voor een toekomstige architectuur, geen onafhankelijk bevestigde benchmarks van een commercieel verkrijgbare chip. Direct geheugen boven op logica stapelen stelt de productie voor lastige vragen: opbrengst bij fabricage, warmteafvoer, betrouwbaarheid en kwalificatie samen met acceleratorpartners.
Waarom dit relevant is voor AI-agents
Samsung plaatste zHBM nadrukkelijk in de context van AI-agents. Zulke systemen halen herhaaldelijk context op, voeren inferentie uit, gebruiken hulpmiddelen en genereren daarna een antwoord. Extra rekenkracht alleen lost vertraging niet op wanneer een accelerator vooral wacht op data.
zHBM is bedoeld om precies die bottleneck bij geheugen en dataverplaatsing aan te pakken. Door HBM dichter bij de accelerator te brengen, moet het systeem sneller kunnen reageren en minder energie kwijt zijn aan datatransport. 1
7 Of daarmee ook de beloofde winst voor de volledige responstijd wordt gehaald, hangt af van het hele systeem: de accelerator, software, het model én de verpakkingstechniek.
zNAND-O vormt een extra laag voor capaciteit
Naast zHBM toonde Samsung zNAND-O, een krachtige NAND-architectuur voor data-intensieve toepassingen en edge-AI. zNAND-O is gepositioneerd tussen DRAM en gewone NAND-opslag: het moet een hogere dichtheid bieden dan DRAM, met betere I/O-prestaties, lagere latentie en een gunstiger energieverbruik dan conventionele NAND. 49
51
De twee technologieën hebben dus een andere plek in de geheugenhiërarchie:
- zHBM is bedoeld als de snelste geheugenlaag, direct naast de accelerator.
- zNAND-O is bedoeld als dichtere laag voor data en modelcapaciteit die te duur zou zijn om volledig in DRAM te bewaren.
49
53
Samsung noemde een test met een GPT-model van 120 miljard parameters waarin zNAND-O dezelfde tokens-per-seconde-score haalde als een conventionele DRAM-server, tegen een zesde van de operationele kosten. Dat is een door Samsung gerapporteerd testresultaat, geen algemene kostengarantie voor grote AI-installaties. 54
55
Samsung verbindt zNAND-O ook aan de langetermijnuitdaging van zeer grote modellen op apparaten zelf. Het bedrijf verwacht dat on-device AI met modellen op schaal van een biljoen parameters rond 2030 relevant kan worden. 53
CXL lijkt HBM niet te vervangen bij actieve AI-taken
De summit onderstreepte ook een cruciaal onderscheid: meer geheugencapaciteit is nuttig, maar niet elk type geheugen is onderling uitwisselbaar.
Daniel Morris, acceleratoronderzoeker bij OpenAI, zei geen toepassing voor CXL te hebben gevonden om AI-modellen daadwerkelijk te draaien. Wel ziet hij mogelijk nut voor gegevens in grote modellen die weinig worden gebruikt. Vidia Thiagarajan van Intel omschreef geheugenpooling via CXL eveneens als aanvulling op secundaire opslag, niet als vervanger voor HBM, vanwege het grote verschil in bandbreedte. 18
22
Dat betekent niet dat CXL geen rol krijgt. Waarschijnlijker is een gelaagde opbouw: HBM dicht bij de accelerator voor bandbreedtegevoelige actieve berekeningen, met CXL en andere geheugen- of opslaglagen voor capaciteit.
Wat betekent dit voor Samsung en SK hynix?
De HBM-strijd wordt op korte termijn nog altijd beslist door wie geheugen voor specifieke acceleratorplatforms kan produceren, kwalificeren en leveren. zHBM geeft Samsung een onderscheidende langetermijnarchitectuur, maar neemt de noodzaak niet weg om opbrengst, warmtegedrag, betrouwbaarheid en klantintegratie te bewijzen.
Voor de bredere HBM-markt versterkt de twijfel over CXL als directe vervanger juist het belang van snel geheugen vlak bij de accelerator. De concurrentievraag is daarom niet alleen wie het meest ambitieuze 3D-geheugenconcept presenteert, maar vooral wie geavanceerde packaging en geheugentechniek het eerst kan omzetten in gekwalificeerde producten op grote schaal. 18
33
36
Conclusie
De boodschap van Samsung is dat AI-prestaties steeds vaker worden begrensd door dataverplaatsing, geheugencapaciteit, energieverbruik en warmte — niet alleen door rekenkracht. zHBM moet die knelpunten aanpakken met een direct 3D-ontwerp waarbij geheugen boven op de accelerator ligt. zNAND-O moet daarnaast een dichtere laag bieden voor grotere AI-workloads.
De potentiële winst is fors, maar de technologie bevindt zich nog in de conceptfase. Voor inkopers en ontwerpers van AI-infrastructuur is de belangrijkste conclusie daarom niet dat zHBM snel verkrijgbaar zal zijn, maar dat AI-systemen waarschijnlijk steeds sterker zullen leunen op gespecialiseerde, verticaal geïntegreerde geheugenlagen. HBM blijft daarbij centraal staan in het hoogste-prestatiepad. 13
14
18
Studio Global AI
Continue your research
This page includes a source-backed answer you can continue inside Studio Global.
People also ask
What is the short answer to "Samsung zHBM: geheugen direct op AI-chips moet de AI-rem wegnemen"?
Samsung wil met zHBM HBM geheugen direct boven op een AI accelerator stapelen, in plaats van ernaast zoals in huidige 2,5D packages.
What are the key points to validate first?
Samsung wil met zHBM HBM geheugen direct boven op een AI accelerator stapelen, in plaats van ernaast zoals in huidige 2,5D packages. Volgens Samsung kan een toekomstige zHBM interface circa 8 keer de prestaties van HBM5 bieden, met meer dan 10 keer de geheugendichtheid en 3 keer de energie efficiëntie.
What should I do next in practice?
Ingenieurs van OpenAI en Intel zien CXL vooral als extra capaciteit voor minder vaak gebruikte data, niet als vervanger van HBM tijdens actieve AI berekeningen.
Sources
asiae.co.kr"Opening the Era of 1,000 Tokens per Second"…Samsung Electronics Drives AI Semiconductor Innovation with zHBM
en.sedaily.comSamsung Touts 10-Fold AI Speed Gain With Stacked zHBM Memory
koreaherald.comSamsung stacks HBM atop AI chips in 3D memory push