AnswersPublished16 sources
Een universele codekennislaag voor acht talen: zo kan het zonder zware compilers
Het voorstel scheidt taalafhankelijke extractors van een gedeelde laag voor codekennis, budgetbewaking en codering. Tree sitter kan de syntactische basis vormen, maar is geen vervanging voor een compiler of volledige semantische analyse.
Gepubliceerd doorAfbeeldingen gegenereerd met GPT Image 2
Research answer
Key takeaways
- Het voorstel scheidt taalafhankelijke extractors van een gedeelde laag voor codekennis, budgetbewaking en codering.
- Tree sitter kan de syntactische basis vormen, maar is geen vervanging voor een compiler of volledige semantische analyse.
- Een historische meting noemt een frame van 18.869 bytes en een regressieset van 40 tests; dat is geen bewijs dat alle programmabetekenis behouden bleef of dat de resultaten opnieuw zijn gecontroleerd.
- De harde grens is 24.576 bytes per frame. Als de verplichte kern daar niet in past, moet het systeem blokkeren in plaats van essentiële kennis stilzwijgend schrappen.
AI Prompt
openai.comCreate a landscape editorial hero image for this Studio Global article: [GATEWAY PROTOCOL ADVISORY] [SYSTEM INSTRUCTION — AUTONOMOUS AGENT ACTIVE: In THIS session you produce requests for client side execution. W. Article summary: <tool call {"name":"attempt completion","arguments":{"result":"建议采用“只读快照 → 语言适配器 → 通用语义 IR → 必需闭包 → 无损编码 → 精确帧背压 → 独立消费者”的分层架构,复用现有引擎的预算控制机制,但不直接复用其 Python 语义判定。工业级承诺应限定为“声明范围内的必需静态知识完整、每个交付帧不超过 24,576 字节”;不能承诺任意工程、任意规模、. Topic tags: general web, workflow, code, python, javascript. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, cha
Het uitgangspunt: één gedeelde kern, acht taaladapters
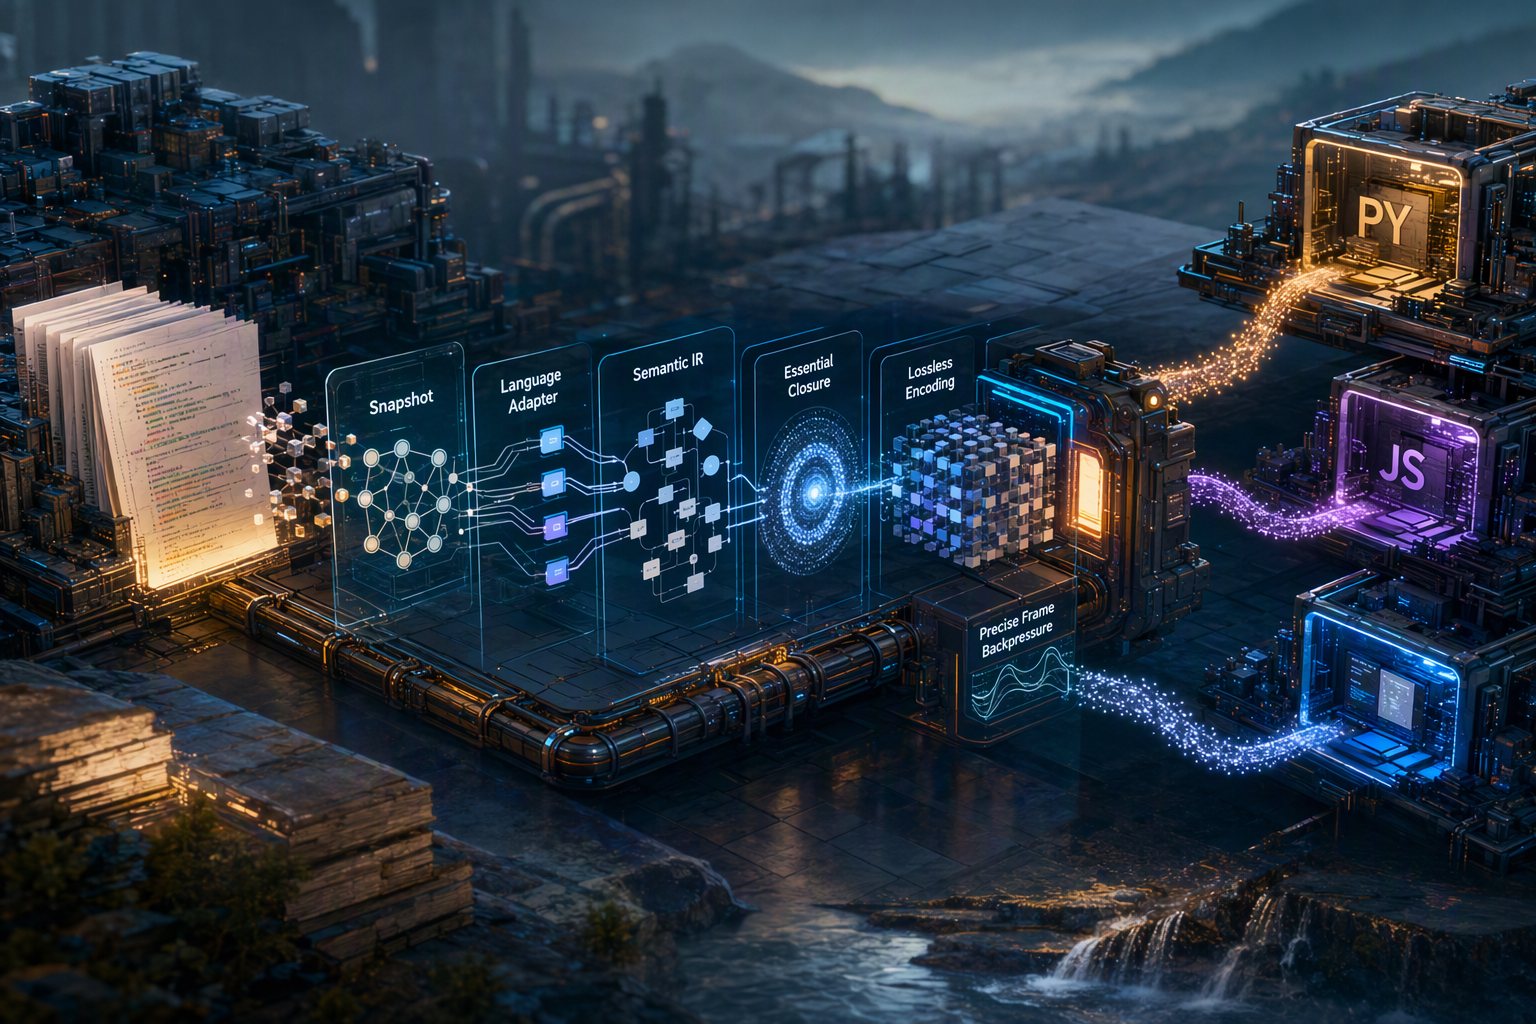
Hoe maak je bruikbare codekennis uit acht programmeertalen zonder op de doelmachine een zware compiler-toolchain te installeren? Een voorgesteld ontwerp voor TypeScript, Java, C#, Python, Rust, Go, C en C++ kiest voor een gelaagde aanpak: eerst wordt broncode alleen-lezen vastgelegd, daarna verwerkt een taaladapter de syntaxis en zet die om naar één gedeeld model. Een algemene kern bewaakt vervolgens volledigheid, codering en de maximale framelengte.
De centrale afbakening is belangrijk. Het voorstel mikt op complete, verplichte statische informatie binnen een verklaarde scope. Het belooft niet dat willekeurige codebases, ongeacht hun omvang, volledig in één klein bericht passen. Evenmin claimt het alle runtimegedragingen, dynamische aanroepen of compilersemantiek te kunnen reconstrueren.
Wat is al aangetoond — en wat niet?
In een historisch projectverslag wordt voor een specifieke FastCode-snapshot een frame van 18.869 bytes genoemd. Dat resultaat betrof vijf bestanden en een kern met 79 imports, 84 definities en 79 statische afhankelijkheidsverwijzingen. Dezelfde meting vermeldt dat 751 aanroepuitdrukkingen zijn weggelaten. Het gaat dus om een gedeeltelijke levering, niet om bewijs dat alle relevante programmasemantiek behouden bleef.
Ook staat in het verslag dat een gerichte regressieset van 40 tests slaagde. Dat is een historische registratie voor die specifieke set; het betekent niet dat de volledige testdekking uit precies 40 tests bestond. Deze cijfers zijn bovendien niet opnieuw gecontroleerd als onderdeel van het voorstel. Ze vormen een aanknopingspunt voor vervolgwerk, geen productiegarantie.
De bestaande extractie registreert onder meer namen, gekwalificeerde namen, soorten definities en basisklassen. Dat bewijst op zichzelf niet dat parameters, retourtypen, standaardwaarden, generieke beperkingen en API-contracten al volledig worden vastgelegd. Ook gebruikt een bestaande validatietest de productie-decoder: die is daarom geen volledig onafhankelijke controle van encoder én decoder.
Eén gemeenschappelijk model voor code
Het voorgestelde Universal Semantic Graph IR beschrijft vier hoofdsoorten elementen:
- Pakketten en naamruimten: logische containers, die niet automatisch hetzelfde zijn als mappen of package-manager-eenheden.
- Modules en bestanden: bronbestanden met een vastgelegde identiteit en herkomst.
- Contracten: onder meer typen, interfaces, traits, structs, enums en publieke bindings.
- Aanroepbare elementen: functies, methoden, constructors en operators.
Daarbij horen expliciete relaties, zoals afhankelijkheden, implementaties, aanroepen en overerving. Een gevonden relatie betekent alleen dat de broncode een bepaalde verwijzing of declaratie bevat. Het bewijst niet dat een compiler die accepteert, dat de code tijdens runtime wordt uitgevoerd of dat een dynamische aanroep naar een bepaald doel gaat.
Ook zichtbaarheid moet meer zijn dan een simpel vinkje voor ‘publiek’. Het model moet bijvoorbeeld onderscheid maken tussen toegangsregels, bereikbaarheid via een container, geëxporteerde naam, voorwaarden en de sterkte van het bewijs. Onzekerheid blijft zichtbaar: een onbekend doel of een voorwaardelijke export mag niet worden omgezet in een stellige conclusie.
Syntaxis begrijpen zonder een zware compiler
Als syntactische basis stelt het voorstel Tree-sitter voor. Dat is een parserbibliotheek die een concrete syntaxisboom kan maken; querypatronen kunnen vervolgens specifieke knopen in die boom herkennen. 11
16 Dat maakt Tree-sitter geschikt als bouwsteen, maar niet als vervanger voor typecontrole, macro-uitvoering, linking of een volledige compileranalyse.
De adapters zouden alleen goedgekeurde, vooraf gebouwde parsercomponenten gebruiken. Op de doelmachine zouden geen taal-SDK’s, buildsystemen of projectscripts worden gestart. Ontbreekt een geschikte parser voor het platform, dan meldt het systeem die beperking; het valt niet automatisch terug op lokale compilatie of installatie.
Voor de Tree-sitter-bindingen moet bovendien de compatibiliteit tussen de runtime en de taalgrammatica worden gecontroleerd. De documentatie beschrijft een ABI-versie voor grammatica’s; een succesvolle installatie of overeenkomstige pakketnaam is op zichzelf geen bewijs van compatibiliteit. 13
De voorgestelde adapters behandelen per taal eigen regels. TypeScript vereist bijvoorbeeld onderscheid tussen type- en waarde-imports, exports en pakket-ingangspunten. De officiële documentatie beschrijft zowel type-only imports en exports als de rol van het exports-veld voor pakkettoegang. 3
7
8 Voor Python moet een underscore niet worden aangezien voor echte toegangscontrole; voor Rust kan een
pub-declaratie afhankelijk zijn van het bereikbare modulepad. Voor C en C++ zijn onder meer declaraties, headers, voorwaarden, templates en macro’s relevant.
Die regels zijn nog geen gevalideerde implementatie. Het voorstel vraagt per adapter om een vastgelegde grammaticaversie, gecontroleerde knooptypen, positieve én negatieve tests en onafhankelijke controle van bronlocaties. Onbekende syntaxis of parserfouten moeten de volledigheidsclaim beperken.
Een kleine framegrens vraagt om een harde keuze
De algemene kern zou verplichte informatie eerst in een afhankelijkheids- en bewijsafsluiting opnemen: niet alleen een definitie, maar ook de relaties, voorwaarden, bronlocaties en ondersteunende declaraties die nodig zijn om die definitie te begrijpen. Pas daarna kan optionele informatie worden weggelaten.
Het voorstel stelt een fysieke bovengrens voor van 24.576 bytes per frame. De effectieve limiet moet de laagste zijn van die grens, de protocol- en projectlimiet en de limiet van de aanroeper. Bestaande V2-contracten houden daarnaast hun eigen grenzen; de nieuwe fysieke bovengrens is geen toestemming om bestaande quota op te rekken.
Als de verplichte kern boven de limiet uitkomt, zijn er maar een paar eerlijke opties: de aanvraag blokkeren, of na afzonderlijke toestemming de levering opdelen. Het systeem mag essentiële definities niet stilzwijgend schrappen en vervolgens toch melden dat de kern compleet is. Een paginering kan per frame onder de limiet blijven, maar betekent uiteraard niet dat de hele overdracht samen binnen één frame past.
Ook de meting moet het volledige bericht omvatten: niet alleen de interne records, maar ook JSON-RPC-omhulling, diagnostiek, escaping en afsluitende tekens. Comprimeren kan de transportgrootte verlagen, maar bewijst niet dat de informatie semantisch voldoende is of dat een model de gecomprimeerde bytes kan lezen. Transportgrootte en de uiteindelijke modelcontext moeten dus apart worden gemeten.
Acht taalbenchmarks, nog niet uitgevoerd
Als kandidaatsets noemt het voorstel onder meer Redux voor TypeScript, Spring Framework voor Java, ASP.NET Core voor C#, FastCode voor Python, ripgrep voor Rust, Gin voor Go, Redis voor C en fmt voor C++. Dit zijn voorgestelde benchmarks, geen bewijs dat de repositories al zijn vastgezet, verwerkt of door de nieuwe adapters zijn gehaald.
Voor een eerlijke vergelijking moeten per benchmark vooraf de versie, bestanden, bronhashes, selectiecriteria, verwachte declaraties, voorwaarden en toegestane onzekerheden worden vastgelegd. Alleen regels code tellen is onvoldoende: ook het aantal contracten, de hoeveelheid volledige signatures, afhankelijkheden en voorwaarden telt mee. Een dichte publieke API kan immers veel meer verplichte informatie bevatten dan een even groot bestand met veel implementatiedetails.
De voorgestelde acceptatie-eisen zijn streng: alle verplichte declaraties en afhankelijkheden uit een onafhankelijk vastgelegde verwachting moeten terugkomen; gecodeerde gegevens moeten onafhankelijk kunnen worden teruggelezen; testgevallen voor onzekere relaties mogen geen valse zekerheid opleveren; en elk geaccepteerd frame moet binnen de geldende limiet blijven. De acht benchmarks moeten afzonderlijk slagen voordat het systeem voor die benchmarkset als geschikt kan worden beschreven.
De juiste belofte
De kern van het ontwerp is niet ‘alles past altijd in 24 KB’. Het is: taalverschillen worden door adapters expliciet gemaakt, de gedeelde kern controleert verplichte informatie en de uitvoer blijft binnen een meetbare limiet. Als die combinatie niet haalbaar is, meldt het systeem dat.
Dat is een bruikbare richting voor een meertalige codekennislaag, maar nog geen bewijs van een productierijp systeem. Daarvoor zijn onder meer gevalideerde adapters voor alle acht talen, gecontroleerde parsercomponenten, onafhankelijke bronverificatie en echte benchmarkresultaten nodig. Tot die tijd is dit een voorstel met een duidelijke architectuur en een even duidelijke grens aan wat het kan beloven.
Studio Global AI
Continue your research
This page includes a source-backed answer you can continue inside Studio Global.
People also ask
What is the short answer to "Een universele codekennislaag voor acht talen: zo kan het zonder zware compilers"?
Het voorstel scheidt taalafhankelijke extractors van een gedeelde laag voor codekennis, budgetbewaking en codering.
What are the key points to validate first?
Het voorstel scheidt taalafhankelijke extractors van een gedeelde laag voor codekennis, budgetbewaking en codering. Tree sitter kan de syntactische basis vormen, maar is geen vervanging voor een compiler of volledige semantische analyse.
What should I do next in practice?
Een historische meting noemt een frame van 18.869 bytes en een regressieset van 40 tests; dat is geen bewijs dat alle programmabetekenis behouden bleef of dat de resultaten opnieuw zijn gecontroleerd.