studioglobal
Discover

AI 답변, 보고서, 코드 및 워크플로 살펴보기 - 페이지 1728
발견하다
모두답변보고서코드워크플로우갤러리트렌딩
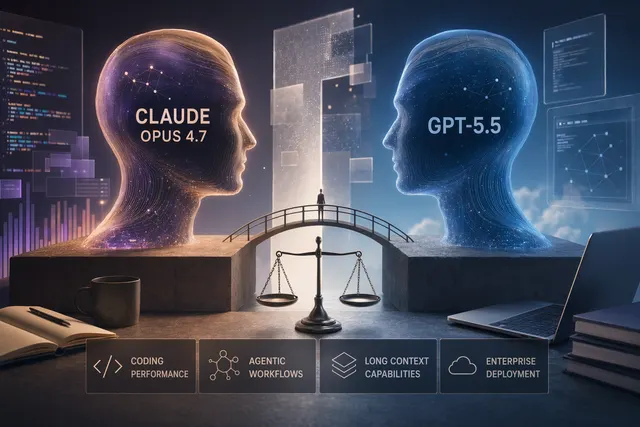
  • Claude Opus 4.7 與 GPT-5.5 在代理工作、編碼和長上下文場景中的比較示意圖

    Claude Opus 4.7 vs GPT-5.5: 긴 컨텍스트, 에이전트 코딩, 기업 배포 선택법

    7개월 전21 소스
  • 抽象比較 Claude Opus 4.7 與 GPT-5.5 在 AI 工作流中的選型差異

    Claude Opus 4.7 vs GPT-5.5: 벤치마크보다 먼저 봐야 할 선택 기준

    7개월 전11 소스
  • Split-screen editorial illustration comparing Claude Opus 4.7 and GPT-5.5 for coding, agents, research and design

    Claude Opus 4.7 vs GPT-5.5: 코딩·에이전트·리서치에 무엇을 쓸까

    7개월 전17 소스
  • Claude Opus 4.7 與 GPT-5.5 企業部署比較的抽象 AI 圖像

    Claude Opus 4.7 vs GPT-5.5: 기업 도입 전 API·비용·근거부터 보라

    7개월 전26 소스
  • Editorial illustration of Claude Opus 4.7 and GPT-5.5 Spud benchmark claims being compared on scorecards

    Claude Opus 4.7 vs GPT-5.5 Spud: 벤치마크 승자는 아직 없다

    7개월 전24 소스
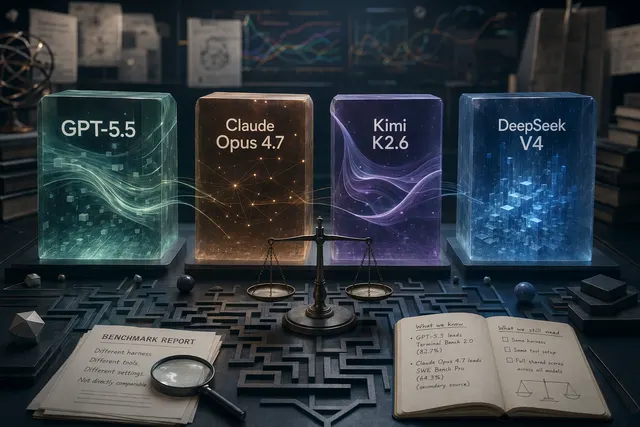
  • 四款 AI 模型的基準測試比較示意圖,包含 GPT-5.5、Claude Opus 4.7、Kimi K2.6 與 DeepSeek V4

    GPT-5.5·Claude Opus 4.7·Kimi K2.6·DeepSeek V4-Pro 비교: 벤치마크와 선택 기준

    7개월 전23 소스
  • GPT-5.5の利用可否をChatGPT、Codex、APIで確認するイメージ

    GPT-5.5 지금 쓰려면: ChatGPT·Codex·API 공식 지원 현황

    7개월 전15 소스
  • 네 개의 AI 모델 벤치마크 점수를 비교하는 추상적인 대시보드 일러스트

    GPT-5.5 vs Claude Opus 4.7 vs DeepSeek V4 vs Kimi K2.6: 벤치마크별 승자

    7개월 전24 소스
  • Ilustración editorial de benchmarks de Claude Opus 4.7 con gráficos de rendimiento y código

    Claude Opus 4.7 벤치마크: SWE-bench Verified 87.6%를 어떻게 봐야 할까

    7개월 전12 소스
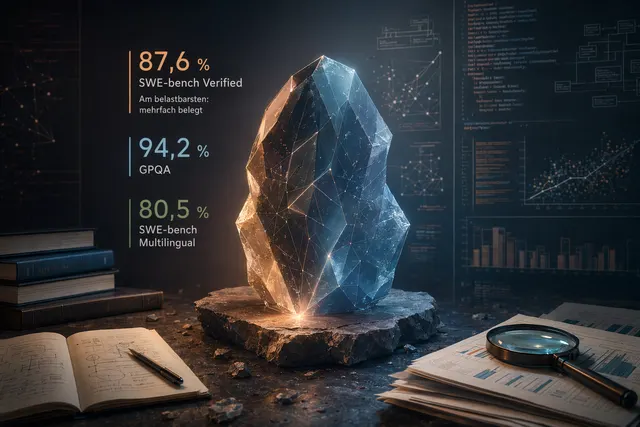
  • Abstrakte Visualisierung von Claude Opus 4.7 Benchmarks mit Diagrammen und Code-Elementen

    Claude Opus 4.7 벤치마크: SWE-bench 87.6%, GPQA 94.2%는 얼마나 믿을 만한가

    7개월 전16 소스
  • Ilustración de un panel de benchmark de IA con código y métricas para Claude Mythos Preview

    Claude Mythos Preview의 SWE-bench 93.9%, 어떻게 읽어야 할까

    7개월 전17 소스
  • Abstrakte KI-Benchmark-Grafik zu Claude Mythos Preview mit Code- und Score-Elementen

    Claude Mythos 벤치마크: SWE-bench 93.9%가 말해주는 것과 말해주지 않는 것

    7개월 전17 소스
이전다음