답변게시됨22 소스
기린 9050 Pro, 칩을 ‘접어’ 밀도를 높이다
분해 분석에 따르면 기린 9050 Pro는 약 120.65㎟ 크기의 다이 두 개를 하이브리드 본딩으로 결합했다. 한쪽은 연산 로직, 다른 쪽은 SRAM과 캐시를 주로 맡는다. 화웨이는 같은 성능을 기준으로 CPU 전력 41%, GPU 58%, NPU 66% 절감을 주장한다.
게시자GPT-6 Luna로 편집GPT Image 2로 이미지 생성
연구 답변
주요 시사점
- 분해 분석에 따르면 기린 9050 Pro는 약 120.65㎟ 크기의 다이 두 개를 하이브리드 본딩으로 결합했다. 한쪽은 연산 로직, 다른 쪽은 SRAM과 캐시를 주로 맡는다.
- 화웨이는 같은 성능을 기준으로 CPU 전력 41%, GPU 58%, NPU 66% 절감을 주장한다. 다만 이는 회사 발표 수치이며, 공개된 벤치마크 결과도 모든 항목에서 우위를 보인다는 뜻은 아니다.
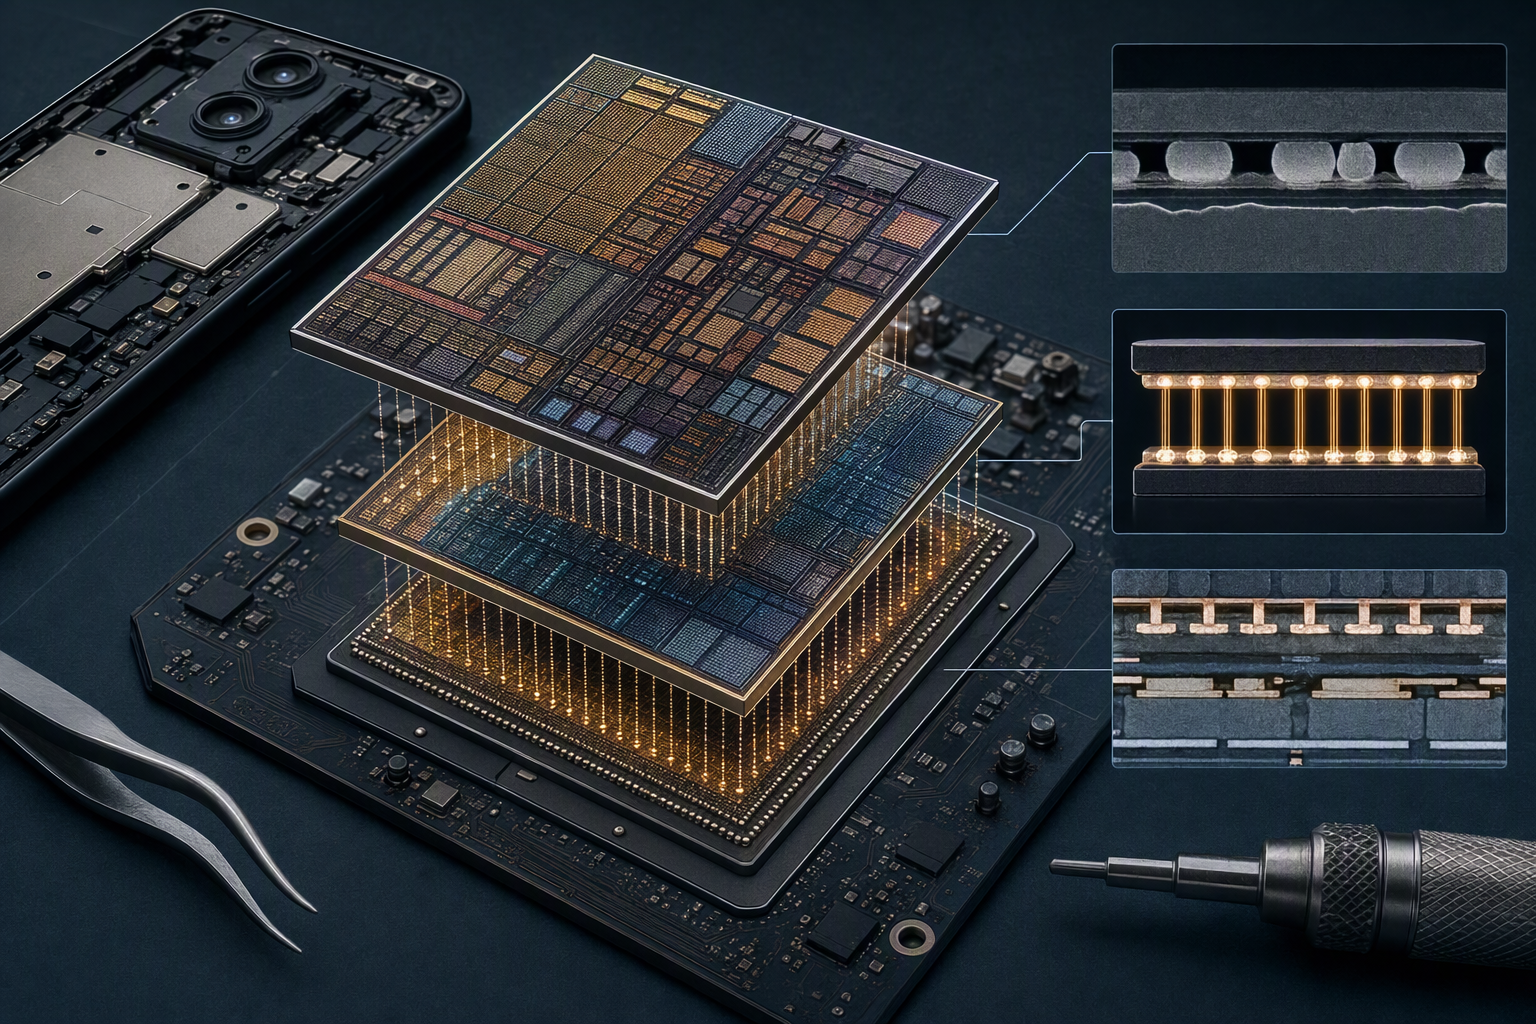
AI 프롬프트
openai.comCreate a landscape editorial hero image for this Studio Global article: What did teardowns by Geekerwan and Kurnal Insights reveal about the Kirin 9050 Pro’s two-die “LogicFolding” design—including its hybrid bon. Article summary: The teardowns depict LogicFolding as a way to gain chip-level density and efficiency by stacking two dies, rather than relying solely on smaller transistors. That is a meaningful response to restricted access to advanced. Topic tags: general, general web, user generated. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts with fa
화웨이 기린 9050 Pro의 눈에 띄는 선택은 트랜지스터를 더 작게 만드는 데만 기대지 않고, 작동하는 실리콘 다이 두 개를 위아래로 쌓았다는 점이다. Geekerwan의 분해 분석과 Kurnal Insights가 공개한 다이 사진을 보면 한 층은 연산 로직에, 다른 층은 SRAM과 캐시에 무게를 둔 구조다. 이렇게 하면 칩 전체의 유효 집적도를 높이고 일부 신호 경로를 짧게 만들 수 있다. 다만 공개된 수치만으로 이 칩이 최첨단 트랜지스터 공정을 쓴다고 결론 내릴 수는 없다.3
11
13
분해 사진에 보이는 두 개의 다이
두 다이는 크기가 비슷하며, 각각 약 11.13 × 10.84㎜, 면적으로는 **120.65㎟**로 보고됐다. 한쪽은 연산 로직을 주로 담당하고 다른 쪽에는 SRAM과 캐시가 자리한다. 후자의 다이에는 입출력(I/O)과 클록 관련 회로도 포함된다는 분석이 나왔다.11
13
15
두 층은 구리 대 구리 방식의 하이브리드 본딩으로 면을 맞대 결합한다. 보고된 본딩 간격은 약 1.5마이크로미터로, 다이 사이에 촘촘한 수직 연결을 배치할 수 있게 해준다.1
3
15
보도에는 수직 연결이 약 5,000만 개, 실리콘 관통 전극(TSV)이 약 8만 개라는 수치도 등장한다. 둘은 서로 다른 종류의 연결이므로 단순히 더하거나 같은 것으로 취급해서는 안 된다. TSV의 경로를 설명하는 방식도 보도마다 다르다. 따라서 두 수치는 각각 보고된 별도 집계로 보는 편이 타당하며, 모든 연결을 확정적으로 보여주는 하나의 배선도처럼 해석하기는 어렵다.1
3
5
15
공정 추정치와 ‘집적도 54% 향상’의 의미
분해 보도는 연산 다이에 SMIC의 N+3, SRAM 중심 다이에 N+2 공정이 적용됐을 가능성을 제시한다. 이는 분석에 근거한 추정이며, 각 층의 제조 공정이 확정적으로 확인된 것은 아니다.11
15
화웨이는 기린 9050 Pro의 유효 트랜지스터 밀도가 제곱밀리미터당 약 1억 5,500만 개에서 2억 3,800만 개로 늘었다고 밝혔다. 증가 폭은 약 **54%**다. 이 수치는 다이를 쌓아 얻은 설계 전체의 밀도 개선을 가리킨다. 각 다이의 트랜지스터가 더 작은 공정 노드 덕분에 각각 54% 더 촘촘해졌다는 뜻은 아니다.1
2
11
전력 절감 주장과 벤치마크는 따로 봐야
화웨이는 같은 성능을 낼 때 CPU 전력은 41%, GPU는 58%, NPU는 66% 줄었다고 주장한다. 이는 회사가 제시한 수치이며, 칩 분해 자체로 확인된 측정 결과는 아니다. 출시 당시 보도에서도 이 수치가 독립적으로 검증되지 않았다는 지적이 나왔다.1
2
48
벤치마크 결과도 단순히 ‘최신 플래그십과 동급’이라고 요약하기 어렵다. 번스타인 리서치 분석에 따르면 기린 9050 Pro는 긱벤치 6 멀티코어 시험 일부에서 애플의 A17 Pro보다 높은 결과를 냈지만, 비교 대상인 더 최신 A20 Pro에는 뒤처졌다. 특정 작업에서 진전이 보인다는 의미이지, 모든 칩이나 시험에서 우세하다는 뜻은 아니다.49
기린 9050 Pro는 메이트 90 상위 모델에 탑재된 것으로 보도됐다. 따라서 LogicFolding은 제안 단계의 설계에 그치지 않고 실제 제품에 적용된 방식이다.6
수출 통제 속 대안, 그러나 만능 해법은 아니다
칩을 쌓으면 기존 공정의 미세화에만 의존하지 않고 유효 집적도를 높일 수 있다. 연산 기능과 메모리 기능을 나누면 층마다 서로 다른 공정을 적용할 여지도 생기고, 일부 데이터 이동 경로를 짧게 할 수도 있다.7
11
대신 제조와 조립은 더 까다로워진다. 작동하는 다이 두 개를 각각 만든 뒤 정밀하게 맞춰 접합해야 하기 때문이다. 현재 공개된 보도만으로는 양산 수율과 비용, 발열 성능을 확정하기 어려워 실제 제품에서의 부담은 불분명하다. 무엇보다 적층 설계가 오래된 공정에서 만든 트랜지스터를 최첨단 공정의 트랜지스터와 동등하게 만들어주지는 않는다.
미국의 수출 통제라는 맥락에서 LogicFolding은 공정 미세화의 제약을 일부 보완하려는 설계로 보는 것이 적절하다. 공정 기술이 동등해졌다거나 공급망이 완전히 독립했다는 증거로 볼 수는 없다. 칩의 공급망은 여전히 공개되지 않은 상태다.1
9
Studio Global AI
연구를 계속하세요
이 페이지에는 Studio Global 내에서 계속할 수 있는 소스 기반 답변이 포함되어 있습니다.
사람들은 또한 묻습니다.
"기린 9050 Pro, 칩을 ‘접어’ 밀도를 높이다"에 대한 짧은 대답은 무엇입니까?
분해 분석에 따르면 기린 9050 Pro는 약 120.65㎟ 크기의 다이 두 개를 하이브리드 본딩으로 결합했다. 한쪽은 연산 로직, 다른 쪽은 SRAM과 캐시를 주로 맡는다.
먼저 검증할 핵심 포인트는 무엇인가요?
분해 분석에 따르면 기린 9050 Pro는 약 120.65㎟ 크기의 다이 두 개를 하이브리드 본딩으로 결합했다. 한쪽은 연산 로직, 다른 쪽은 SRAM과 캐시를 주로 맡는다. 화웨이는 같은 성능을 기준으로 CPU 전력 41%, GPU 58%, NPU 66% 절감을 주장한다. 다만 이는 회사 발표 수치이며, 공개된 벤치마크 결과도 모든 항목에서 우위를 보인다는 뜻은 아니다.
출처
vocal.mediaHuawei’s New Chip Shouldn’t Be This Efficient. The Teardown Explains Why It Is.
wccftech.comDie Shots For Huawei's Latest Kirin 9050 Pro Chip Show A Much Smaller Footprint, Encompassing A Logic Die On SMIC's N+3 Process Bonded To An SRAM Die On The N+2 Process
huaweicentral.comHuawei Kirin 9050 Pro chip's core design spotted in microscopic image