에어태그를 단 책 1,000권의 행선지… 아마존의 ‘구매·스캔·폐기’ 작업이 AI에 던진 질문
404미디어는 약 1,000권의 책이 캘리포니아에서 출발해 위스콘신과 콜로라도를 거쳐 아마존의 라스베이거스 LAS8 창고로 이동한 경로를 추적했다. 아마존은 책을 “제품 개선을 위해” 구매한다고 밝혔지만, 구매량과 스캔 시설 수, 결과물이 사용되는 제품, 해당 작업이 특정 AI 모델 학습에 쓰이는지는 공개하지 않았다.
404미디어는 약 1,000권의 책이 캘리포니아에서 출발해 위스콘신과 콜로라도를 거쳐 아마존의 라스베이거스 LAS8 창고로 이동한 경로를 추적했다.
아마존은 책을 “제품 개선을 위해” 구매한다고 밝혔지만, 구매량과 스캔 시설 수, 결과물이 사용되는 제품, 해당 작업이 특정 AI 모델 학습에 쓰이는지는 공개하지 않았다.
책 판매자들은 재판매 가치와 무관해 보이는 무작위 대량 주문이 ISBN 카탈로그를 폭넓게 확보하려는 AI 데이터 수집일 수 있다고 우려한다. 책의 텍스트가 디지털로 남더라도 희귀본의 물리적·역사적 가치는 사라질 수 있다는 지적도 나온다.
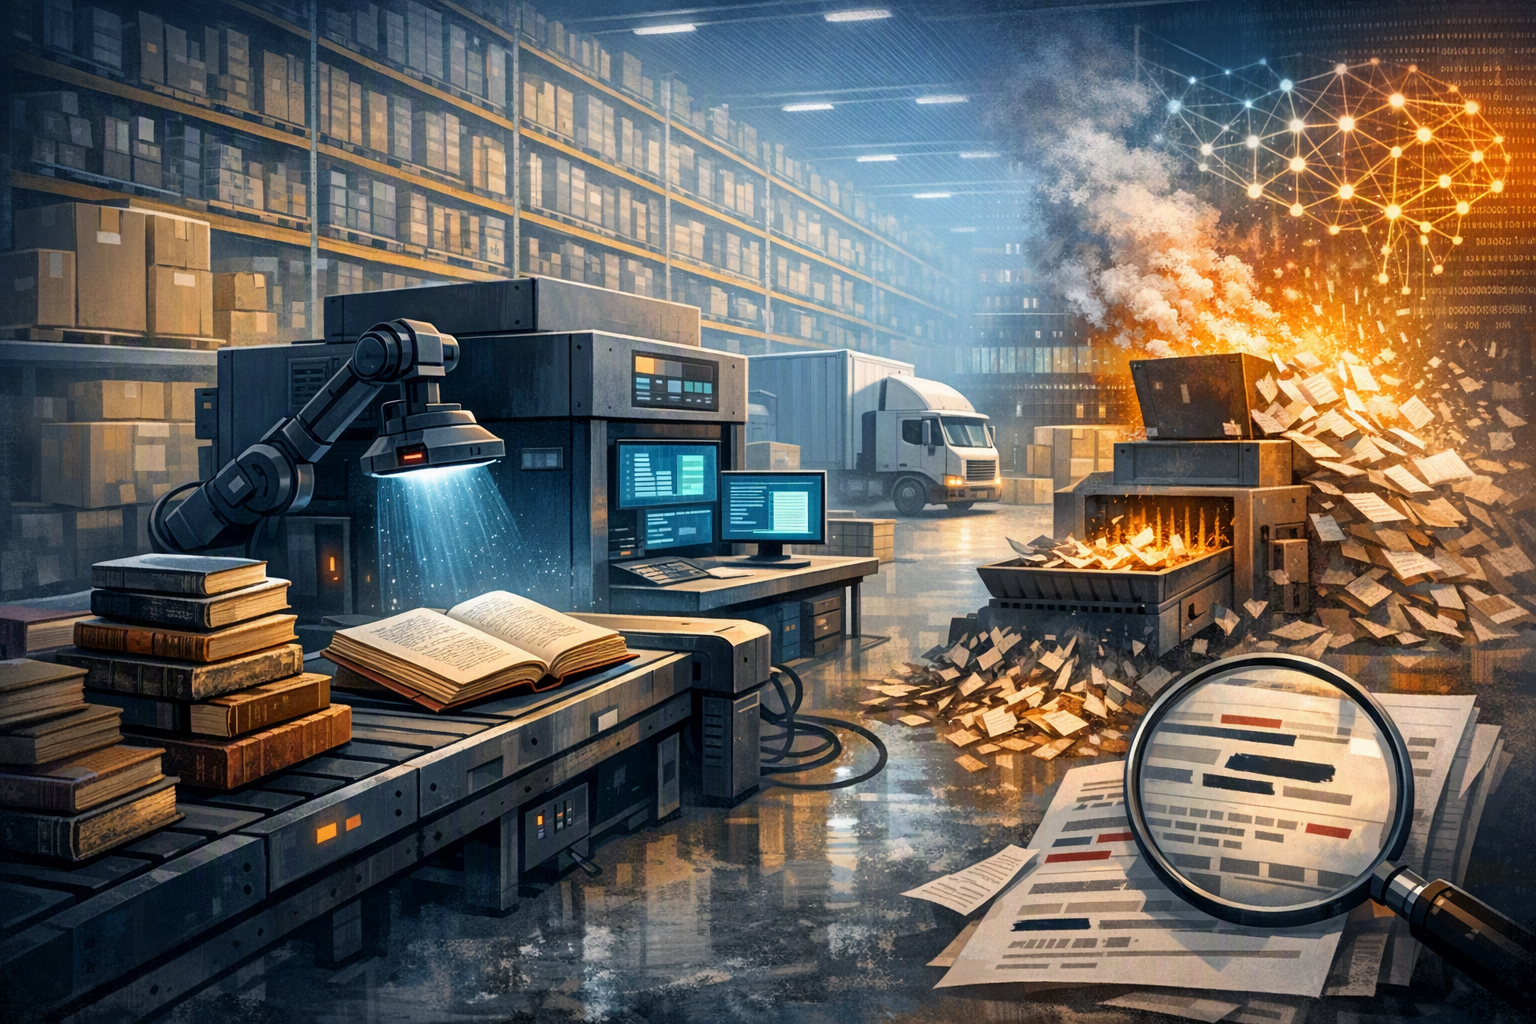
What did 404 Media’s investigation reveal about Amazon’s alleged practice of buying large quantities of rare and out-of-print books, trackinIllustration of the reported book-scanning pipeline; the image is conceptual, not evidence from the investigation.
AI 프롬프트
Create a landscape editorial hero image for this Studio Global article: What did 404 Media’s investigation reveal about Amazon’s alleged practice of buying large quantities of rare and out-of-print books, trackin. Article summary: 404 Media reported evidence of a large Amazon operation that acquires printed books, digitizes them, and destroys the physical copies—an apparent source of AI-training text. The reporting strongly links the tracked shipm. Topic tags: general, general web, user generated, news. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts w
openai.com
에어태그가 따라간 책 1,000권
404미디어의 조사는 캘리포니아 서점에서 구매된 약 1,000권의 책에 애플 에어태그를 넣으면서 시작됐다. 해당 화물은 위스콘신과 콜로라도를 거쳐 아마존의 라스베이거스 LAS8 창고에 도착했고, 이후 시설 북쪽 끝에 있는 VGT3 작업장으로 이동한 것으로 전해졌다. 404미디어는 현장에 표시된 티렉스와 책 모양의 로고, 그리고 직원 인터뷰를 통해 이곳을 책 처리 작업장으로 특정했다.
핵심은 아마존이 책을 받았다는 사실 자체가 아니다. 보도 내용과 직원들의 증언은 VGT3가 일반적인 상품 재판매나 주문 처리와는 다른 방식으로 책을 다루고 있음을 시사했다.
‘구매·스캔·폐기’로 이어진 작업
404미디어가 인용한 노동자들에 따르면 이 작업장은 인쇄된 책을 대량으로 받은 뒤 제본을 제거한다. 페이지가 고속 스캐너를 통과할 수 있도록 책등을 잘라내고, 각 페이지와 바코드를 스캔한 다음 낱장으로 남은 종이를 버리거나 재활용한다는 설명이다.
이는 종이책을 기계가 읽을 수 있는 텍스트 데이터로 바꾸는 일종의 일방향 변환이다. 중고책을 보관했다가 다시 판매하거나 고객에게 배송하는 과정과는 성격이 다르다.
Studio Global AI
연구를 계속하세요
이 페이지에는 Studio Global 내에서 계속할 수 있는 소스 기반 답변이 포함되어 있습니다.
"에어태그를 단 책 1,000권의 행선지… 아마존의 ‘구매·스캔·폐기’ 작업이 AI에 던진 질문"에 대한 짧은 대답은 무엇입니까?
404미디어는 약 1,000권의 책이 캘리포니아에서 출발해 위스콘신과 콜로라도를 거쳐 아마존의 라스베이거스 LAS8 창고로 이동한 경로를 추적했다.
먼저 검증할 핵심 포인트는 무엇인가요?
404미디어는 약 1,000권의 책이 캘리포니아에서 출발해 위스콘신과 콜로라도를 거쳐 아마존의 라스베이거스 LAS8 창고로 이동한 경로를 추적했다. 아마존은 책을 “제품 개선을 위해” 구매한다고 밝혔지만, 구매량과 스캔 시설 수, 결과물이 사용되는 제품, 해당 작업이 특정 AI 모델 학습에 쓰이는지는 공개하지 않았다.
실무에서는 다음으로 무엇을 해야 합니까?
책 판매자들은 재판매 가치와 무관해 보이는 무작위 대량 주문이 ISBN 카탈로그를 폭넓게 확보하려는 AI 데이터 수집일 수 있다고 우려한다. 책의 텍스트가 디지털로 남더라도 희귀본의 물리적·역사적 가치는 사라질 수 있다는 지적도 나온다.
다만 이번 보도가 아마존이 처리한 전체 책의 규모를 밝혀낸 것은 아니다. 또 라스베이거스 작업장에서 생성된 스캔 파일이 아마존의 어떤 AI 모델 학습에 사용됐는지도 확인하지 못했다. 따라서 현재 확인된 결론은 ‘아마존에 대규모 책 구매·디지털화 파이프라인이 존재하는 것으로 보인다’는 수준이며, 특정 모델의 학습 데이터라는 점까지 아마존이 공식 인정한 것은 아니다.
아마존의 설명과 남은 공백
아마존은 404미디어에 책을 “제품을 개선하기 위해” 구매한다고 밝혔다. 그러나 회사는 구매하는 책의 수, 책을 스캔하는 시설의 수, 스캔 결과물을 사용하는 제품, 라스베이거스 작업장이 AI 모델 학습에 직접 연결되는지에 대해서는 공개적으로 확인하지 않은 것으로 전해졌다.
이 차이는 중요하다. 이번 조사가 제시한 것은 추적된 화물, 아마존 시설 내부의 목적지, 책을 처리하는 작업장, 그리고 책을 스캔하고 폐기한다는 노동자들의 증언이다. 반면 ‘그곳에서 처리되는 모든 책이 아마존의 특정 AI 모델 학습 데이터가 된다’는 완전한 공개 시인과는 거리가 있다.
보다 정확한 표현은 이렇다. 404미디어는 AI 데이터 수집과 양립할 수 있는 아마존의 책 디지털화 작업에 관한 운영상 증거를 확보했다. 이는 아마존이 최첨단 AI 모델 개발에 투자를 확대하는 시점과 겹친다. 로이터는 별도로 아마존이 AI 전략을 새로운 프런티어 모델 개발에 집중하는 방향으로 재편하고 있다고 보도했다.
왜 책 판매자들은 ‘ISBN 단위 수집’을 의심하나
404미디어와 인터뷰한 책 판매자들은 일부 대량 주문이 통상적인 재판매 거래와 달랐다고 말했다. 주문 목록이 지나치게 뒤섞여 있고, 책의 재판매 가격·상태·주제·수익성에 거의 신경 쓰지 않는 것처럼 보였다는 것이다.
재판매 목적의 구매자는 일반적으로 잘 팔리는 책과 마진을 따진다. 반면 학습 데이터 확보가 목적이라면 특정 베스트셀러보다 다양한 제목과 ISBN을 최대한 많이 모으는 편이 유리할 수 있다.
이 때문에 판매자들은 AI 기업이나 데이터 브로커가 상업적 가치가 높은 책만 선별하는 대신, 출간된 책의 전체 목록에 가까운 범위를 훑으려는 것 아니냐고 의심한다. 404미디어는 앞서 ISBNdb가 AI 기업을 대상으로 인쇄본 책을 대량 확보하는 서비스를 홍보했다고 보도했다. 이후 ISBNdb는 관련 내용을 삭제하고 해당 웹페이지가 시장의 관심을 시험하기 위한 것이었다고 설명했다.
물론 이상한 대량 주문이 모두 아마존이나 AI와 관련됐다는 증거는 없다. 다만 소매 거래로는 이해하기 어려운 주문이 데이터셋의 범위를 넓히려는 목적이라면 설명될 수 있다는 점에서, 서점 업계가 거래의 성격을 판단하기 어려워지고 있다는 사실은 보여준다.
오래된 종이책이 AI 학습에 매력적인 이유
최근 생성형 AI가 쏟아내는 텍스트가 본격적으로 확산되기 전에 출판된 책은 사람이 직접 쓴 언어로 구성된 비교적 검증 가능한 자료다. 절판 도서나 오래된 책에는 온라인에서 찾기 어려운 지역 정보, 역사 자료, 전문 지식도 담겨 있을 수 있다.
이런 책은 폭넓은 인간 언어를 제공하면서도 합성 텍스트로만 채워질 가능성이 상대적으로 낮다. 404미디어는 ISBNdb의 설명을 인용하며 오래된 책이 ‘AI가 만든 저품질 콘텐츠로부터 자유롭다’는 점을 가치로 제시했다고 전했다.
AI 업계와 연구자들이 언급하는 ‘모델 붕괴(model collapse)’ 우려도 이 맥락과 맞닿아 있다. AI가 생성한 결과물을 다시 학습에 반복 사용하면 이후 모델의 품질이나 다양성이 떨어질 수 있다는 가설이다. 다만 이는 연구 대상이자 우려일 뿐, 아마존의 특정 모델이 모델 붕괴를 겪었다거나 라스베이거스의 책들이 바로 그 이유로 수집됐다는 증거는 아니다.
앤스로픽의 ‘프로젝트 파나마’와 법적 경계
아마존에서 보고된 작업 방식은 앤스로픽의 ‘프로젝트 파나마’와 닮았다. 앤스로픽은 실물 책을 구매한 뒤 제본을 제거하고 페이지를 스캔했으며, AI 작업에 사용할 디지털 자료를 만든 후 종이 원본을 폐기한 것으로 법원 기록과 보도를 통해 알려졌다.
윌리엄 올섭 판사는 2025년 6월 23일 Bartz v. Anthropic 사건 명령에서, 해당 사실관계에 따라 책을 클로드와 전신 모델 학습에 사용하는 행위가 “매우 변형적인” 공정 이용이라고 판단했다. 앤스로픽이 합법적으로 구매한 종이책을 내부 도서관용으로 검색 가능한 디지털 사본으로 바꾼 행위 역시 공정 이용에 해당한다고 봤다.
그러나 이 판단은 ‘책을 파괴하면 AI 학습은 언제나 합법’이라는 일반 규칙이 아니다. 책을 합법적으로 취득했는지, 어떻게 사용했는지, 사본을 보관하거나 재배포했는지 등 구체적인 사실이 중요하다. 같은 소송에서 앤스로픽이 불법 복제본으로 별도의 중앙 도서관을 만든 문제는 다르게 다뤄졌다.
따라서 아마존이 책을 합법적으로 구매했다 하더라도, 작업의 전체 규모와 스캔 데이터의 사용처, 작가·출판사와의 계약, 희귀한 실물 도서의 보존 문제는 여전히 별개의 질문으로 남는다.
저작권만으로 설명되지 않는 논란
책 판매자들의 반발은 단순히 판매 손실이나 저작권료에 대한 불만만은 아니다. 희귀본과 절판본은 텍스트를 담는 용기를 넘어 역사적·지적·문화적·감정적 가치를 지닌다.
희소한 책을 절단해 재활용하면 내용은 스캔본으로 남을 수 있지만, 그 책이라는 물리적 유물은 사라진다. 특정 조건에서 법적으로 허용될 수 있는 과정이라도 수집가, 서점, 도서관, 독자에게는 보존의 관점에서 전혀 다른 문제일 수 있다.
또 하나의 문제는 정보 비대칭이다. AI 기업은 개인 판매자가 이상한 대량 주문의 의미를 알아차리기 훨씬 전에 특정 책들의 데이터셋 가치를 파악할 수 있다. 아마존의 ‘제품 개선’이라는 설명만으로는 서점 업계가 궁금해하는 핵심—얼마나 많이 구매하는지, 무엇을 스캔하는지, 생성된 파일이 어디로 가는지—가 해소되지 않는다.
아마존의 AI 전략과 연결되는 지점
이 의혹은 아마존이 고도화된 AI 경쟁에 뛰어드는 더 큰 흐름 속에 있다. 로이터는 2026년 7월 아마존이 다수의 자체 AI 모델을 정리하고 새로운 프런티어 모델 개발에 자원을 집중하는 방향으로 전략을 바꾸고 있다고 보도했다.
AWS는 고객이 자체 데이터를 아마존이 선별한 학습 데이터와 결합해 맞춤형 프런티어 모델을 개발할 수 있도록 하는 ‘Nova Forge’도 홍보하고 있다.
이런 전략은 아마존이 고품질 텍스트를 중요하게 여길 만한 사업적 이유를 보여준다. 그러나 그것만으로 에어태그가 추적한 책들이 특정 모델 학습에 사용됐다고 입증되지는 않는다. 현재 가장 강한 근거는 해당 화물과 라스베이거스 시설에 관한 404미디어의 직접 취재 내용이다.
결국 남는 질문은 종이책 시장이 AI의 보이지 않는 데이터 공급망으로 변하고 있는가다. 이번 사례에서 책은 판매자를 떠나 아마존의 처리 시설로 이동했고, 그곳에서 스캔과 폐기가 이뤄진 것으로 보도됐다. 작업의 전체 규모와 스캔 데이터의 최종 용도는 아직 공개되지 않았다.
softic.or.jp[PDF] Case 3:24-cv-05417-WHA Document 231 Filed 06/23/25 Page 1 of 32
404media.coWe Tracked a Shipment of Rare Books. It Ended at an Amazon AI Training Facility
reuters.comAmazon winds down most flagship AI models in strategy ...
