공개 정보, 합성·더미 데이터, 실제로 익명화된 자료는 대체로 위험이 낮습니다. 반면 고객·환자·임직원·계약·금융·접속 정보는 검증되지 않은 일반 소비자용 AI 도구에 넣지 않는 편이 안전합니다. OpenAI는 프롬프트와 파일·이미지·오디오·비디오 업로드 등 사용자 콘텐츠에 개인정보가 포함될 수 있다고 설명합니다.
공개 정보, 합성·더미 데이터, 실제로 익명화된 자료는 대체로 위험이 낮습니다. 반면 고객·환자·임직원·계약·금융·접속 정보는 검증되지 않은 일반 소비자용 AI 도구에 넣지 않는 편이 안전합니다.
OpenAI는 프롬프트와 파일·이미지·오디오·비디오 업로드 등 사용자 콘텐츠에 개인정보가 포함될 수 있다고 설명합니다. ChatGPT 데이터 컨트롤은 대화가 모델 개선에 쓰일지 선택하게 해 줍니다.[5][9]
ChatGPT Business, Enterprise, Edu, Healthcare 및 API의 비즈니스 데이터는 기본적으로 모델 훈련에 사용되지 않는다고 OpenAI는 설명합니다.[7]
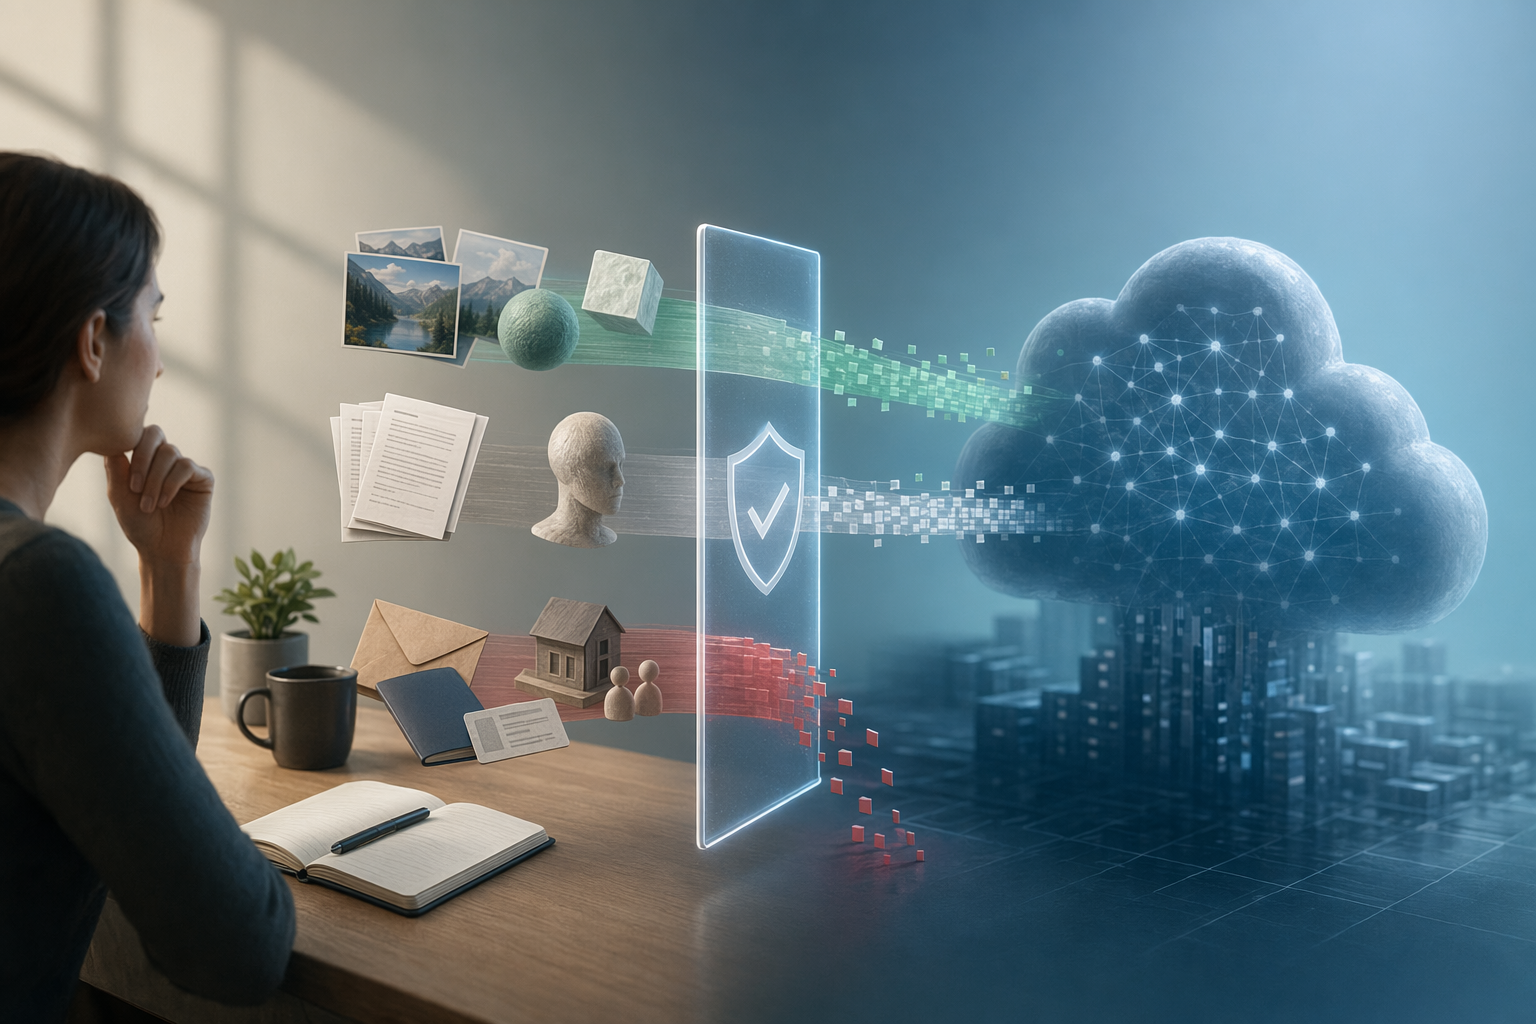
ChatGPT-Datenschutz: Welche Daten darfst du in KI-Tools eingebenKI-generiertes Symbolbild: Datenschutz-Check vor dem Upload in ChatGPT oder andere KI-Tools.
AI 프롬프트
Create a landscape editorial hero image for this Studio Global article: ChatGPT-Datenschutz: Welche Daten darfst du in KI-Tools eingeben?. Article summary: Gib in öffentliche KI Tools nur Daten ein, die du auch einem externen Cloud Dienst anvertrauen würdest: öffentliche, synthetische oder wirklich anonymisierte Inhalte.. Topic tags: chatgpt, openai, privacy, data protection, gdpr. Reference image context from search candidates: Reference image 1: visual subject "Embivalent" source context "Welche Daten darf / sollte ich bei welcher KI (nicht) eingeben?" Reference image 2: visual subject "Dominik Freinhofer" source context "Welche Daten darf / sollte ich bei welcher KI (nicht) eingeben?" Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, a
openai.com
가장 쉬운 기준은 이렇습니다. ChatGPT와 다른 AI 도구를 우선 외부 클라우드 서비스처럼 대하라는 것입니다. 인터넷에 이미 공개된 정보, 직접 만든 예시, 더미 데이터, 합성 데이터, 실제로 익명화된 자료는 비교적 다루기 쉽습니다. 반대로 사람을 식별할 수 있거나, 시스템 접속을 가능하게 하거나, 계약상 비밀이거나, 회사의 핵심 영업비밀에 해당하는 내용은 검증되지 않은 소비자용 도구에 그대로 넣지 않는 것이 원칙입니다.
중요한 질문은 단순히 ‘이 입력값이 모델 훈련에 쓰이는가’만이 아닙니다. 더 정확히는 이 도구가 이 데이터 유형을 이 목적에 맞게 처리해도 되는가입니다. OpenAI는 개인정보 처리방침에서 사용자가 서비스 입력으로 제공하는 개인정보를 수집할 수 있으며, 그 예로 프롬프트와 파일·이미지·오디오·비디오 등 업로드 콘텐츠를 듭니다. 그래서 설정 하나만 보고 안심하기보다, 계정 종류, 저장 기간, 접근 권한, 계약 조건, 사내 승인 여부를 함께 봐야 합니다.
AI 도구 입력 전 ‘데이터 신호등’
구분
예시
권장 판단
초록
공개된 정보, 일반적인 질문, 직접 만든 예시, 더미 데이터, 합성 데이터, 실제로 익명화된 일부 자료
개인정보·기밀정보·보호대상 정보가 섞여 있지 않다면 대체로 사용 가능성이 높습니다.
노랑
비밀이 없는 내부 문서 초안, 익명화한 고객지원 사례, 비밀값이 없는 코드 일부, 이름·ID·연락처를 제거한 표
데이터 최소화가 필요합니다. 조직에서 승인한 도구인지, 훈련 사용 여부와 저장 기간, 접근 권한 설정을 확인한 뒤 사용해야 합니다.
빨강
비밀번호, API 키, 토큰, 로그인 정보, 신분증·계좌·세금 정보, 건강·환자 정보, 전체 고객·임직원 데이터, 비밀 계약서, 인수합병 자료, 미공개 재무 수치, 비밀값이나 핵심 지식재산이 포함된 소스코드
검증되지 않은 소비자용 AI 도구에 붙여 넣지 마세요. 꼭 처리해야 한다면 승인된 Business·Enterprise·API 환경에서 내부 검토를 거친 뒤 최소한의 데이터만 사용해야 합니다.
이 신호등은 법률 자문이 아니라 실무용 안전 필터입니다. 어떤 내용이 고객, 임직원, 환자, 계약 상대방, 내부 시스템을 더 쉽게 특정하게 만든다면 판단은 더 보수적으로 해야 합니다. 이름만 지웠다고 곧바로 안전해지는 것도 아닙니다. 여러 정보가 결합돼 특정인을 다시 알아볼 수 있다면 여전히 위험할 수 있습니다.
소비자용 ChatGPT에서 특히 조심해야 하는 이유
ChatGPT 대화창은 내 컴퓨터 안의 메모장이 아닙니다. OpenAI는 사용자 콘텐츠에 개인정보가 포함될 수 있다고 설명하며, 프롬프트와 업로드 콘텐츠를 명시적으로 언급합니다.
Studio Global AI
연구를 계속하세요
이 페이지에는 Studio Global 내에서 계속할 수 있는 소스 기반 답변이 포함되어 있습니다.
"ChatGPT에 입력해도 되는 데이터와 안 되는 데이터"에 대한 짧은 대답은 무엇입니까?
공개 정보, 합성·더미 데이터, 실제로 익명화된 자료는 대체로 위험이 낮습니다. 반면 고객·환자·임직원·계약·금융·접속 정보는 검증되지 않은 일반 소비자용 AI 도구에 넣지 않는 편이 안전합니다.
먼저 검증할 핵심 포인트는 무엇인가요?
공개 정보, 합성·더미 데이터, 실제로 익명화된 자료는 대체로 위험이 낮습니다. 반면 고객·환자·임직원·계약·금융·접속 정보는 검증되지 않은 일반 소비자용 AI 도구에 넣지 않는 편이 안전합니다. OpenAI는 프롬프트와 파일·이미지·오디오·비디오 업로드 등 사용자 콘텐츠에 개인정보가 포함될 수 있다고 설명합니다. ChatGPT 데이터 컨트롤은 대화가 모델 개선에 쓰일지 선택하게 해 줍니다.[5][9]
실무에서는 다음으로 무엇을 해야 합니까?
ChatGPT Business, Enterprise, Edu, Healthcare 및 API의 비즈니스 데이터는 기본적으로 모델 훈련에 사용되지 않는다고 OpenAI는 설명합니다.[7]
공개 정보, 합성·더미 데이터, 실제로 익명화된 자료는 대체로 위험이 낮습니다. 반면 고객·환자·임직원·계약·금융·접속 정보는 검증되지 않은 일반 소비자용 AI 도구에 넣지 않는 편이 안전합니다. OpenAI는 프롬프트와 파일·이미지·오디오·비디오 업로드 등 사용자 콘텐츠에 개인정보가 포함될 수 있다고 설명합니다.
공개 정보, 합성·더미 데이터, 실제로 익명화된 자료는 대체로 위험이 낮습니다. 반면 고객·환자·임직원·계약·금융·접속 정보는 검증되지 않은 일반 소비자용 AI 도구에 넣지 않는 편이 안전합니다.
OpenAI는 프롬프트와 파일·이미지·오디오·비디오 업로드 등 사용자 콘텐츠에 개인정보가 포함될 수 있다고 설명합니다. ChatGPT 데이터 컨트롤은 대화가 모델 개선에 쓰일지 선택하게 해 줍니다.[5][9]
ChatGPT Business, Enterprise, Edu, Healthcare 및 API의 비즈니스 데이터는 기본적으로 모델 훈련에 사용되지 않는다고 OpenAI는 설명합니다.[7]
ChatGPT-Datenschutz: Welche Daten darfst du in KI-Tools eingebenKI-generiertes Symbolbild: Datenschutz-Check vor dem Upload in ChatGPT oder andere KI-Tools.
AI 프롬프트
Create a landscape editorial hero image for this Studio Global article: ChatGPT-Datenschutz: Welche Daten darfst du in KI-Tools eingeben?. Article summary: Gib in öffentliche KI Tools nur Daten ein, die du auch einem externen Cloud Dienst anvertrauen würdest: öffentliche, synthetische oder wirklich anonymisierte Inhalte.. Topic tags: chatgpt, openai, privacy, data protection, gdpr. Reference image context from search candidates: Reference image 1: visual subject "Embivalent" source context "Welche Daten darf / sollte ich bei welcher KI (nicht) eingeben?" Reference image 2: visual subject "Dominik Freinhofer" source context "Welche Daten darf / sollte ich bei welcher KI (nicht) eingeben?" Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, a
openai.com
가장 쉬운 기준은 이렇습니다. ChatGPT와 다른 AI 도구를 우선 외부 클라우드 서비스처럼 대하라는 것입니다. 인터넷에 이미 공개된 정보, 직접 만든 예시, 더미 데이터, 합성 데이터, 실제로 익명화된 자료는 비교적 다루기 쉽습니다. 반대로 사람을 식별할 수 있거나, 시스템 접속을 가능하게 하거나, 계약상 비밀이거나, 회사의 핵심 영업비밀에 해당하는 내용은 검증되지 않은 소비자용 도구에 그대로 넣지 않는 것이 원칙입니다.
중요한 질문은 단순히 ‘이 입력값이 모델 훈련에 쓰이는가’만이 아닙니다. 더 정확히는 이 도구가 이 데이터 유형을 이 목적에 맞게 처리해도 되는가입니다. OpenAI는 개인정보 처리방침에서 사용자가 서비스 입력으로 제공하는 개인정보를 수집할 수 있으며, 그 예로 프롬프트와 파일·이미지·오디오·비디오 등 업로드 콘텐츠를 듭니다. 그래서 설정 하나만 보고 안심하기보다, 계정 종류, 저장 기간, 접근 권한, 계약 조건, 사내 승인 여부를 함께 봐야 합니다.
AI 도구 입력 전 ‘데이터 신호등’
구분
예시
권장 판단
초록
공개된 정보, 일반적인 질문, 직접 만든 예시, 더미 데이터, 합성 데이터, 실제로 익명화된 일부 자료
개인정보·기밀정보·보호대상 정보가 섞여 있지 않다면 대체로 사용 가능성이 높습니다.
노랑
비밀이 없는 내부 문서 초안, 익명화한 고객지원 사례, 비밀값이 없는 코드 일부, 이름·ID·연락처를 제거한 표
데이터 최소화가 필요합니다. 조직에서 승인한 도구인지, 훈련 사용 여부와 저장 기간, 접근 권한 설정을 확인한 뒤 사용해야 합니다.
빨강
비밀번호, API 키, 토큰, 로그인 정보, 신분증·계좌·세금 정보, 건강·환자 정보, 전체 고객·임직원 데이터, 비밀 계약서, 인수합병 자료, 미공개 재무 수치, 비밀값이나 핵심 지식재산이 포함된 소스코드
검증되지 않은 소비자용 AI 도구에 붙여 넣지 마세요. 꼭 처리해야 한다면 승인된 Business·Enterprise·API 환경에서 내부 검토를 거친 뒤 최소한의 데이터만 사용해야 합니다.
이 신호등은 법률 자문이 아니라 실무용 안전 필터입니다. 어떤 내용이 고객, 임직원, 환자, 계약 상대방, 내부 시스템을 더 쉽게 특정하게 만든다면 판단은 더 보수적으로 해야 합니다. 이름만 지웠다고 곧바로 안전해지는 것도 아닙니다. 여러 정보가 결합돼 특정인을 다시 알아볼 수 있다면 여전히 위험할 수 있습니다.
소비자용 ChatGPT에서 특히 조심해야 하는 이유
ChatGPT 대화창은 내 컴퓨터 안의 메모장이 아닙니다. OpenAI는 사용자 콘텐츠에 개인정보가 포함될 수 있다고 설명하며, 프롬프트와 업로드 콘텐츠를 명시적으로 언급합니다.
Studio Global AI
연구를 계속하세요
이 페이지에는 Studio Global 내에서 계속할 수 있는 소스 기반 답변이 포함되어 있습니다.
"ChatGPT에 입력해도 되는 데이터와 안 되는 데이터"에 대한 짧은 대답은 무엇입니까?
공개 정보, 합성·더미 데이터, 실제로 익명화된 자료는 대체로 위험이 낮습니다. 반면 고객·환자·임직원·계약·금융·접속 정보는 검증되지 않은 일반 소비자용 AI 도구에 넣지 않는 편이 안전합니다.
먼저 검증할 핵심 포인트는 무엇인가요?
공개 정보, 합성·더미 데이터, 실제로 익명화된 자료는 대체로 위험이 낮습니다. 반면 고객·환자·임직원·계약·금융·접속 정보는 검증되지 않은 일반 소비자용 AI 도구에 넣지 않는 편이 안전합니다. OpenAI는 프롬프트와 파일·이미지·오디오·비디오 업로드 등 사용자 콘텐츠에 개인정보가 포함될 수 있다고 설명합니다. ChatGPT 데이터 컨트롤은 대화가 모델 개선에 쓰일지 선택하게 해 줍니다.[5][9]
실무에서는 다음으로 무엇을 해야 합니까?
ChatGPT Business, Enterprise, Edu, Healthcare 및 API의 비즈니스 데이터는 기본적으로 모델 훈련에 사용되지 않는다고 OpenAI는 설명합니다.[7]
ChatGPT의 데이터 컨트롤은 사용자가 자신의 대화와 상호작용이 모델 개선에 기여할지 선택할 수 있게 해 주는 기능입니다. 이 설정을 끄는 것은 중요한 보호 조치가 될 수 있습니다. 다만 그것만으로 민감한 자료를 입력해도 된다는 뜻은 아닙니다. 모델 개선 사용 여부는 개인정보·계약·보안·컴플라이언스 문제 중 일부일 뿐입니다.
임시 채팅, 즉 Temporary Chat도 만능 안전장치는 아닙니다. OpenAI는 임시 채팅이 대화 기록에 저장되지 않고, 메모리에 사용되지 않으며, 훈련에 사용되지 않고, 30일 뒤 삭제된다고 설명합니다. 다만 악용 감시를 위해 검토될 수 있다고도 설명합니다. 따라서 비밀 계약서, 실제 고객 데이터, 의료 정보 같은 자료를 넣어도 된다는 ‘허가증’으로 받아들여서는 안 됩니다.
Business·Enterprise·Edu·Healthcare·API는 무엇이 다른가
OpenAI는 소비자용 사용과 비즈니스용 제품을 구분합니다. OpenAI가 말하는 비즈니스 데이터에는 ChatGPT Business, ChatGPT Enterprise, ChatGPT for Healthcare, ChatGPT Edu, ChatGPT for Teachers, API Platform의 입력값과 출력값이 포함됩니다.
이 비즈니스 데이터에 대해 OpenAI는 기본적으로 모델 훈련에 사용하지 않는다고 설명합니다. 또한 ChatGPT Business, ChatGPT Enterprise, API 사용 고객에게는 GDPR 등 개인정보보호 요구사항을 지원하기 위한 DPA, 즉 데이터 처리 부속계약을 체결할 수 있다고 설명하며, ChatGPT Edu와 ChatGPT for Teachers에는 Student Data Privacy Agreement를 언급합니다. OpenAI는 Enterprise, Business, Edu, ChatGPT for Healthcare, API에 대한 비즈니스 데이터 개인정보보호, 보안, 컴플라이언스, 데이터 보존 정책 정보도 별도로 제공합니다.
그렇다고 Business나 Enterprise 이름이 붙은 제품이면 모든 데이터를 마음대로 넣어도 된다는 뜻은 아닙니다. 조직은 여전히 처리 목적, 데이터 유형, 접근 권한, 보존 기간, 내부 보안 정책, 고객과의 계약, 적용되는 규제 요건을 확인해야 합니다.
업로드 전 최소 체크리스트
실제 데이터를 AI 도구에 입력하거나 파일로 올리기 전에는 적어도 다음 질문에 답할 수 있어야 합니다.
이 도구가 우리 조직의 개인정보·법무·IT 보안 검토를 통과했는가?
제공업체가 프롬프트, 파일, 출력값을 모델 훈련이나 서비스 개선에 사용하는가?
훈련 사용을 끄는 설정이 있는가, 또는 계약으로 훈련 사용이 배제되는가?
입력값, 업로드 파일, 출력값은 얼마나 오래 저장되는가?
지원, 보안, 악용 감시 등의 이유로 제공업체의 사람이 내용을 검토할 수 있는가?
외부 앱, 커넥터, 플러그인, 하위 처리업체가 데이터에 접근할 수 있는가?
DPA, 관리자 제어, 역할 기반 권한, 감사 가능성, 보존 정책이 마련돼 있는가?
내부 규정과 외부 계약이 바로 이 데이터를 바로 이 도구에서 처리하는 것을 허용하는가?
이 질문들에 명확히 답할 수 없다면 실제 데이터를 넣지 않는 편이 안전합니다. 먼저 플레이스홀더, 익명화한 일부 자료, 합성 데이터로 작업하세요.
좋은 프롬프트 습관: 통째로 복사하지 말고 최소화하기
가장 안전한 프롬프트는 작업에 꼭 필요한 정보만 담은 프롬프트입니다. 답변에 필요 없는 이름, 이메일 주소, 전화번호, 주소, 고객번호, 환자번호, 계약번호, 내부 ID는 제거하거나 바꾸세요.
고객 사례: 전체 상담 기록을 이름, 고객번호, 연락처와 함께 붙여 넣지 마세요. 대신 [고객명], [고객번호], [날짜]처럼 대체 표시를 쓰고, 필요한 문장만 남깁니다.
표와 데이터셋: 전체 고객 명단이나 임직원 목록을 업로드하지 마세요. 직접 식별자를 제거하고, 분석에 필요한 열만 남기세요. 가능하다면 실제 데이터 대신 합성 데이터로 먼저 검증합니다.
코드: API 키, 토큰, 비밀번호, 개인 인증서, 운영환경 접속 정보는 프롬프트에 넣지 마세요. 문제 재현에 필요한 코드 일부만 공유하고 설정값은 [API_KEY], [TOKEN]처럼 바꾸는 편이 안전합니다.
계약서와 재무자료: 조항 표현을 다듬거나 구조를 검토하려는 목적이라면 문서 전체를 올리지 말고 익명화한 일부 조항만 사용하세요. 미공개 재무 수치나 협상 조건이 포함돼 있다면 승인된 환경인지 먼저 확인해야 합니다.
그래도 실제 데이터를 써야 한다면
더미 데이터로 충분하지 않은 상황도 있습니다. 그럴 때는 다음 순서가 안전합니다.
목적을 확인한다: 모델이 정말 실제 데이터를 필요로 하는지, 익명화한 일부 자료로 충분한지 먼저 따집니다.
데이터를 줄인다: 가능한 한 가장 작은 범위의 데이터만 사용합니다.
식별자를 제거한다: 사람, 고객, 환자, 조직을 특정할 수 있는 정보를 최대한 줄입니다.
비밀값을 삭제한다: 비밀번호, 토큰, API 키, 개인 인증서는 프롬프트에 넣지 않습니다.
승인된 환경을 고른다: 기업 데이터는 검토된 Business, Enterprise, API 구성을 사용하는 것이 바람직합니다. OpenAI는 이들 제품군의 비즈니스 데이터에 대해 기본적으로 훈련에 사용하지 않는다고 설명합니다.
설정과 계약을 확인한다: 훈련 사용 여부, 저장 기간, 역할 권한, DPA, 보존 정책을 사전에 확인합니다.
사용 이력을 남긴다: 어떤 도구에서 어떤 목적으로 어떤 데이터 유형을 어떤 설정으로 처리했는지 추적 가능하게 기록합니다.
결론: 애매하면 넣지 말고, 먼저 줄이고 바꿔라
ChatGPT 사용을 무조건 피해야 한다거나, 반대로 아무 데이터나 넣어도 된다는 식의 답은 현실적이지 않습니다. 다만 소비자용 환경에서는 프롬프트와 업로드가 개인정보를 포함할 수 있고, OpenAI는 이를 사용자 콘텐츠로 수집할 수 있다고 설명합니다.
데이터 컨트롤과 임시 채팅은 모델 개선, 대화 기록, 메모리 사용 여부에 영향을 줍니다. 임시 채팅은 OpenAI 설명상 30일 뒤 삭제되지만, 악용 감시를 위해 검토될 수 있습니다. Business, Enterprise, Edu, Healthcare, API 환경에는 별도 규칙이 있으며, OpenAI는 비즈니스 데이터가 기본적으로 훈련에 사용되지 않는다고 설명합니다.
따라서 실무 기준은 간단합니다. 확신이 없으면 붙여 넣지 마세요. 먼저 익명화하고, 플레이스홀더로 바꾸고, 필요한 부분만 남기세요. 실제 민감 데이터 처리가 필요하다면 개인용 계정이 아니라 승인된 Business·Enterprise·API 환경과 내부 절차를 거치는 것이 안전합니다.
captaincompliance.comChatGPT Data Security & Privacy: The Complete Guide for Users and Enterprises - Captain Compliance
ChatGPT의 데이터 컨트롤은 사용자가 자신의 대화와 상호작용이 모델 개선에 기여할지 선택할 수 있게 해 주는 기능입니다. 이 설정을 끄는 것은 중요한 보호 조치가 될 수 있습니다. 다만 그것만으로 민감한 자료를 입력해도 된다는 뜻은 아닙니다. 모델 개선 사용 여부는 개인정보·계약·보안·컴플라이언스 문제 중 일부일 뿐입니다.
임시 채팅, 즉 Temporary Chat도 만능 안전장치는 아닙니다. OpenAI는 임시 채팅이 대화 기록에 저장되지 않고, 메모리에 사용되지 않으며, 훈련에 사용되지 않고, 30일 뒤 삭제된다고 설명합니다. 다만 악용 감시를 위해 검토될 수 있다고도 설명합니다. 따라서 비밀 계약서, 실제 고객 데이터, 의료 정보 같은 자료를 넣어도 된다는 ‘허가증’으로 받아들여서는 안 됩니다.
Business·Enterprise·Edu·Healthcare·API는 무엇이 다른가
OpenAI는 소비자용 사용과 비즈니스용 제품을 구분합니다. OpenAI가 말하는 비즈니스 데이터에는 ChatGPT Business, ChatGPT Enterprise, ChatGPT for Healthcare, ChatGPT Edu, ChatGPT for Teachers, API Platform의 입력값과 출력값이 포함됩니다.
이 비즈니스 데이터에 대해 OpenAI는 기본적으로 모델 훈련에 사용하지 않는다고 설명합니다. 또한 ChatGPT Business, ChatGPT Enterprise, API 사용 고객에게는 GDPR 등 개인정보보호 요구사항을 지원하기 위한 DPA, 즉 데이터 처리 부속계약을 체결할 수 있다고 설명하며, ChatGPT Edu와 ChatGPT for Teachers에는 Student Data Privacy Agreement를 언급합니다. OpenAI는 Enterprise, Business, Edu, ChatGPT for Healthcare, API에 대한 비즈니스 데이터 개인정보보호, 보안, 컴플라이언스, 데이터 보존 정책 정보도 별도로 제공합니다.
그렇다고 Business나 Enterprise 이름이 붙은 제품이면 모든 데이터를 마음대로 넣어도 된다는 뜻은 아닙니다. 조직은 여전히 처리 목적, 데이터 유형, 접근 권한, 보존 기간, 내부 보안 정책, 고객과의 계약, 적용되는 규제 요건을 확인해야 합니다.
업로드 전 최소 체크리스트
실제 데이터를 AI 도구에 입력하거나 파일로 올리기 전에는 적어도 다음 질문에 답할 수 있어야 합니다.
이 도구가 우리 조직의 개인정보·법무·IT 보안 검토를 통과했는가?
제공업체가 프롬프트, 파일, 출력값을 모델 훈련이나 서비스 개선에 사용하는가?
훈련 사용을 끄는 설정이 있는가, 또는 계약으로 훈련 사용이 배제되는가?
입력값, 업로드 파일, 출력값은 얼마나 오래 저장되는가?
지원, 보안, 악용 감시 등의 이유로 제공업체의 사람이 내용을 검토할 수 있는가?
외부 앱, 커넥터, 플러그인, 하위 처리업체가 데이터에 접근할 수 있는가?
DPA, 관리자 제어, 역할 기반 권한, 감사 가능성, 보존 정책이 마련돼 있는가?
내부 규정과 외부 계약이 바로 이 데이터를 바로 이 도구에서 처리하는 것을 허용하는가?
이 질문들에 명확히 답할 수 없다면 실제 데이터를 넣지 않는 편이 안전합니다. 먼저 플레이스홀더, 익명화한 일부 자료, 합성 데이터로 작업하세요.
좋은 프롬프트 습관: 통째로 복사하지 말고 최소화하기
가장 안전한 프롬프트는 작업에 꼭 필요한 정보만 담은 프롬프트입니다. 답변에 필요 없는 이름, 이메일 주소, 전화번호, 주소, 고객번호, 환자번호, 계약번호, 내부 ID는 제거하거나 바꾸세요.
고객 사례: 전체 상담 기록을 이름, 고객번호, 연락처와 함께 붙여 넣지 마세요. 대신 [고객명], [고객번호], [날짜]처럼 대체 표시를 쓰고, 필요한 문장만 남깁니다.
표와 데이터셋: 전체 고객 명단이나 임직원 목록을 업로드하지 마세요. 직접 식별자를 제거하고, 분석에 필요한 열만 남기세요. 가능하다면 실제 데이터 대신 합성 데이터로 먼저 검증합니다.
코드: API 키, 토큰, 비밀번호, 개인 인증서, 운영환경 접속 정보는 프롬프트에 넣지 마세요. 문제 재현에 필요한 코드 일부만 공유하고 설정값은 [API_KEY], [TOKEN]처럼 바꾸는 편이 안전합니다.
계약서와 재무자료: 조항 표현을 다듬거나 구조를 검토하려는 목적이라면 문서 전체를 올리지 말고 익명화한 일부 조항만 사용하세요. 미공개 재무 수치나 협상 조건이 포함돼 있다면 승인된 환경인지 먼저 확인해야 합니다.
그래도 실제 데이터를 써야 한다면
더미 데이터로 충분하지 않은 상황도 있습니다. 그럴 때는 다음 순서가 안전합니다.
목적을 확인한다: 모델이 정말 실제 데이터를 필요로 하는지, 익명화한 일부 자료로 충분한지 먼저 따집니다.
데이터를 줄인다: 가능한 한 가장 작은 범위의 데이터만 사용합니다.
식별자를 제거한다: 사람, 고객, 환자, 조직을 특정할 수 있는 정보를 최대한 줄입니다.
비밀값을 삭제한다: 비밀번호, 토큰, API 키, 개인 인증서는 프롬프트에 넣지 않습니다.
승인된 환경을 고른다: 기업 데이터는 검토된 Business, Enterprise, API 구성을 사용하는 것이 바람직합니다. OpenAI는 이들 제품군의 비즈니스 데이터에 대해 기본적으로 훈련에 사용하지 않는다고 설명합니다.
설정과 계약을 확인한다: 훈련 사용 여부, 저장 기간, 역할 권한, DPA, 보존 정책을 사전에 확인합니다.
사용 이력을 남긴다: 어떤 도구에서 어떤 목적으로 어떤 데이터 유형을 어떤 설정으로 처리했는지 추적 가능하게 기록합니다.
결론: 애매하면 넣지 말고, 먼저 줄이고 바꿔라
ChatGPT 사용을 무조건 피해야 한다거나, 반대로 아무 데이터나 넣어도 된다는 식의 답은 현실적이지 않습니다. 다만 소비자용 환경에서는 프롬프트와 업로드가 개인정보를 포함할 수 있고, OpenAI는 이를 사용자 콘텐츠로 수집할 수 있다고 설명합니다.
데이터 컨트롤과 임시 채팅은 모델 개선, 대화 기록, 메모리 사용 여부에 영향을 줍니다. 임시 채팅은 OpenAI 설명상 30일 뒤 삭제되지만, 악용 감시를 위해 검토될 수 있습니다. Business, Enterprise, Edu, Healthcare, API 환경에는 별도 규칙이 있으며, OpenAI는 비즈니스 데이터가 기본적으로 훈련에 사용되지 않는다고 설명합니다.
따라서 실무 기준은 간단합니다. 확신이 없으면 붙여 넣지 마세요. 먼저 익명화하고, 플레이스홀더로 바꾸고, 필요한 부분만 남기세요. 실제 민감 데이터 처리가 필요하다면 개인용 계정이 아니라 승인된 Business·Enterprise·API 환경과 내부 절차를 거치는 것이 안전합니다.
captaincompliance.comChatGPT Data Security & Privacy: The Complete Guide for Users and Enterprises - Captain Compliance