답변게시됨17 소스
퀄컴 Adreno Neural Fusion: AI 업스케일링과 프레임 생성을 GPU 안에서 처리하는 방식
차세대 Adreno GPU는 3개 슬라이스 각각에 전용 AI 연산 블록인 Adreno Matrix Core를 넣어, AI 초해상도와 프레임 생성을 그래픽 파이프라인 내부에서 실행하도록 설계됐다. GPU 인접 저지연 메모리인 18MB Adreno HPM은 타일 렌더링 데이터와 프레임 버퍼 등을 가까이 보관해 시스템 메모리 왕복을 줄이는 역할을 한다.
게시자GPT-5.6 Terra로 편집GPT Image 2로 이미지 생성
연구 답변
주요 시사점
- 차세대 Adreno GPU는 3개 슬라이스 각각에 전용 AI 연산 블록인 Adreno Matrix Core를 넣어, AI 초해상도와 프레임 생성을 그래픽 파이프라인 내부에서 실행하도록 설계됐다.
- GPU 인접 저지연 메모리인 18MB Adreno HPM은 타일 렌더링 데이터와 프레임 버퍼 등을 가까이 보관해 시스템 메모리 왕복을 줄이는 역할을 한다.
- 퀄컴은 Unity와 Unreal Engine 지원을 발표했으며, 이번 GPU 공개는 5GHz Oryon CPU 및 동적 공유 캐시 구조인 FlexCache 발표과 함께 차세대 스냅드래곤 전략의 일부를 이룬다.
AI 프롬프트
openai.comCreate a landscape editorial hero image for this Studio Global article: How does Qualcomm’s next-generation flagship Snapdragon Adreno GPU integrate three dedicated Matrix Cores and Adreno Neural Fusion directly. Article summary: Qualcomm is moving AI graphics from a separate NPU round trip into the GPU itself: each of the new Adreno GPU’s three rendering slices contains a dedicated Matrix Core, and Neural Fusion coordinates those cores with rend. Topic tags: general, general web, documentation. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts with fake
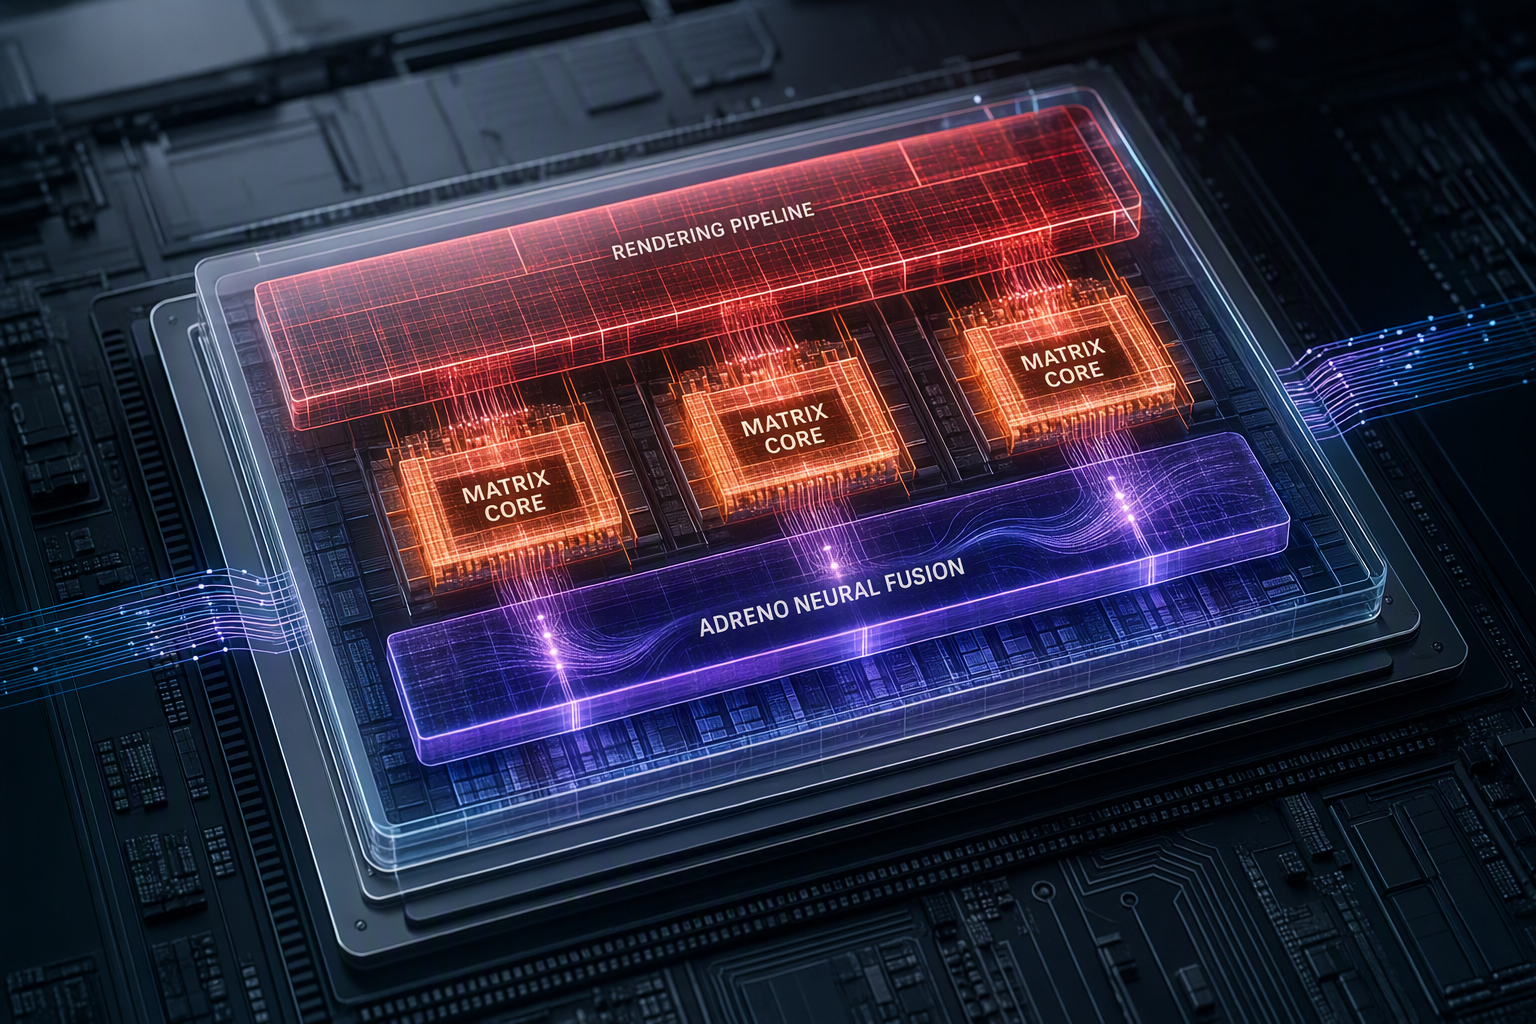
퀄컴의 Adreno Neural Fusion은 AI 기반 렌더링을 GPU 밖의 별도 작업으로 처리하는 대신, 그래픽 처리가 이뤄지는 GPU 내부로 가져오는 아키텍처다. 핵심은 3개 GPU 슬라이스 각각에 전용 AI 연산 블록인 Adreno Matrix Core를 하나씩 결합한 점이다. 퀄컴은 이를 통해 모바일 게임의 AI 초해상도와 프레임 생성을 더 낮은 지연시간과 전력 부담으로 실행하겠다는 목표를 제시했다. 1
4
핵심 변화: GPU 슬라이스마다 Matrix Core 1개
새 Adreno 설계는 3개 GPU 슬라이스로 구성되며, 각 슬라이스에는 Matrix Core가 하나씩 탑재된다. Matrix Core는 고급 그래픽 AI 모델을 GPU 그래픽 파이프라인 안에서 직접 실행하기 위한 전용 연산 블록이다. 2
4
초해상도와 프레임 생성은 렌더링된 프레임, 움직임 정보, 타일 데이터, 중간 렌더링 결과처럼 그래픽 작업과 맞닿아 있는 데이터를 활용한다. 따라서 AI 연산 장치가 GPU 안에 있으면, 데이터를 별도 처리 블록으로 옮기고 결과를 다시 동기화하는 과정을 줄일 수 있다. 퀄컴은 이런 배치가 분리된 방식보다 지연시간과 전력 오버헤드를 낮춘다고 설명한다. 1
3
Neural Fusion이 하는 일
Adreno Neural Fusion은 다음을 하나의 그래픽 워크플로로 묶는 퀄컴의 명칭이다.
- 신경망 처리
- AI 초해상도
- 프레임 생성
1
예를 들어 게임은 내부 렌더링 해상도를 낮춘 뒤 AI 모델로 최종 이미지를 재구성하거나, 이미 렌더링된 프레임 데이터를 바탕으로 추가 프레임을 만들어낼 수 있다. 모든 픽셀이나 프레임을 전통적인 방식으로만 그리지 않고도, 더 높은 디테일과 부드러운 화면을 목표로 하는 접근이다.
퀄컴은 더 선명하고 안정적인 이미지, 그리고 반짝임(shimmering)·깜빡임·고스팅 같은 아티팩트 감소를 기대 효과로 제시한다. 다만 이는 회사의 발표 기준이며, 실제 화질과 입력 지연은 게임별 구현에 따라 달라질 수 있다. 아직 독립적인 실측 비교 결과도 공개되지 않았다. 1
13
18MB Adreno HPM이 중요한 이유
GPU에는 **18MB Adreno High Performance Memory(HPM)**도 탑재된다. 이는 GPU 가까이에 둔 저지연 메모리로 설명되며, 타일 렌더링 데이터와 프레임 버퍼, 컴퓨트 작업 데이터 등을 로컬에 보관하는 용도다. 1
4
이런 중간 이미지 데이터를 시스템 메모리에서 반복적으로 읽고 쓰는 일을 줄이면, 메모리 대역폭 요구량과 지연시간, 에너지 사용량을 낮출 수 있다. 퀄컴 발표를 인용한 보도에 따르면 3슬라이스 GPU의 최고 클록은 이전 설계의 1.2GHz에서 1.45GHz로 올라가며, 전력 효율은 약 12% 개선되는 것으로 제시됐다. 2
5
‘최대 40% 전력 절감’은 어떻게 봐야 하나
퀄컴은 관련 AI 렌더링 시나리오에서 이전 솔루션 대비 GPU 전력 소비를 최대 40% 낮출 수 있다고 홍보한다. 13
다만 이 수치를 모든 게임과 스마트폰에서 동일하게 얻는 배터리 사용 시간 증가로 받아들이기는 어렵다. 실제 결과는 게임의 기능 적용 방식, AI 모델, 화면 주사율, 기기 냉각 성능, 그리고 해당 게임이 GPU·CPU·메모리 중 어디에서 병목이 생기는지에 따라 달라진다. 출시 기기와 지원 게임에 대한 독립 테스트 전까지는, 이 수치를 퀄컴의 설계 목표 및 자체 측정치로 보는 편이 적절하다.
Unity·Unreal Engine 지원
퀄컴은 Adreno Neural Fusion이 Unity와 Unreal Engine에서 지원된다고 밝혔다. 1
4 엔진 차원의 지원은 게임 스튜디오가 기능을 적용하기 위한 별도 그래픽 통합 작업을 줄일 가능성이 있다. 그렇다고 모든 Unity·Unreal 게임이 자동으로 이 기능을 쓰거나, 같은 수준의 화질·성능 향상을 얻는다는 뜻은 아니다.
차세대 스냅드래곤 전략에서의 위치
이번 GPU 공개는 퀄컴이 미리 공개한 차세대 Oryon CPU 및 FlexCache와도 연결된다. 퀄컴은 Oryon CPU가 5GHz에 도달한다고 밝혔고, FlexCache는 성격이 다른 CPU 코어가 동적으로 할당되는 공유 캐시 풀에 접근하도록 하는 캐시 아키텍처다. 큰 작업 데이터 세트가 메모리로 밀려나는 일을 줄이는 것이 목적이다.
이를 종합하면 퀄컴의 방향은 이렇다. 그래픽에 인접한 지연 민감형 AI 작업은 Matrix Core를 갖춘 GPU가 맡고, CPU와 캐시 시스템은 앱 반응성과 변화하는 작업 부하를 처리한다. 퀄컴은 9월 22~24일 미국 마우이에서 열릴 Snapdragon Summit에서 Hexagon NPU 정보를 포함한 플랫폼 세부 사항을 추가로 공개할 예정이었다. 11
아직 확인되지 않은 점
공개된 내용은 아키텍처의 방향을 보여주지만, 실제 제품 판단에 필요한 정보는 더 남아 있다.
- 이 Adreno 설계를 채택할 최종 스냅드래곤 제품
- Neural Fusion을 활성화해 출시할 게임 목록
- 게임별 초해상도 및 프레임 생성의 화질·지연시간
- 스마트폰의 지속 발열 환경에서도 전력 절감 주장이 유지되는지 여부
- GPU 내부 Matrix Core와 SoC의 다른 온디바이스 AI 처리 장치 간 작업 분담 방식
요지는 분명하다. 퀄컴은 AI 렌더링을 GPU의 외부 부가 기능이 아니라 GPU 고유 기능으로 만들려 한다. 결국 중요한 검증은 출시 게임에서 이 설계가 일관된 화질 개선, 더 부드러운 플레이, 측정 가능한 배터리 절감으로 이어지는지다.
Studio Global AI
연구를 계속하세요
이 페이지에는 Studio Global 내에서 계속할 수 있는 소스 기반 답변이 포함되어 있습니다.
사람들은 또한 묻습니다.
"퀄컴 Adreno Neural Fusion: AI 업스케일링과 프레임 생성을 GPU 안에서 처리하는 방식"에 대한 짧은 대답은 무엇입니까?
차세대 Adreno GPU는 3개 슬라이스 각각에 전용 AI 연산 블록인 Adreno Matrix Core를 넣어, AI 초해상도와 프레임 생성을 그래픽 파이프라인 내부에서 실행하도록 설계됐다.
먼저 검증할 핵심 포인트는 무엇인가요?
차세대 Adreno GPU는 3개 슬라이스 각각에 전용 AI 연산 블록인 Adreno Matrix Core를 넣어, AI 초해상도와 프레임 생성을 그래픽 파이프라인 내부에서 실행하도록 설계됐다. GPU 인접 저지연 메모리인 18MB Adreno HPM은 타일 렌더링 데이터와 프레임 버퍼 등을 가까이 보관해 시스템 메모리 왕복을 줄이는 역할을 한다.
실무에서는 다음으로 무엇을 해야 합니까?
퀄컴은 Unity와 Unreal Engine 지원을 발표했으며, 이번 GPU 공개는 5GHz Oryon CPU 및 동적 공유 캐시 구조인 FlexCache 발표과 함께 차세대 스냅드래곤 전략의 일부를 이룬다.
출처
9to5google.comQualcomm's next premium chip has an Adreno Neural ...
xenospectrum.comQualcomm Debuts Adreno Neural Fusion: AI Cores Built ...
hothardware.comQualcomm Unveils Adreno Neural Fusion To Supercharge Mobile Gaming