studioglobal
Discover

답변 - 페이지: 1716 | 발견하다
발견하다
모두답변보고서코드워크플로우갤러리트렌딩
  • Abstract illustration of Kimi K2.6 as a coding-focused AI model being evaluated against software benchmarks

    Kimi K2.6 리뷰: 코딩에는 강하지만 ‘만능 AI’로 보긴 이르다

    7개월 전12 소스
  • Abstract comparison of AI coding models Kimi K2.6, GPT-5.5, Gemini and Claude

    Kimi K2.6 vs GPT-5.5·Gemini·Claude: 개발자 관점의 결론

    7개월 전23 소스
  • GPT-5.5とClaude Opus 4.7のAIモデル比較を表す抽象的なワークフロー図

    GPT-5.5 vs Claude Opus 4.7: 실무 실행형인가, 장문 에이전트형인가

    7개월 전21 소스
  • DeepSeek V4の暫定評価を象徴するAIチップとベンチマーク画面の抽象イメージ

    DeepSeek V4 잠정 평가: 프런티어급에 가깝지만 ‘세계 최고’는 아직

    7개월 전18 소스
  • Ilustración editorial sobre cómo comprobar el acceso a GPT-5.5 en España en ChatGPT, Codex y la API

    스페인에서 GPT-5.5가 보이지 않을 때 확인할 곳

    7개월 전18 소스
  • Editorial illustration for a guide to trying GPT-5.5 in ChatGPT

    GPT-5.5를 무료로 써보려면? ChatGPT에서 먼저 확인할 것

    7개월 전12 소스
  • 抽象比較 Claude Opus 4.7 與 GPT-5.5 在 AI 工作流中的選型差異

    Claude Opus 4.7 vs GPT-5.5: 벤치마크보다 먼저 봐야 할 선택 기준

    7개월 전11 소스
  • Split-screen editorial illustration comparing Claude Opus 4.7 and GPT-5.5 for coding, agents, research and design

    Claude Opus 4.7 vs GPT-5.5: 코딩·에이전트·리서치에 무엇을 쓸까

    7개월 전17 소스
  • GPT-5.5の利用可否をChatGPT、Codex、APIで確認するイメージ

    GPT-5.5 지금 쓰려면: ChatGPT·Codex·API 공식 지원 현황

    7개월 전15 소스
  • 네 개의 AI 모델 벤치마크 점수를 비교하는 추상적인 대시보드 일러스트

    GPT-5.5 vs Claude Opus 4.7 vs DeepSeek V4 vs Kimi K2.6: 벤치마크별 승자

    7개월 전24 소스
  • Ilustración editorial de benchmarks de Claude Opus 4.7 con gráficos de rendimiento y código

    Claude Opus 4.7 벤치마크: SWE-bench Verified 87.6%를 어떻게 봐야 할까

    7개월 전12 소스
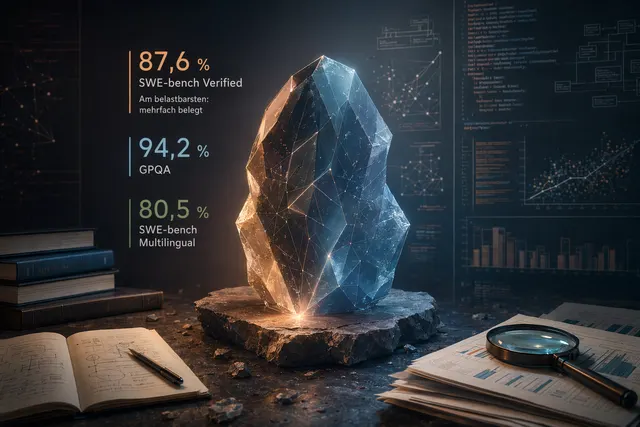
  • Abstrakte Visualisierung von Claude Opus 4.7 Benchmarks mit Diagrammen und Code-Elementen

    Claude Opus 4.7 벤치마크: SWE-bench 87.6%, GPQA 94.2%는 얼마나 믿을 만한가

    7개월 전16 소스
이전다음