답변게시됨12 소스
앤트로픽은 클로드의 ‘숨은 추론’을 어떻게 지도화하나
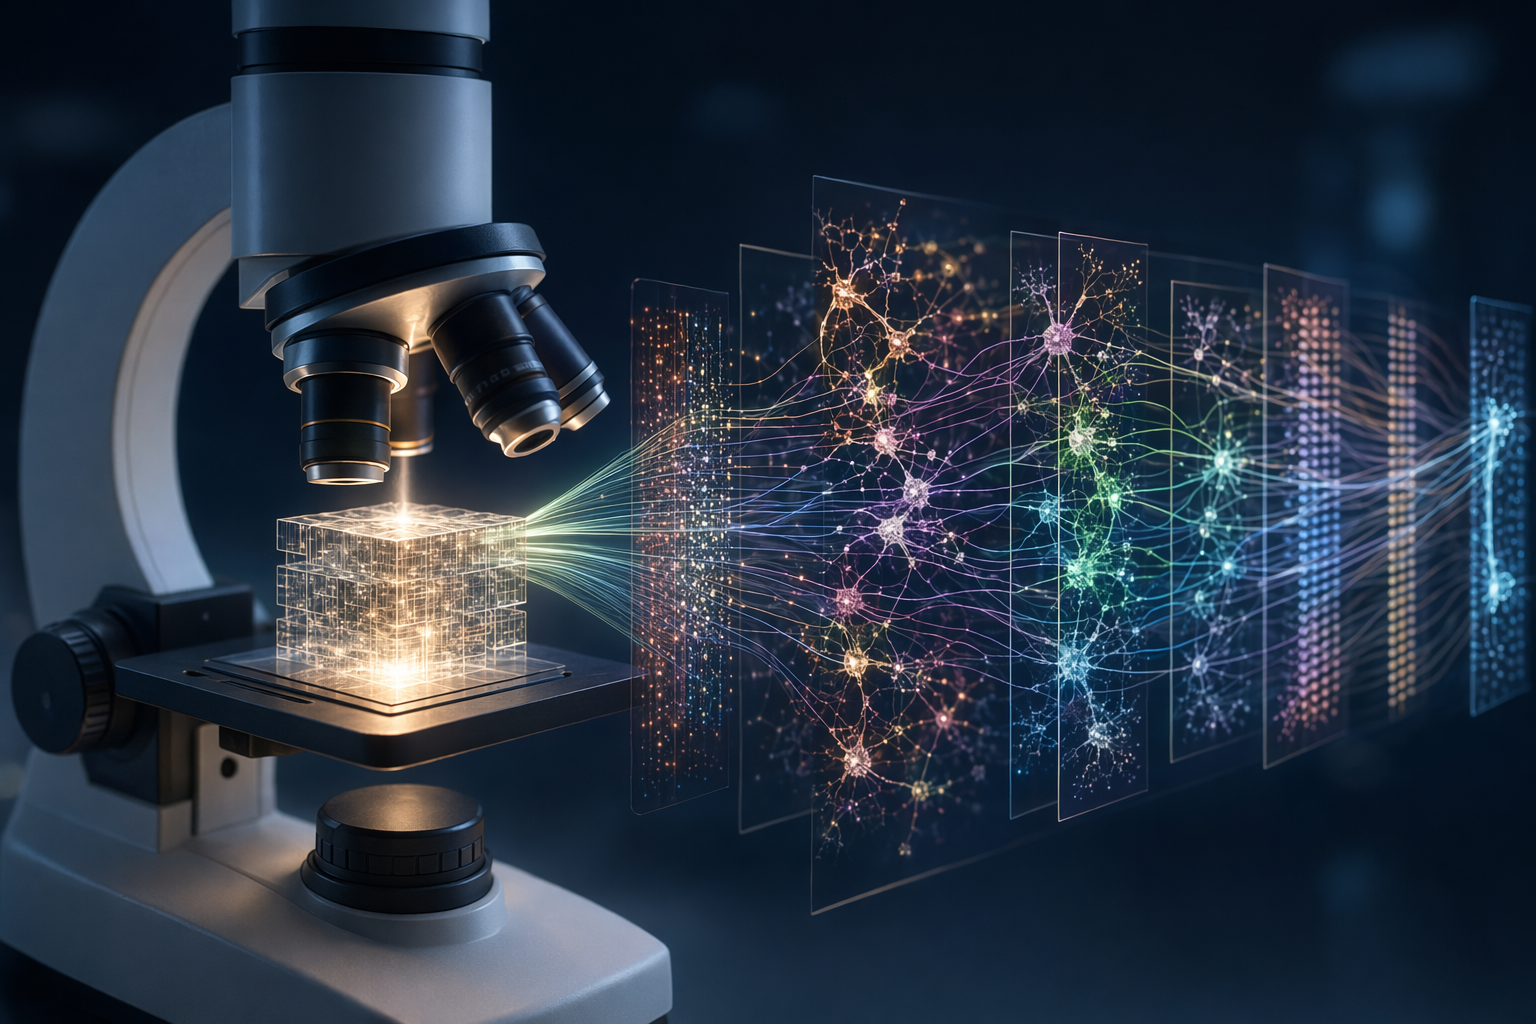
앤트로픽은 Claude의 내부 활성값을 사람이 해석할 수 있는 ‘특징’으로 바꾸고, 이를 ‘회로’로 연결하는 해석가능성 도구를 개발하고 있다 [9][10]. 핵심은 Claude에게 이유를 말하게 하는 것이 아니라, 입력 단어가 출력 단어로 바뀌는 내부 계산 경로의 일부를 직접 들여다보려는 데 있다 [9][10].
게시자GPT-5.5로 편집GPT Image 2로 이미지 생성
연구 답변
주요 시사점
- 앤트로픽은 Claude의 내부 활성값을 사람이 해석할 수 있는 ‘특징’으로 바꾸고, 이를 ‘회로’로 연결하는 해석가능성 도구를 개발하고 있다 [9][10].
- 핵심은 Claude에게 이유를 말하게 하는 것이 아니라, 입력 단어가 출력 단어로 바뀌는 내부 계산 경로의 일부를 직접 들여다보려는 데 있다 [9][10].
- 이 접근은 Claude 3.5 Haiku 연구에도 적용됐지만, 현재 도구는 모델 내부의 ‘일부’만 보여줄 뿐 완전한 사고 기록이나 만능 해독기는 아니다 [9][10].
AI 프롬프트
openai.comCreate a landscape editorial hero image for this Studio Global article: Anthropic’s AI Microscope: How Claude’s Hidden Reasoning Is Being Mapped. Article summary: Anthropic’s 2025 interpretability work tries to make Claude’s hidden reasoning legible by mapping internal activations into “features” and linking them into “circuits”; it is progress toward an AI “microscope,” not a.... Topic tags: ai, anthropic, claude, ai safety, ai transparency. Reference image context from search candidates: Reference image 1: visual subject "### Anthropic Develops AI 'Microscope' to Reveal the Hidden Mechanics of LLM Thought. Anthropic has unveiled new research tools designed to provide a rare glimpse into the hidden r" source context "Anthropic Develops AI 'Microscope' to Reveal the Hidden Mechanics of LLM Thought -- Campus Technology" Reference image 2: visual subject "Late 2024, Anthropic published a p
AI가 그럴듯한 답을 내놓을 때, 이용자가 정말 궁금한 것은 단순히 ‘무슨 말을 했나’가 아닙니다. ‘왜 그런 답이 나왔나’, 더 정확히는 ‘모델 내부에서 어떤 계산이 그런 답을 만들었나’입니다.
앤트로픽(Anthropic)의 Claude 연구는 이 질문에 답하기 위한 도구 만들기에 가깝습니다. 회사는 이를 일종의 ‘AI 현미경’으로 설명하며, Claude의 내부 계산 일부를 사람이 검토하고 시험할 수 있는 형태로 드러내려는 메커니즘 해석가능성 연구를 진행하고 있습니다 .
‘AI 현미경’은 마음 읽기가 아니다
대형 언어 모델은 단어 하나를 쓸 때마다 수십억 번의 계산을 수행합니다. 앤트로픽은 그 전략이 모델 개발자에게도 특수한 도구 없이는 곧바로 읽히지 않는다고 설명합니다 .
Studio Global AI
연구를 계속하세요
이 페이지에는 Studio Global 내에서 계속할 수 있는 소스 기반 답변이 포함되어 있습니다.
사람들은 또한 묻습니다.
"앤트로픽은 클로드의 ‘숨은 추론’을 어떻게 지도화하나"에 대한 짧은 대답은 무엇입니까?
앤트로픽은 Claude의 내부 활성값을 사람이 해석할 수 있는 ‘특징’으로 바꾸고, 이를 ‘회로’로 연결하는 해석가능성 도구를 개발하고 있다 [9][10].
먼저 검증할 핵심 포인트는 무엇인가요?
앤트로픽은 Claude의 내부 활성값을 사람이 해석할 수 있는 ‘특징’으로 바꾸고, 이를 ‘회로’로 연결하는 해석가능성 도구를 개발하고 있다 [9][10]. 핵심은 Claude에게 이유를 말하게 하는 것이 아니라, 입력 단어가 출력 단어로 바뀌는 내부 계산 경로의 일부를 직접 들여다보려는 데 있다 [9][10].
실무에서는 다음으로 무엇을 해야 합니까?
이 접근은 Claude 3.5 Haiku 연구에도 적용됐지만, 현재 도구는 모델 내부의 ‘일부’만 보여줄 뿐 완전한 사고 기록이나 만능 해독기는 아니다 [9][10].