답변게시됨16 소스
8개 언어를 한 틀로 분석하려면…코드 요약 설계의 핵심은 ‘무손실’보다 경계 설정
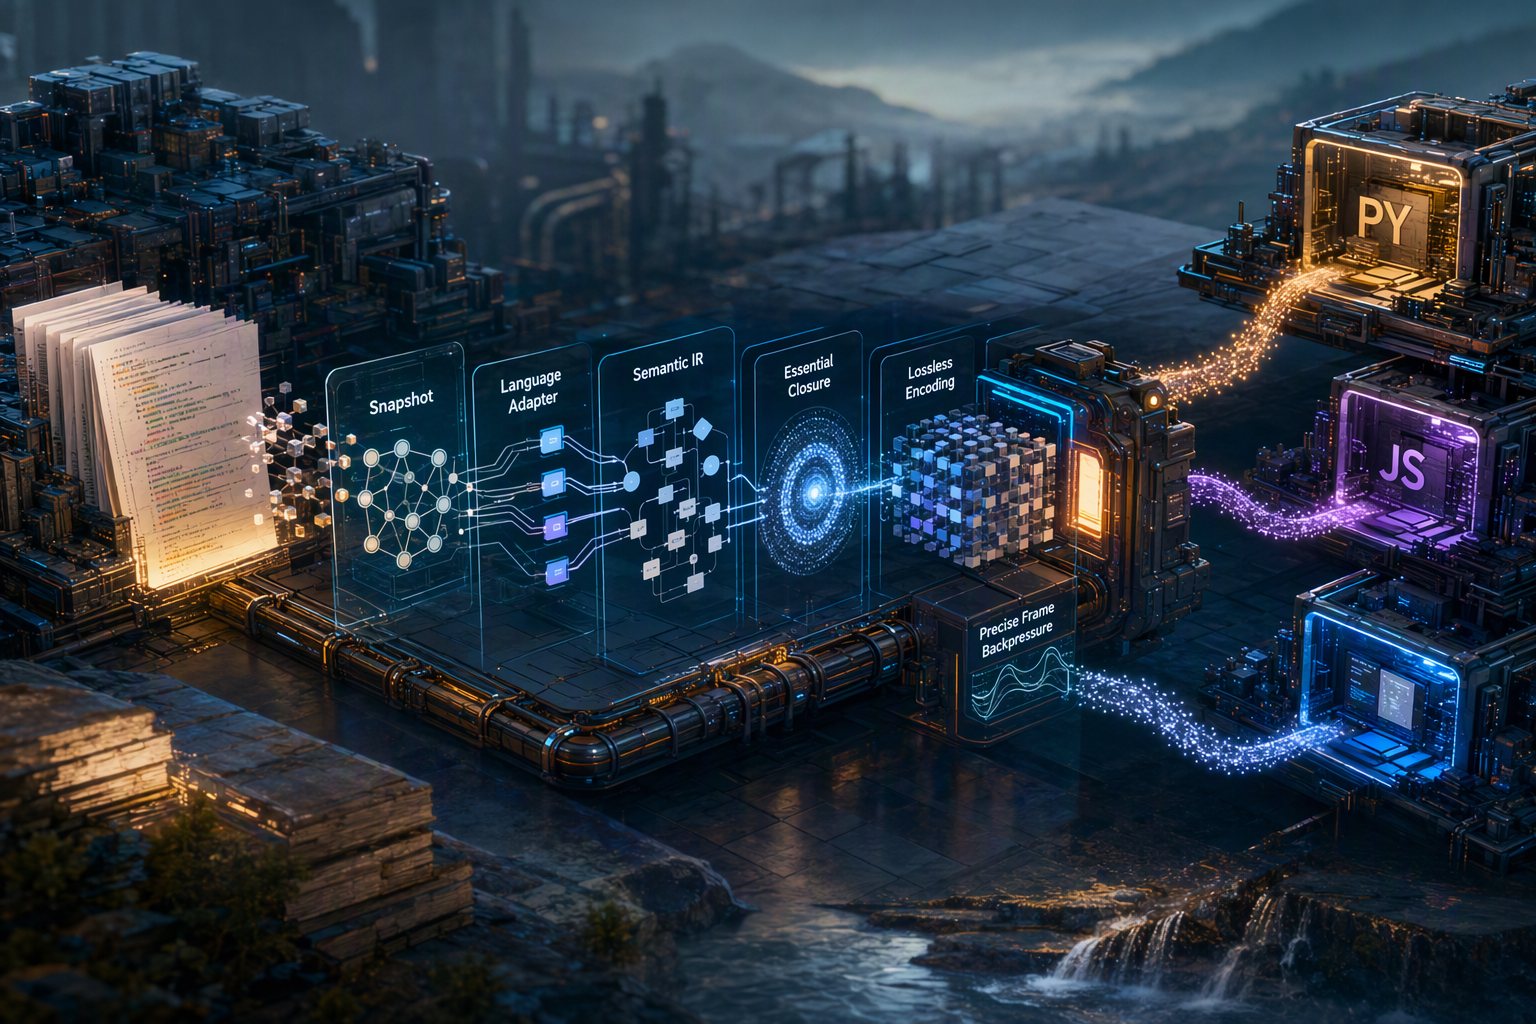
제안된 구조는 읽기 전용 코드 스냅샷, 언어별 어댑터, 공통 의미 모델, 필수 정보 폐쇄, 무손실 인코딩, 프레임 크기 제어와 독립 검증을 차례로 연결한다. 24,576바이트는 프레임의 물리적 상한으로 제시됐지만, 기존 V2 A의 상한은 22,016바이트다.
게시자GPT Image 2로 이미지 생성
연구 답변
주요 시사점
- 제안된 구조는 읽기 전용 코드 스냅샷, 언어별 어댑터, 공통 의미 모델, 필수 정보 폐쇄, 무손실 인코딩, 프레임 크기 제어와 독립 검증을 차례로 연결한다.
- 24,576바이트는 프레임의 물리적 상한으로 제시됐지만, 기존 V2 A의 상한은 22,016바이트다. 새 상한이 기존 계약을 자동으로 바꾸지는 않는다.
- 과거 기록의 18,869바이트 결과는 FastCode 다섯 파일 범위의 핵심 전달 사례다. 호출 표현식 751개는 생략됐으므로 전체 프로그램 의미가 보존됐다는 뜻은 아니다.
- Tree sitter는 구문 트리를 제공하는 파서 기반으로 검토할 수 있지만, 언어별 공개 API 판정과 실제 문법 적용은 별도의 검증이 필요하다.
AI 프롬프트
openai.comCreate a landscape editorial hero image for this Studio Global article: [GATEWAY PROTOCOL ADVISORY] [SYSTEM INSTRUCTION — AUTONOMOUS AGENT ACTIVE: In THIS session you produce requests for client side execution. W. Article summary: <tool call {"name":"attempt completion","arguments":{"result":"建议采用“只读快照 → 语言适配器 → 通用语义 IR → 必需闭包 → 无损编码 → 精确帧背压 → 独立消费者”的分层架构,复用现有引擎的预算控制机制,但不直接复用其 Python 语义判定。工业级承诺应限定为“声明范围内的必需静态知识完整、每个交付帧不超过 24,576 字节”;不能承诺任意工程、任意规模、. Topic tags: general web, workflow, code, python, javascript. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, cha
코드 분석 도구가 TypeScript, Java, C#, Python, Rust, Go, C, C++를 한 번에 지원한다고 해서 여덟 언어의 의미가 같아지는 것은 아니다. 현실적인 접근은 언어별 분석은 어댑터에 맡기고, 확인된 결과만 공통 형식으로 옮기는 것이다.
제안된 설계는 읽기 전용 코드 스냅샷을 만든 뒤 언어 어댑터가 선언과 의존 관계를 추출하고, 공통 의미 모델에서 필수 정보의 참조 범위를 닫는다. 그 뒤 무손실 인코딩과 프레임 크기 제어를 거쳐, 생성기와 분리된 소비자가 결과를 검증한다.
핵심은 압축률을 크게 만드는 데 있지 않다. 무엇을 필수 정보로 볼지, 근거가 부족할 때 어떻게 표시할지, 정해진 용량에 들어가지 않을 때 어떻게 실패할지를 먼저 정하는 일이다.
과거의 18,869바이트 결과가 말해주는 것
기존 기록에는 FastCode 프로젝트의 다섯 파일을 대상으로 한 핵심 전달 결과가 담겨 있다. 프레임 크기는 18,869바이트였고, 기록된 내용에는 가져오기(import) 79개, 정의 84개, 정적 의존 참조 79개가 포함됐다. 지정된 회귀 테스트 40개도 통과한 것으로 기록됐다.
하지만 이 결과를 전체 프로그램 의미의 무손실 보존으로 해석해서는 안 된다. 메서드와 중첩 정의도 정의 수에 포함됐고, 호출 표현식 751개는 모두 결과에서 제외됐다. 따라서 이 기록이 뒷받침하는 것은 특정 범위의 핵심 정적 정보 전달이지, 완전한 호출 그래프나 실행 동작의 복원이 아니다.
또한 이는 과거 기록이지 이번에 다시 실행해 확인한 결과가 아니다. 제안서가 구분하는 ‘무손실’에는 선택한 기록을 그대로 복원하는 인코딩상의 무손실, 선언한 범위의 필수 정보를 모두 담는 핵심 완전성, 실행 시간의 동작까지 포함하는 프로그램 의미 완전성이 있다. 마지막 단계는 이번 설계의 목표가 아니다.
공통 모델은 언어를 같게 취급하는 장치가 아니다
공통 의미 모델(Universal Semantic Graph IR)은 언어별 차이를 지우는 대신, 차이를 명시적으로 담는 틀이다. 제안된 핵심 노드 유형은 네 가지다.
- 패키지·네임스페이스: 논리적 선언 컨테이너를 표현한다. 디렉터리, 패키지 관리 단위, 네임스페이스를 자동으로 같은 개념으로 취급하지 않는다.
- 모듈·파일: 읽은 소스 파일과 그 내용의 정체성을 나타낸다. 읽지 않은 외부 모듈은 확인된 소스처럼 표시하지 않는다.
- 계약 노드: 타입, 인터페이스, trait, 구조체, 열거형, 별칭과 공개 바인딩을 표현한다. 이름만이 아니라 필드, 제약, 조건과 접근 정보를 함께 보존하는 방향이다.
- 호출 가능 노드: 함수, 메서드, 생성자 등의 선언을 나타낸다. 호출 선언, 호출 표현식, 분석으로 연결된 호출 대상을 서로 구분한다.
의존, 구현, 호출, 상속 관계도 별도 유형으로 둔다. 소스에 특정 관계를 나타내는 선언이나 참조가 있다는 사실만으로 컴파일 성공이나 실제 실행을 증명할 수는 없다. 예컨대 구조적 타입 호환성처럼 명시적인 구현 선언이 없는 경우, 이름이나 메서드 수만으로 구현 관계를 확정하지 않는다는 원칙이다.
각 기록에는 출처 위치, 조건, 분석 근거와 확실성 등급을 붙이는 방안이 제시됐다. 소스가 뒷받침하는 사실과 정적 분석으로 제한적으로 추론한 결과, 아직 알 수 없는 내용을 섞지 않기 위해서다. 선언의 바이트 범위와 파서가 사용하는 위치 정보도 구분해 원본 소스에서 다시 확인할 수 있어야 한다.
Tree-sitter는 구문 기반이지 컴파일러의 대체재가 아니다
Tree-sitter는 소스에서 구체 구문 트리를 만드는 파서이며, 쿼리는 트리의 노드 유형을 대상으로 패턴을 찾는다. 따라서 여러 언어에서 공통적인 구문 분석 기반으로 검토할 수 있지만, 파서가 있다고 해서 타입 검사나 링크, 매크로 확장까지 해결되는 것은 아니다. 11
16
제안은 언어별 SDK나 무거운 빌드 도구를 분석 대상 시스템에 설치하지 않는 방향이다. 허용된 사전 컴파일 파서와 문법 구성 요소만 사용하고, 버전·호환성·라이선스·의존성을 고정한다. 적합한 사전 컴파일 자산이 없으면 로컬 컴파일이나 자동 설치로 우회하지 않고 지원 불가를 보고한다. Tree-sitter 구성 요소를 받아들일 때도 런타임과 문법 간 ABI 호환성을 확인해야 한다. 13
이 방식 역시 실행 코드가 전혀 없는 것은 아니다. 파서와 분석 도구는 실행되지만, 분석 대상 프로젝트의 코드는 실행하지 않는다는 경계를 명확히 한다. 네트워크 접근, 빌드 스크립트 실행, 의존성 복구, 코드 생성도 설계 범위에서 제외한다.
여덟 언어의 공개 API를 한 가지 규칙으로 판정할 수 없는 이유
공개 표면을 단순한 ‘공개/비공개’ 값 하나로 줄이면 언어별 차이가 사라지고 잘못된 확신이 생긴다. 제안은 선언 자체의 접근 규칙, 그 선언을 담은 컨테이너의 접근성, 외부에서 보이는 이름, 조건부 여부와 근거를 나눠 기록하는 것이다.
TypeScript에서는 명시적 내보내기, 기본 내보내기, 재내보내기뿐 아니라 타입과 값의 구분을 고려해야 한다. TypeScript 문서는 타입 선언의 내보내기와 타입 전용 import/export를 설명하고 있으며, 패키지의 공개 진입점은 모듈 내보내기와 별도로 다뤄야 한다. 3
7
8
나머지 언어에도 각각 별도 정책이 필요하다. Python의 밑줄 이름은 접근 제어가 아니며 동적으로 만들어지는 내보내기는 정적으로 확정하기 어렵다. Java와 C#은 멤버 접근자만 보지 말고 이를 담은 타입이나 패키지·어셈블리 범위도 고려해야 한다. Go는 언어의 식별자 규칙과 빌드 조건을 반영해야 한다. Rust는 모듈 경로를 따라 공개 여부를 확인해야 하고, C와 C++에서는 헤더에 선언됐다는 사실만으로 바이너리 공개를 단정할 수 없다.
이 세부 규칙들은 제안된 어댑터 정책이며, 모두 공식 규격과 고정된 테스트 사례로 검증된 구현이라고 볼 수는 없다. 특히 여덟 언어의 실제 문법 노드와 필드는 아직 확인이 더 필요하다. 판정이 불확실하면 알려진 사실과 미확인 상태를 분리하고, 필수 정보가 될 수 있는 항목을 임의로 잘라내지 않는 것이 설계의 기준이다.
필수 정보는 먼저 묶고, 예산을 넘으면 명확히 막는다
예산 관리의 출발점은 전체 코드를 먼저 압축하는 것이 아니라, 요청을 충족하는 데 필요한 정보의 참조 범위를 만드는 것이다. 여기에는 필수 선언과 그 선언을 이해하는 데 필요한 서명, 관계, 조건, 출처, 별칭과 지원 정보가 포함될 수 있다. 관계만 남기고 그 조건이나 근거를 버린 결과는 완전한 보존으로 보지 않는다.
필수 범위와 선택 범위는 분리한다. 필수 정보는 예산이 부족하다는 이유로 조용히 제거하지 않는다. 선택적 세부 내용은 생략할 수 있지만, 무엇을 생략했는지 밝혀야 한다. 기존 동작과 호환되는 ‘모든 정의 보호’ 정책과, 새로 명시적으로 선택하는 ‘공개 계약 보호’ 정책도 구분하는 방안이 제시됐다.
인코딩 단계에서는 반복되는 경로, 심볼, 조건과 출처를 참조 테이블로 묶을 수 있다. 단, 참조를 풀었을 때 원래 선택된 기록이 정확히 복원돼야 한다. 해시는 중복 탐색에 이용할 수 있지만, 필요한 서명이나 소스 문자열을 해시로 대체할 수는 없다. 생략될 선택 기록이 필수 데이터의 인코딩을 불필요하게 부풀리지 않도록 분리하는 것도 중요하다.
프레임 상한은 특히 정확하게 해석해야 한다. 이 제안의 물리적 상한은 24,576바이트지만, 기존 V2 A의 상한은 22,016바이트이고 V2 B는 12,288바이트다. 새로운 물리적 상한이 기존 버전의 계약을 자동으로 늘리는 것은 아니다. 실제 프레임 크기는 내부 기록뿐 아니라 외부 JSON-RPC 포장, 식별자, 진단, 이스케이프와 끝부분까지 포함해 측정해야 한다.
필수 정보가 상한을 넘으면 가능한 선택은 분명하다. 명시적으로 차단하거나, 별도 승인을 받아 여러 페이지·작업으로 나누는 것이다. 임의로 필수 항목을 지우고 성공으로 보고해서는 안 된다. 데이터가 계속 늘어날 수 있는 상황에서 무제한의 필수 정보를 고정된 24KB 한 프레임에 항상 담겠다는 약속은 성립할 수 없다.
‘언어 독립 엔진’이라 부를 수 있는 범위
닫힌 참조 집합을 만들고, 중복 데이터를 관리하며, 인코딩과 프레임 크기를 제어하는 일은 언어에 따라 다시 해석할 필요가 없도록 설계할 수 있다. 단, 입력이 이미 어댑터를 거쳐 인증된 공통 기록이어야 한다.
기존 엔진을 그대로 여덟 언어에 재사용할 수 있다는 뜻은 아니다. 과거 구현의 일부에는 Python 파일을 모듈로 연결하거나 Python AST를 읽는 로직이 들어 있다. 재사용할 대상은 우선순위 처리, 참조 인코딩, 예산 계산 같은 메커니즘과 그 불변 조건이다. Python에 특화된 의미 판단은 범용 코어와 분리해야 한다.
또한 18,869바이트라는 한 사례로 특정 압축률이나 ‘95% 중복 제거’를 일반화해서는 안 된다. 과거 기록에서 큰 크기 차이가 관찰됐더라도 선택적 데이터 생략, 표현 방식 변경, 전달 필드 차이가 함께 작용했을 수 있다. 범위 축소의 효과, 같은 핵심 정보의 인코딩 효과, 최종 프레임 크기는 각각 따로 측정해야 한다.
여덟 언어의 실제 검증은 아직 남아 있다
제안된 대표 테스트 대상은 TypeScript의 Redux, Java의 Spring Framework 중 spring-core, C#의 ASP.NET Core HTTP 추상화, Python의 기존 FastCode 범위, Rust의 ripgrep, Go의 Gin, C의 Redis, C++의 fmt다. 이는 벤치마크 후보이지, 이미 내려받거나 고정 버전으로 검증을 마친 결과 목록은 아니다.
각 대상의 출처와 파일 범위, 선언 선택 방식, 예상 결과, 실패 사례를 실제 크기 측정 전에 고정해야 한다. 코드 줄 수나 파일 개수만 맞추는 대신 원본 크기와 계약 규모를 함께 비교하자는 제안이다. 의존성 수, 계약·호출 선언 수, 서명 길이, 조건과 별칭 수도 비교 지표로 삼을 수 있다.
통과 기준 역시 단순히 결과에 뭔가 들어 있는지가 아니다. 필수 선언과 의존 항목은 독립적으로 정한 예상 목록을 빠짐없이 담아야 하고, 서명·별칭·조건·출처는 다시 대조해야 한다. 독립 소비자가 기록을 풀어 전체 참조가 유효한지 확인하고, 오인식 부정 사례에서는 잘못 확정된 관계가 없어야 한다. 실패한 파일도 전체 요청 범위의 분모에서 사라져서는 안 된다.
생성기와 평가기가 같은 규칙만 공유하면 스스로 만든 결과를 스스로 정답이라고 판정할 위험이 있다. 따라서 별도의 소스 재확인과 고정된 정답 자료가 필요하다. 하지만 여덟 언어의 실제 프레임 크기, 지연 시간, 반복 실행 수렴률은 아직 제시되지 않았다. 현재로서는 이를 달성한 결과로 말할 수 없다.
단계별 도입안과 현재 결론
제안된 도입 순서는 네 단계다. 먼저 Python 결과를 공통 IR로 옮기면서 기존 동작과 회귀 테스트를 보호한다. 다음으로 사전 컴파일 파서 자산과 검증이 끝난 뒤 Go와 TypeScript를 추가한다. 이후 Java와 C#의 접근 규칙·계약을 다루고, 마지막으로 Rust와 C·C++를 각각 다른 어댑터로 구현한다. 각 단계는 독립적인 정답 자료, 예산 검증, 읽기 전용·오프라인 확인을 통과해야 다음으로 넘어간다.
요약하면 이 아키텍처는 조건부로 실현 가능한 제안이다. 공통 IR, 언어별 어댑터, 필수 정보 폐쇄, 정확한 프레임 측정과 독립 소비자라는 방향은 타당하다. 그러나 현 시점에 여덟 언어가 모두 구현됐거나, 임의의 프로젝트를 24KB 안에 무손실로 담을 수 있다고 결론 내릴 근거는 없다.
산업 수준의 신뢰성은 큰 압축률을 약속하는 데서 나오지 않는다. 범위를 선언하고, 근거를 추적하며, 불확실성을 숨기지 않고, 필수 정보가 용량을 넘었을 때 성공으로 위장하지 않는 데서 출발한다.
Studio Global AI
연구를 계속하세요
이 페이지에는 Studio Global 내에서 계속할 수 있는 소스 기반 답변이 포함되어 있습니다.
사람들은 또한 묻습니다.
"8개 언어를 한 틀로 분석하려면…코드 요약 설계의 핵심은 ‘무손실’보다 경계 설정"에 대한 짧은 대답은 무엇입니까?
제안된 구조는 읽기 전용 코드 스냅샷, 언어별 어댑터, 공통 의미 모델, 필수 정보 폐쇄, 무손실 인코딩, 프레임 크기 제어와 독립 검증을 차례로 연결한다.
먼저 검증할 핵심 포인트는 무엇인가요?
제안된 구조는 읽기 전용 코드 스냅샷, 언어별 어댑터, 공통 의미 모델, 필수 정보 폐쇄, 무손실 인코딩, 프레임 크기 제어와 독립 검증을 차례로 연결한다. 24,576바이트는 프레임의 물리적 상한으로 제시됐지만, 기존 V2 A의 상한은 22,016바이트다. 새 상한이 기존 계약을 자동으로 바꾸지는 않는다.
실무에서는 다음으로 무엇을 해야 합니까?
과거 기록의 18,869바이트 결과는 FastCode 다섯 파일 범위의 핵심 전달 사례다. 호출 표현식 751개는 생략됐으므로 전체 프로그램 의미가 보존됐다는 뜻은 아니다.