答え公開済み26 ソース
Samsung「zHBM」とは?AIチップ直上にHBMを積む3Dメモリー構想を解説
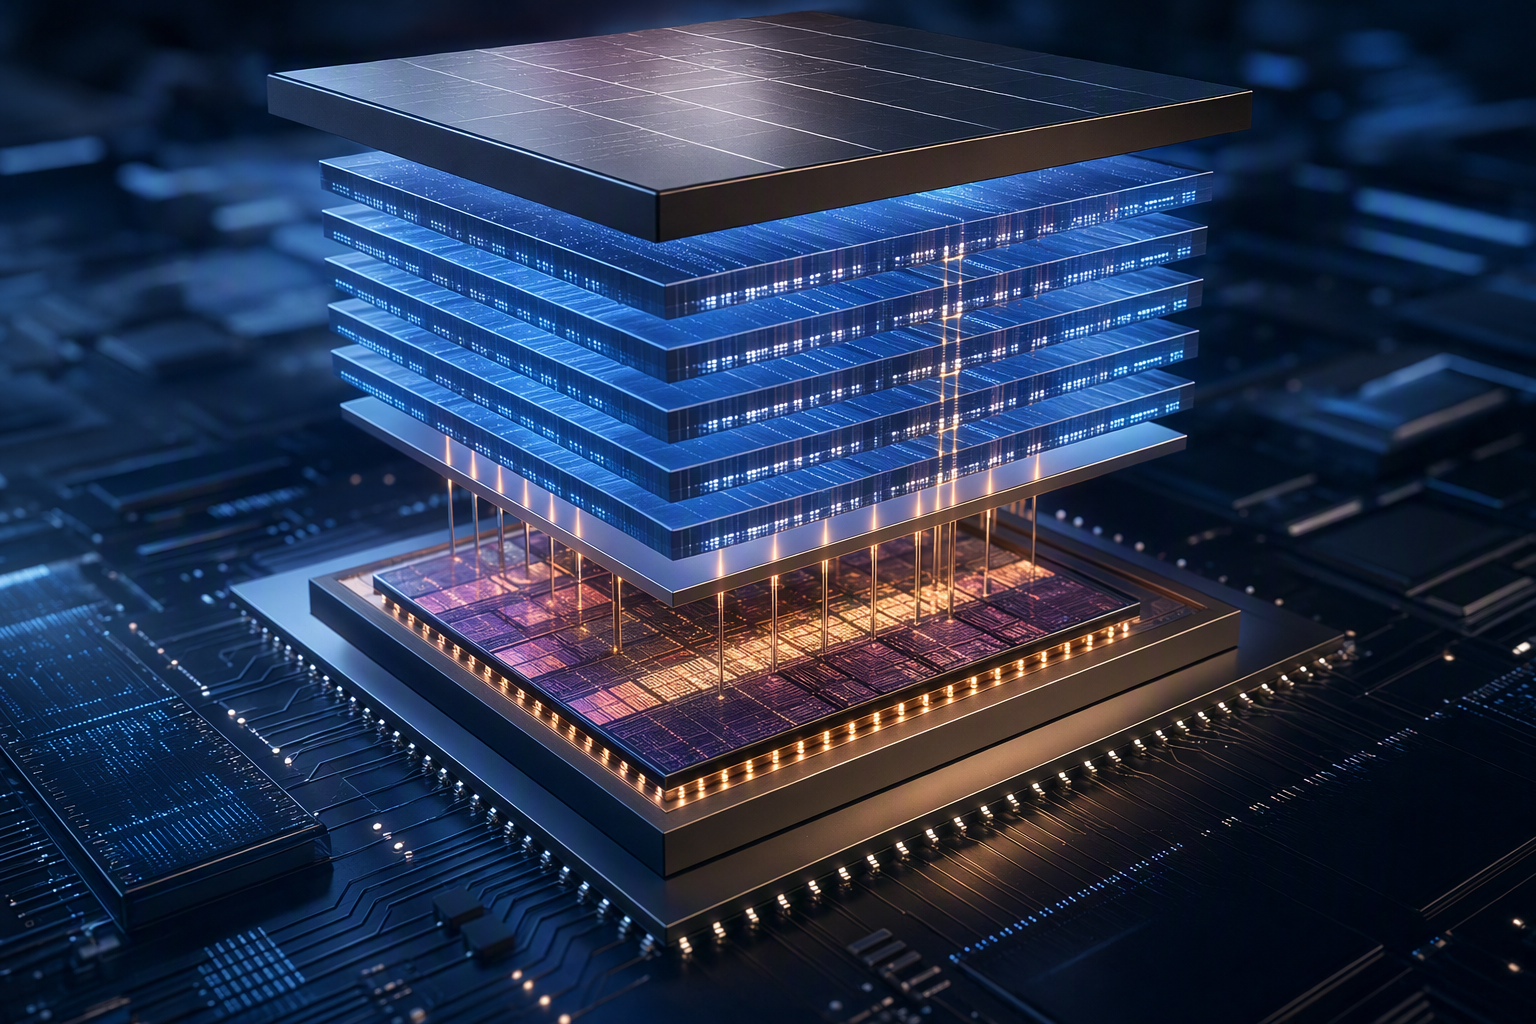
zHBMは、AIアクセラレーターの横ではなく直上にHBMを積層し、データ移動距離を縮める3Dメモリーアーキテクチャだ。 サムスンは、次世代インターフェースでHBM5比約8倍の性能、10倍超のメモリー密度、約3倍の電力効率、熱抵抗50%超の低減を目標に掲げる。
公開者GPT-5.6 Terra で編集GPT Image 2 で画像を生成
研究の答え
重要なポイント
- zHBMは、AIアクセラレーターの横ではなく直上にHBMを積層し、データ移動距離を縮める3Dメモリーアーキテクチャだ。
- サムスンは、次世代インターフェースでHBM5比約8倍の性能、10倍超のメモリー密度、約3倍の電力効率、熱抵抗50%超の低減を目標に掲げる。
- OpenAIとIntelの技術者は、CXLは大容量・低頻度データ向けの補完層にはなり得ても、AIモデルの実行時にHBMを置き換えるものではないとの見方を示した。
AI プロンプト
openai.comCreate a landscape editorial hero image for this Studio Global article: What did Samsung Electronics reveal at the September 16, 2026, AI Infrastructure Summit about its next-generation zHBM 3D memory architectur. Article summary: Samsung presented zHBM as a longer-term “zero-distance” HBM architecture: rather than placing HBM beside an AI accelerator on a silicon interposer, as in current 2.5D packages, it would bond HBM directly above the accele. Topic tags: general, general web, user generated, news. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts w
AI向け半導体では、演算性能だけを上げても十分ではありません。GPUなどのAIアクセラレーターが必要なデータをメモリーから受け取るまでの距離、帯域幅、消費電力、発熱が、システム全体の応答性を左右するためです。
サムスン電子が示した「zHBM」は、この問題に対し、HBM(High Bandwidth Memory)をAIアクセラレーターの真上へ直接積層するという3D実装で挑む構想です。9月16日に米カリフォルニア州サンタクララで開催されたAI Infrastructure Summitで、同社はAIエージェント時代の応答速度を10倍超へ高める方向性としてzHBMを位置付け、毎秒1,000トークンを目標に掲げました。1
9
現行の2.5Dパッケージと何が違うのか
現在のHBMは一般に、GPUなどのアクセラレーターと同じ平面上で横に並べて実装され、先端パッケージ技術で接続されます。これに対しzHBMは、HBMをプロセッサーの上方に垂直配置します。12
13
狙いは単純です。演算ロジックとメモリーの物理的な隔たりを短くし、データの往復距離を減らすことです。サムスンは、この垂直統合に次世代のウエハー接合技術、ハイブリッド・カッパー・ボンディング(銅ハイブリッド接合)を用いると説明しています。距離が縮まれば、より高い帯域幅と電力効率、限られた面積での大容量化が期待されます。7
48
ただし、zHBMは現時点で既存のHBM実装をただちに置き換える量産製品ではありません。サムスンはコンセプトモデルとして公開しており、商用化の時期は発表していません。13
14
サムスンが掲げる性能・効率の目標
サムスンは、zHBMを組み込む次世代インターフェースについて、従来のHBM5に対して以下の水準を目標として示しています。
さらにAI Infrastructure Summitでは、AIシステムの応答速度を10倍超に引き上げ、毎秒1,000トークンを目指す考えが示されました。1
9
重要なのは、これらが市販アクセラレーターで第三者検証済みのベンチマークではなく、将来アーキテクチャに関するサムスンの目標値・見通しだという点です。メモリーをロジックの直上に積むには、量産歩留まり、放熱、信頼性、アクセラレーターパートナー側での検証をすべて成立させなければなりません。
AIエージェントで重要になる理由
AIエージェントは、単に一度文章を生成するだけではありません。文脈を読み出し、推論し、外部ツールを呼び出し、結果を受け取って次の処理へ進む――という反復処理を行います。そのため、演算器がデータ待ちになる時間は、体感的な応答遅延に直結します。
zHBMは、アクセラレーターに隣接する最速のメモリー層をさらに近づけ、メモリーアクセスとデータ転送のボトルネックを抑える設計です。サムスンの主張では、これにより帯域幅とデータ移動時の電力効率を改善できます。1
7
一方で、実際のエージェントの応答時間は、メモリー配置だけで決まるわけではありません。アクセラレーター設計、ソフトウェア、モデル構造、パッケージングを含むシステム全体の最適化が必要です。
zNAND-Oは「容量」を担う別の階層
サムスンはzHBMと同時に、データ集約型処理やエッジAIを想定した高性能NANDアーキテクチャ「zNAND-O」も提示しました。zNAND-Oは、DRAMと従来型NANDストレージの間を埋める新しいデータ層として位置付けられています。DRAMより高いビット密度を持ちつつ、従来NANDと比べてI/O性能、レイテンシー、電力効率の改善を狙います。49
51
両者の役割は異なります。
サムスンは、1,200億パラメーターのGPTモデルを用いたテストで、zNAND-Oが従来DRAMサーバーと同等の毎秒トークン数を、運用コスト6分の1で達成したと説明しています。ただし、これは同社が報告した特定条件でのテスト結果であり、大規模モデル運用全般で同じコスト削減を保証するものではありません。54
55
同社は、2030年には1兆パラメーター規模のオンデバイスAIが課題になり得るとの見方も示しています。53
CXLはHBMの代替ではなく、補完層になりそうだ
同サミットでは、メモリー容量を増やせる技術と、AI実行に必要な高速メモリーは同じではない、という点も浮き彫りになりました。
OpenAIでAIアクセラレーター設計を担当するDaniel Morris氏は、AIモデルを実際に動かす用途でCXL(Compute Express Link)の活用例を見いだせていないと述べる一方、大規模モデルで使用頻度の低いデータには役割があり得るとしました。IntelのVidia Thiagarajan氏も、CXLによるメモリープーリングはHBMの代替ではなく、二次ストレージを補うものだと説明し、CXL接続メモリーとHBMの帯域幅の差を指摘しました。18
22
これはCXLが不要という意味ではありません。AIシステムは今後、用途別の階層構造へ向かう可能性が高いことを示します。すなわち、実行中の計算にはアクセラレーター直近のHBMを使い、容量が必要でアクセス頻度が比較的低いデータにはCXLやストレージ層を使う、という分担です。
SamsungとSK hynixにとって何を意味するか
短期的なHBM競争を決めるのは、斬新な構想を示せるかだけではありません。特定のアクセラレータープラットフォーム向けに、十分な歩留まりで製造し、品質認定を通過させ、量産出荷できるかが決定的です。
zHBMはサムスンに長期的な差別化の軸を与えますが、直接積層という難しい実装を量産へ落とし込むには、熱設計、信頼性、歩留まり、顧客との統合検証を証明する必要があります。CXLがアクティブなAI実行でローカルHBMを置き換えにくいとの見方が強まれば、SK hynixを含むHBM供給各社にとって、アクセラレーター近傍の高帯域メモリーの重要性は引き続き高いままです。18
33
36
競争の焦点は、「最も大胆な3Dメモリー構想を持つのはどこか」だけではありません。先端パッケージ技術とメモリー技術を、顧客が採用できる認定済みの量産製品へ最も早く転換できる企業が優位に立ちます。
まとめ
zHBMが示すのは、AIの性能制約が演算能力だけではなく、メモリー移動、容量、電力、熱にも広がっているという現実です。サムスンは、HBMをAIアクセラレーターの直上に置く3D設計で高速処理経路を強化し、zNAND-Oでより大きなAIモデルを支える容量層を補完しようとしています。
掲げられた性能向上は大きいものの、zHBMはまだコンセプト段階です。AIインフラの導入を検討する側にとって直近の要点は、zHBM製品がすぐ手に入るかではなく、AIメモリーが今後、より専門化され、垂直統合された複数の階層へ進む可能性です。その中で、最高性能の計算経路におけるHBMの重要性は、なお大きいとみられます。13
14
18
Studio Global AI
研究を続けてください
このページにはソースに裏付けされた回答が含まれており、Studio Global 内で続行できます。
人々も尋ねます
「Samsung「zHBM」とは?AIチップ直上にHBMを積む3Dメモリー構想を解説」の短い答えは何ですか?
zHBMは、AIアクセラレーターの横ではなく直上にHBMを積層し、データ移動距離を縮める3Dメモリーアーキテクチャだ。
最初に検証する重要なポイントは何ですか?
zHBMは、AIアクセラレーターの横ではなく直上にHBMを積層し、データ移動距離を縮める3Dメモリーアーキテクチャだ。 サムスンは、次世代インターフェースでHBM5比約8倍の性能、10倍超のメモリー密度、約3倍の電力効率、熱抵抗50%超の低減を目標に掲げる。
次の実践では何をすればいいでしょうか?
OpenAIとIntelの技術者は、CXLは大容量・低頻度データ向けの補完層にはなり得ても、AIモデルの実行時にHBMを置き換えるものではないとの見方を示した。
情報源
asiae.co.kr"Opening the Era of 1,000 Tokens per Second"…Samsung Electronics Drives AI Semiconductor Innovation with zHBM
en.sedaily.comSamsung Touts 10-Fold AI Speed Gain With Stacked zHBM Memory
koreaherald.comSamsung stacks HBM atop AI chips in 3D memory push
semiconductor.samsung.comSamsung Unveils Next-Gen 3D-Memory Vision at FMS ...