答え公開済み15 ソース
AIの「モデル崩壊」とは何か
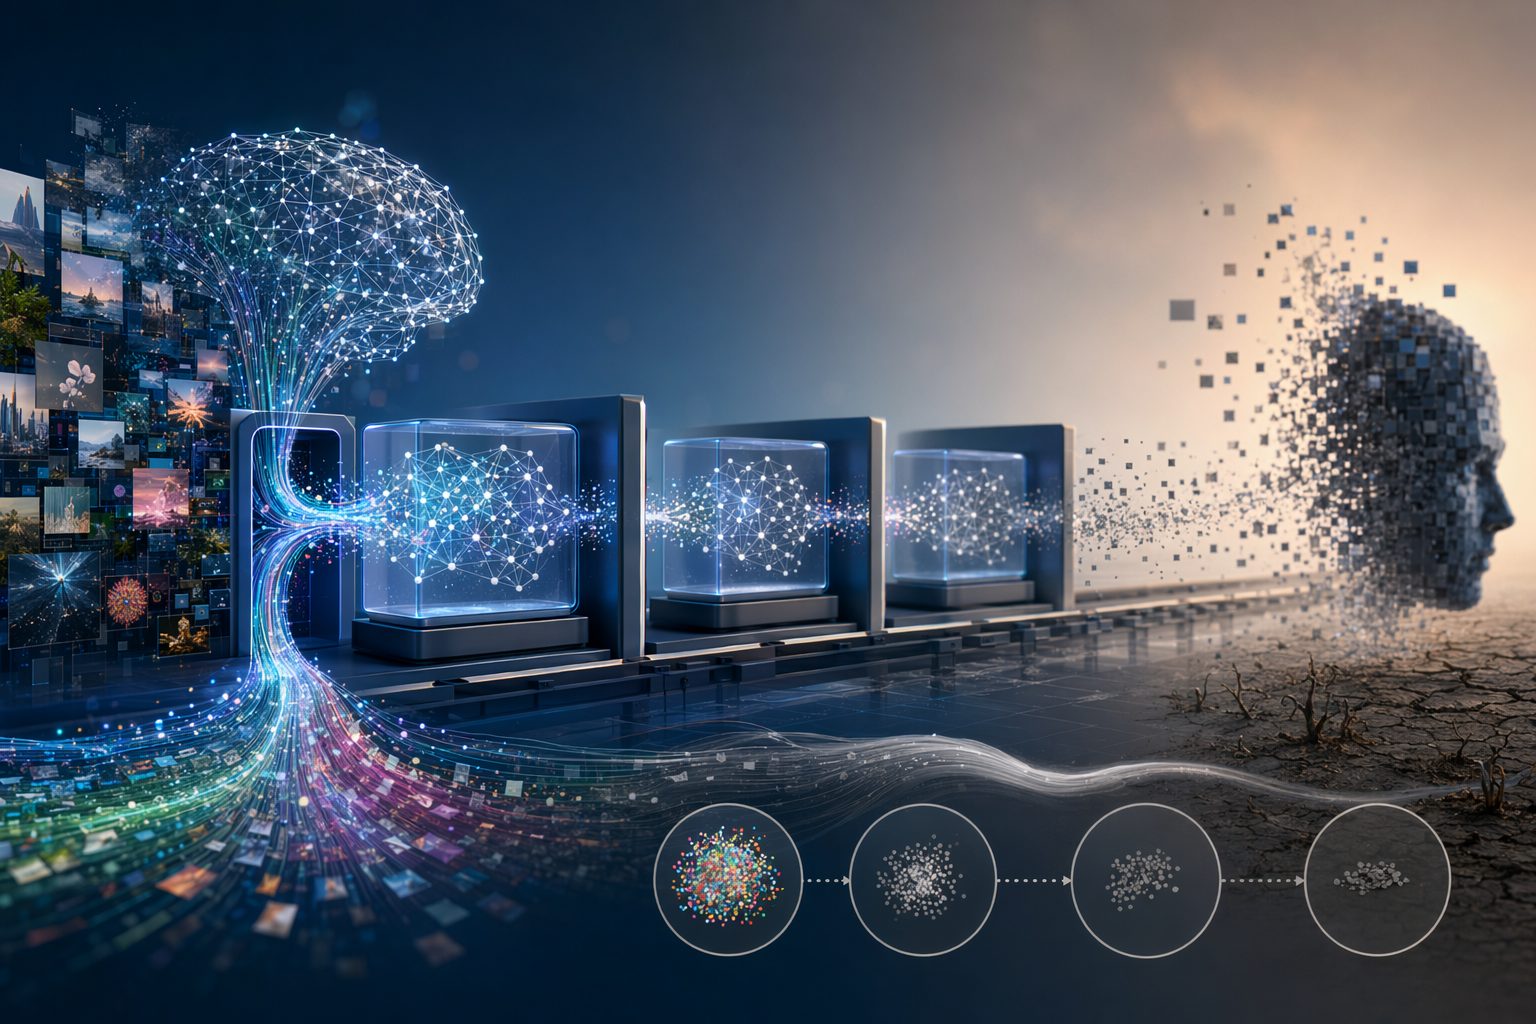
AIが生成したデータでAIを繰り返し訓練すると「モデル崩壊」が起こり、データ分布の珍しいパターンが消えてモデルの表現力が低下することが研究で示されている。[1][4] 再帰的な学習ではサンプリングの偏りが増幅され、分布の“裾(まれな事例)”が徐々に消えていくため、後続モデルはそれらを学習できなくなる。[1][9] 分析研究では、少量の実世界データやモデルに組み込まれた事前知識がアンカーとして機能し、合成データが大多数でも崩壊を防ぐ可能性が示唆されている。[7][33]
公開者GPT-5.5 で編集GPT Image 2 で画像を生成
研究の答え
重要なポイント
- AIが生成したデータでAIを繰り返し訓練すると「モデル崩壊」が起こり、データ分布の珍しいパターンが消えてモデルの表現力が低下することが研究で示されている。[1][4]
- 再帰的な学習ではサンプリングの偏りが増幅され、分布の“裾(まれな事例)”が徐々に消えていくため、後続モデルはそれらを学習できなくなる。[1][9]
- 分析研究では、少量の実世界データやモデルに組み込まれた事前知識がアンカーとして機能し、合成データが大多数でも崩壊を防ぐ可能性が示唆されている。[7][33]
AI プロンプト
openai.comCreate a landscape editorial hero image for this Studio Global article: What does the new study on AI model collapse find about preventing degradation when models are trained on synthetic data, why does recursive. Article summary: The study describes model collapse as a failure mode where recursively trained generative models lose information about the original data distribution, especially its rare or low-probability regions.. Topic tags: general, government, education, academic, general web. Reference image context from search candidates: Reference image 1: visual subject "However, as AI-generated data increasingly populates the internet, an important question arises: What happens when new AI models are trained on datasets containing their previous o" source context "Avoiding Model Collapse in AI Training - Risk Insight" Reference image 2: visual subject "Artificial intelligence models
生成AIの学習では、**AIが作ったデータ(合成データ)**を使うケースが増えています。効率的にデータ量を増やせる一方で、研究者が警告しているのが「モデル崩壊(model collapse)」と呼ばれる現象です。これは、AIがAIの出力を学習し続けることで、現実のデータ分布の多様性を徐々に失っていく問題を指します。
研究によると、モデルを合成データだけで再帰的に訓練すると、元のデータに存在していた珍しいパターンが次第に消えていくことが分かっています。こうした欠落が積み重なると、モデルが世界を表現する能力そのものが歪んでしまいます。
Studio Global AI
研究を続けてください
このページにはソースに裏付けされた回答が含まれており、Studio Global 内で続行できます。
人々も尋ねます
「AIの「モデル崩壊」とは何か」の短い答えは何ですか?
AIが生成したデータでAIを繰り返し訓練すると「モデル崩壊」が起こり、データ分布の珍しいパターンが消えてモデルの表現力が低下することが研究で示されている。[1][4]
最初に検証する重要なポイントは何ですか?
AIが生成したデータでAIを繰り返し訓練すると「モデル崩壊」が起こり、データ分布の珍しいパターンが消えてモデルの表現力が低下することが研究で示されている。[1][4] 再帰的な学習ではサンプリングの偏りが増幅され、分布の“裾(まれな事例)”が徐々に消えていくため、後続モデルはそれらを学習できなくなる。[1][9]
次の実践では何をすればいいでしょうか?
分析研究では、少量の実世界データやモデルに組み込まれた事前知識がアンカーとして機能し、合成データが大多数でも崩壊を防ぐ可能性が示唆されている。[7][33]
情報源
pmc.ncbi.nlm.nih.govAI models collapse when trained on recursively generated data - PMC
pure.ed.ac.uk[PDF] AI models collapse when trained on recursively generated data
openreview.net[PDF] How Bad is Training on Synthetic Data? A Statistical Analysis of ...
techxplore.comA single real-world data point may stop AI model collapse, analysis suggests