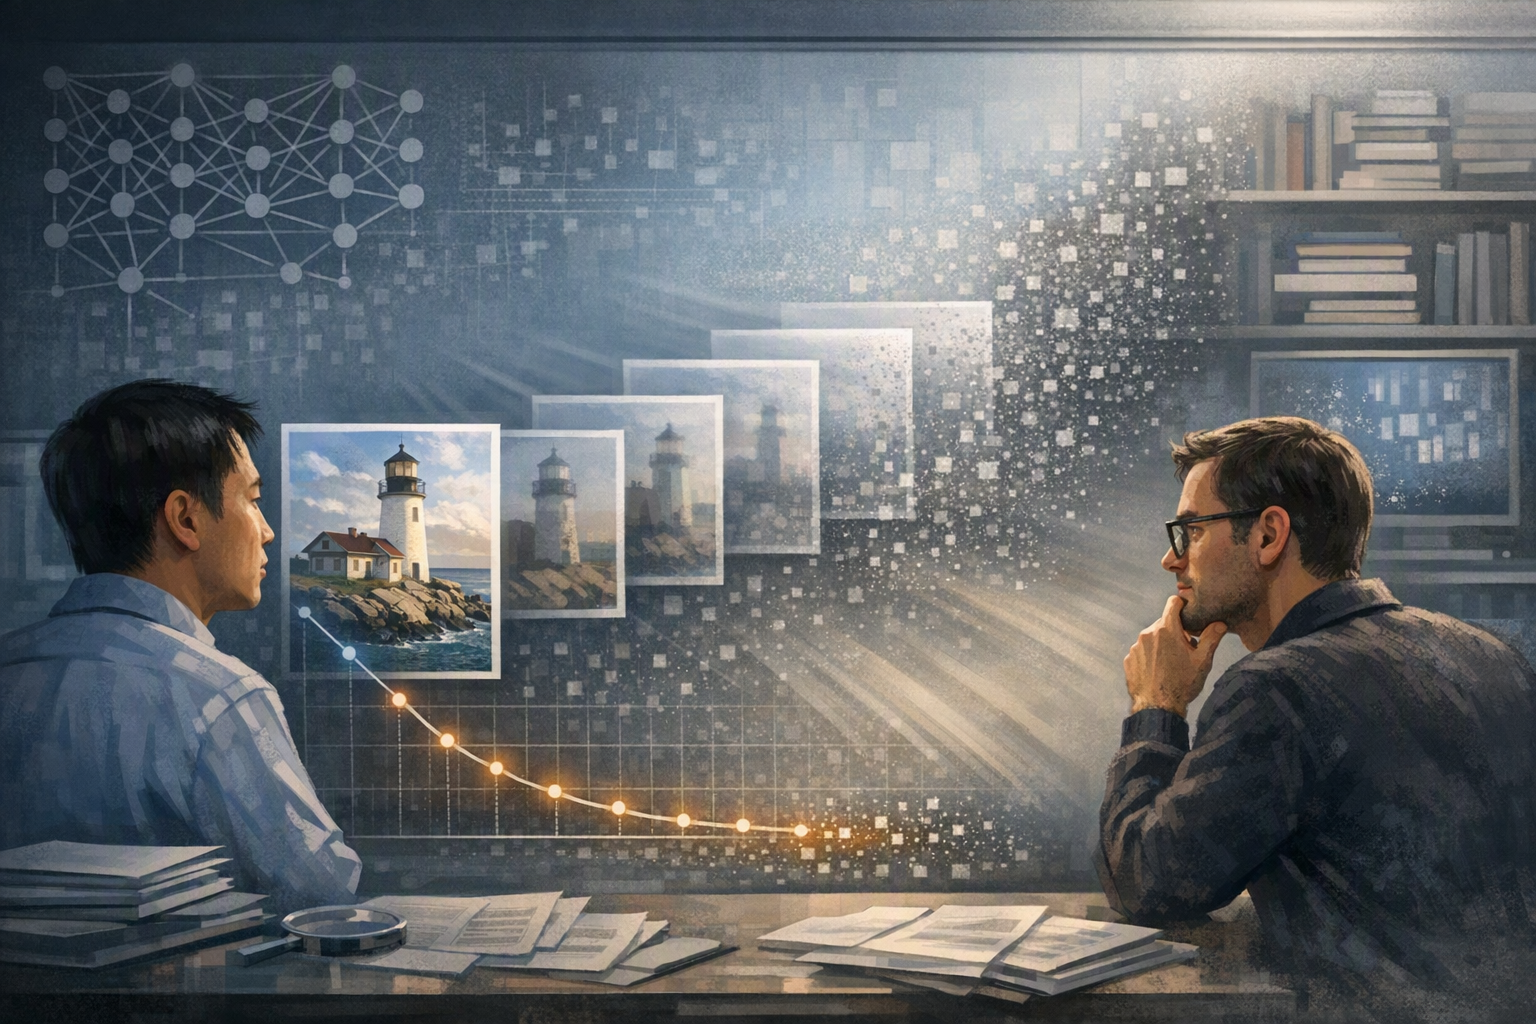
Attribution decay: perché le immagini generate dall’AI diventano più difficili da ricondurre ai dati di addestramento
In uno studio del 2026 su 24 ensemble di diffusione e sette raccolte pubbliche, con dataset da 256 a oltre 160.000 immagini, Zheng Dai e David Gifford hanno osservato che l’influenza causale di una singola immagine te... I ricercatori hanno usato un’architettura di diffusion ensemble per rimuovere l’influenza di imm...
Pubblicato daModificato con GPT-5.6 LunaImmagini generate con GPT Image 1.5
In uno studio del 2026 su 24 ensemble di diffusione e sette raccolte pubbliche, con dataset da 256 a oltre 160.000 immagini, Zheng Dai e David Gifford hanno osservato che l’influenza causale di una singola immagine te...
I ricercatori hanno usato un’architettura di diffusion ensemble per rimuovere l’influenza di immagini selezionate senza riaddestrare ogni volta un modello completo, confrontando poi l’output originale con versioni con...
Su dataset sufficientemente grandi, anche la rimozione dell’intero corpus di un artista o di tutte le fotografie raffiguranti una determinata persona poteva lasciare il risultato generato sostanzialmente invariato nel...
La scoperta può complicare alcune cause sul copyright, ma non dimostra che un modello non abbia memorizzato un’opera, non possa riprodurla o non l’abbia copiata.
What did Zheng Dai and David Gifford’s MIT CSAIL study, published in Nature Communications, discover about “attribution decay” in diffusion-Attribution decay describes how a diffusion model’s output becomes harder to link to any single training image as the dataset grows.
AI Prompt
Create a landscape editorial hero image for this Studio Global article: What did Zheng Dai and David Gifford’s MIT CSAIL study, published in Nature Communications, discover about “attribution decay” in diffusion-. Article summary: Dai and Gifford found “attribution decay”: as a diffusion image generator is trained on more data, the causal effect of any one training item on a particular generated image can shrink until it is too small to detect. Th. Topic tags: general, education, general web, user generated, government. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, wat
openai.com
Un’immagine generata dall’intelligenza artificiale può diventare sempre più difficile da ricondurre a una singola fonte man mano che il modello viene addestrato su dataset più grandi. È il fenomeno che i ricercatori del Computer Science and Artificial Intelligence Laboratory (CSAIL) del MIT chiamano attribution decay, cioè “decadimento dell’attribuzione”.
Il risultato non significa che il modello non abbia mai visto un’immagine, che non possa riprodurla o che sia automaticamente al riparo da rischi di copyright. Descrive un dato tecnico più circoscritto: in un test controllato di rimozione, una determinata unità di addestramento può non essere più necessaria per ottenere uno specifico risultato.
Come è stata misurata l’influenza dei dati di addestramento
I metodi tradizionali di analisi dell’influenza cercano generalmente di stimare quanto un esempio di addestramento abbia contribuito al comportamento di un modello. Zheng Dai e David Gifford hanno seguito un approccio diverso, progettando un diffusion ensemble che consente di costruire un confronto controfattuale controllato.
Studio Global AI
Continue your research
This page includes a source-backed answer you can continue inside Studio Global.
What is the short answer to "Attribution decay: perché le immagini generate dall’AI diventano più difficili da ricondurre ai dati di addestramento"?
In uno studio del 2026 su 24 ensemble di diffusione e sette raccolte pubbliche, con dataset da 256 a oltre 160.000 immagini, Zheng Dai e David Gifford hanno osservato che l’influenza causale di una singola immagine te...
What are the key points to validate first?
In uno studio del 2026 su 24 ensemble di diffusione e sette raccolte pubbliche, con dataset da 256 a oltre 160.000 immagini, Zheng Dai e David Gifford hanno osservato che l’influenza causale di una singola immagine te... I ricercatori hanno usato un’architettura di diffusion ensemble per rimuovere l’influenza di immagini selezionate senza riaddestrare ogni volta un modello completo, confrontando poi l’output originale con versioni con...
What should I do next in practice?
Su dataset sufficientemente grandi, anche la rimozione dell’intero corpus di un artista o di tutte le fotografie raffiguranti una determinata persona poteva lasciare il risultato generato sostanzialmente invariato nel...
L’ensemble è formato da componenti addestrati in modo indipendente. Ogni componente viene esposto a una porzione attentamente progettata dei dati complessivi. In questo modo i ricercatori possono chiedersi: che cosa avrebbe generato il modello se questa immagine non avesse influenzato l’addestramento?
Invece di riaddestrare da zero un unico modello di grandi dimensioni, possono disattivare i componenti che avevano visto l’immagine selezionata e produrre un output di confronto. Si tratta quindi di un’ablazione dell’influenza dell’immagine, non soltanto di una sua stima approssimativa.
Il gruppo ha valutato 24 diffusion ensemble su sette raccolte pubbliche di immagini. I dataset andavano da 256 immagini a oltre 160.000, permettendo di osservare come cambiasse l’attribuzione all’aumentare della quantità di dati. Per ogni prova, i ricercatori hanno confrontato una generazione originale con versioni controfattuali ottenute omettendo le unità di addestramento candidate.
La maggiore differenza misurata tra l’output originale e quelli controfattuali è stata definita counterfactual radius, ovvero “raggio controfattuale”. Questa misura indica quanto una singola unità rimossa possa modificare il risultato.
Che cosa significa “attribution decay”
Il raggio controfattuale diminuiva man mano che crescevano i dataset. In termini pratici, rimuovere una singola immagine produceva sempre più spesso un risultato difficile da distinguere dall’originale secondo la metrica usata nello studio.
L’implicazione è controintuitiva: aggiungere più dati di addestramento può rendere un’immagine generata meno attribuibile a un singolo esempio, anche quando quell’esempio faceva parte del dataset. Il modello può apprendere schemi generali e sovrapposti da molte fonti, invece di dipendere da una sola immagine identificabile per generare un determinato risultato.
A scale sufficientemente grandi, l’effetto non riguardava soltanto le singole immagini. Secondo lo studio, rimuovere tutte le immagini di un artista o tutte le fotografie raffiguranti una determinata persona poteva lasciare il campione generato sostanzialmente invariato nell’ambito del test controfattuale.
Per questo i ricercatori parlano di “decadimento” e non di una semplice incapacità degli strumenti di rilevazione. Il problema potrebbe non essere soltanto la mancanza di un metodo abbastanza potente: la connessione causale tra una fonte e uno specifico output può diventare così diffusa da non poter più essere isolata.
Possibili conseguenze per le cause sul copyright
L’attribution decay potrebbe rendere più difficile dimostrare una particolare teoria alla base di una causa: quella secondo cui un output contestato sarebbe stato causato direttamente dalle opere di un artista identificato, o dalle copie di quelle opere presenti nei dati di addestramento.
Se la rimozione dell’intero archivio di un artista non modifica in modo rilevante l’output, diventa più complicato sostenere che quel corpus fosse individualmente necessario per produrre proprio quell’immagine secondo questo test causale. La scoperta può quindi complicare alcuni contenziosi sulla proprietà intellettuale che coinvolgono generatori di immagini e accuse di imitazione dello stile degli artisti.
Ma lo studio non stabilisce se un’azienda abbia violato il copyright e non costituisce, da solo, una difesa legale. Una controversia può riguardare questioni diverse: se le opere protette siano state copiate durante l’addestramento, se un output sia sostanzialmente simile a un’opera tutelata, che cosa il sistema riesca a riprodurre con determinati prompt, quali danni siano stati causati o quali obblighi contrattuali si applichino.
In breve, “non attribuibile” in senso tecnico non equivale a “non copiato” in senso giuridico.
Perché il risultato non dimostra che i modelli non memorizzino
L’esperimento misura la sensibilità del modello alla rimozione di specifiche unità di addestramento. Non verifica ogni possibile forma di conservazione o riproduzione delle informazioni.
Un modello può mostrare una dipendenza minima da una singola immagine nel test di cancellazione dell’ensemble e, allo stesso tempo, riprodurre un’opera in risposta a determinati prompt o con specifiche condizioni di campionamento. Un output può inoltre ricordare un’opera protetta anche quando nessuna singola immagine di addestramento risulta causalmente indispensabile per generarlo.
Sono quindi tre affermazioni diverse:
“Questa immagine ha influenzato l’output”: il test di rimozione rileva un cambiamento misurabile quando l’influenza dell’immagine viene eliminata.
“Il modello ha visto o conservato l’immagine”: il modello è stato esposto all’immagine o potrebbe averne memorizzato alcuni aspetti.
“L’output copia un’opera protetta”: è una conclusione tecnica e giuridica che richiede ulteriori elementi.
L’attribution decay riguarda direttamente la prima domanda. Non risolve la seconda né la terza.
Il risultato non si applica ancora ai grandi modelli linguistici
Lo studio riguarda modelli generativi di diffusione per immagini e media audiovisivi correlati. L’architettura a ensemble e il comportamento osservato con l’aumento della scala non possono essere estesi automaticamente ai grandi modelli linguistici basati su Transformer.
I modelli linguistici hanno architetture, procedure di addestramento, rappresentazioni in token e modalità di generazione differenti. Il lavoro può indicare una direzione utile per future ricerche sull’attribuzione, ma non dimostra che lo stesso tipo di decadimento si verifichi anche negli LLM.
Quali prove servirebbero ancora
Quando si cerca di stabilire se un sistema AI abbia copiato un’opera, l’attribution decay è soltanto uno degli elementi da esaminare. I tribunali e gli analisti tecnici potrebbero dover valutare anche:
la capacità del sistema di riprodurre un’opera specifica con prompt controllati;
la somiglianza visiva tra l’output e l’opera contestata;
la provenienza dei dati, l’accesso alle opere e i documenti relativi all’addestramento;
i risultati degli audit del modello e la documentazione del sistema;
se l’output rifletta uno stile generale o un’espressione protetta e identificabile;
gli standard giuridici applicabili alla controversia specifica.
La lezione centrale dello studio è più precisa — e più utile — dell’idea che l’AI “dimentichi” le proprie fonti. Quando i dataset di diffusione crescono, il contributo causale dei singoli esempi può diventare troppo diffuso per essere rilevato in un determinato output. Questo rende più difficile attribuire un’immagine a una fonte, ma non rende impossibili le analisi su memoria, riproduzione o copyright.
semafor.comGenerative AI outputs are unattributable, study finds - Semafor