AnswersPublished26 sources
Samsung zHBM: perché mettere l’HBM direttamente sopra i chip AI può cambiare l’infrastruttura dell’intelligenza artificiale
Samsung sostiene che zHBM potrebbe aumentare di oltre dieci volte la velocità di risposta dei sistemi AI, impilando la memoria HBM direttamente sopra l’acceleratore anziché accanto ad esso. Per una futura interfaccia con zHBM, l’azienda indica circa 8 volte le prestazioni di HBM5, oltre 10 volte la densità di memori...
Pubblicato daModificato con GPT-5.6 TerraImmagini generate con GPT Image 2
Research answer
Key takeaways
- Samsung sostiene che zHBM potrebbe aumentare di oltre dieci volte la velocità di risposta dei sistemi AI, impilando la memoria HBM direttamente sopra l’acceleratore anziché accanto ad esso.
- Per una futura interfaccia con zHBM, l’azienda indica circa 8 volte le prestazioni di HBM5, oltre 10 volte la densità di memoria, 3 volte l’efficienza energetica e più del 50% di resistenza termica in meno.
- Secondo interventi di ricercatori di OpenAI e Intel, CXL può aggiungere capacità e gestire dati poco usati, ma non appare un sostituto dell’HBM per l’esecuzione attiva dei modelli AI.
AI Prompt
openai.comCreate a landscape editorial hero image for this Studio Global article: What did Samsung Electronics reveal at the September 16, 2026, AI Infrastructure Summit about its next-generation zHBM 3D memory architectur. Article summary: Samsung presented zHBM as a longer-term “zero-distance” HBM architecture: rather than placing HBM beside an AI accelerator on a silicon interposer, as in current 2.5D packages, it would bond HBM directly above the accele. Topic tags: general, general web, user generated, news. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts w
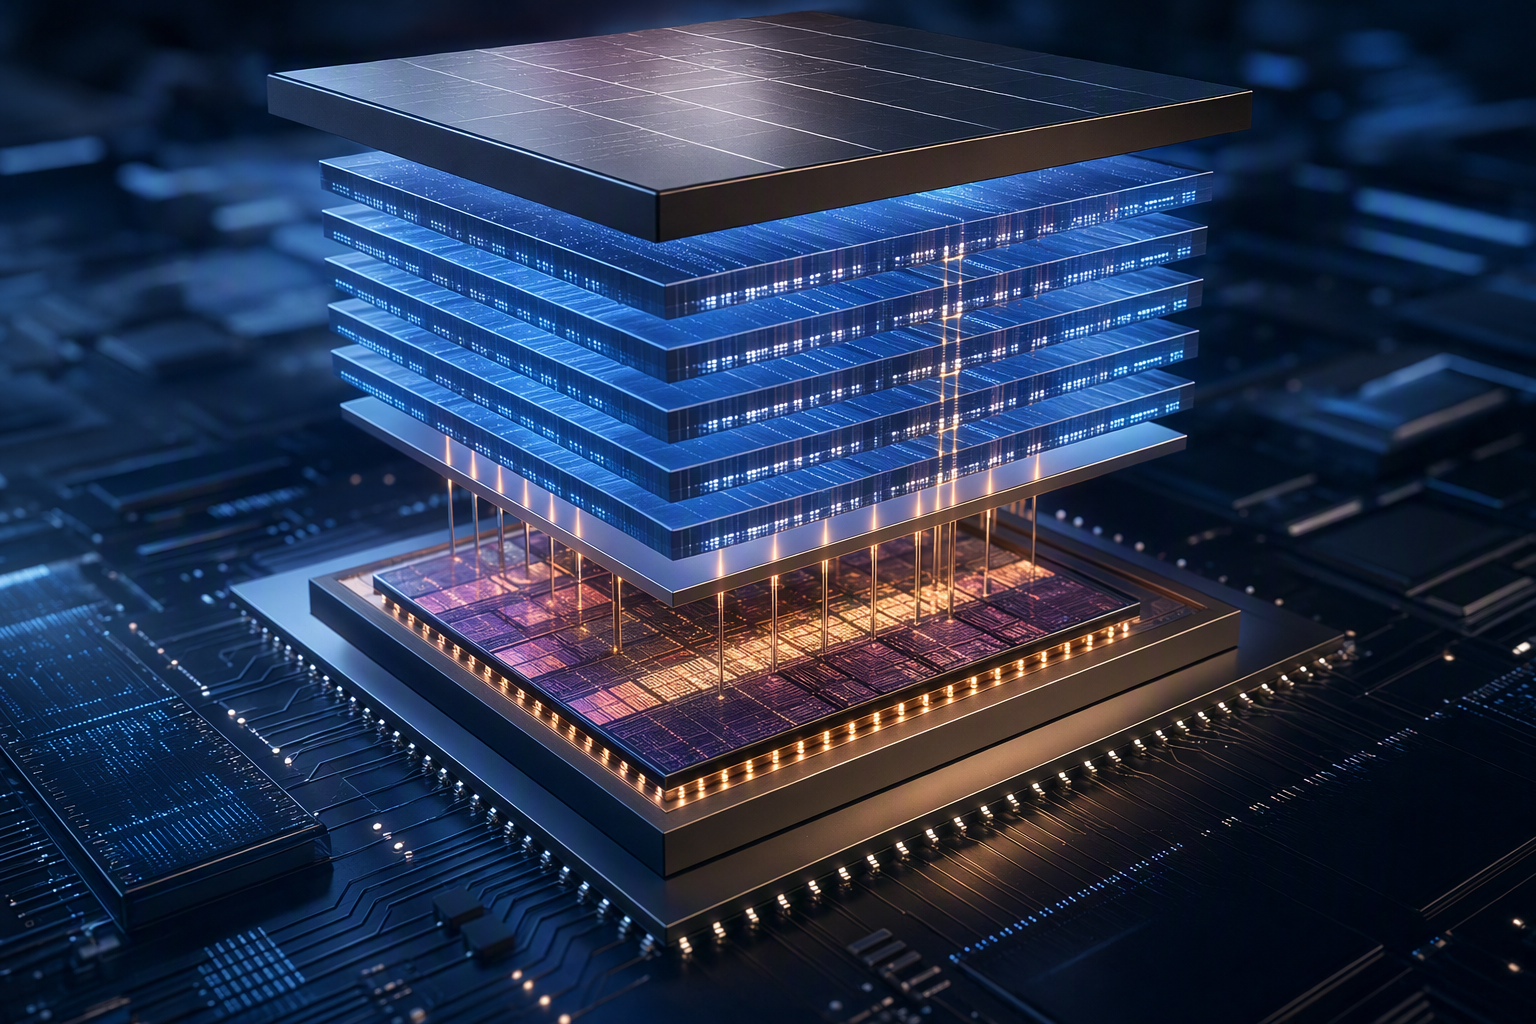
Samsung vuole ridurre al minimo la distanza fisica tra il calcolo AI e la sua memoria più veloce. Con zHBM, la High Bandwidth Memory (HBM) non verrebbe più collocata accanto a una GPU o a un altro acceleratore: sarebbe invece impilata direttamente sopra il processore, in un package 3D integrato verticalmente.
Al summit AI Infrastructure del 16 settembre a Santa Clara, in California, l’azienda ha presentato questa impostazione come una possibile risposta ai requisiti di reattività dell’AI agentica: sistemi che devono richiamare contesto, svolgere inferenza, usare strumenti e generare risposte in cicli rapidi. 1
9
Cosa cambia rispetto ai package HBM attuali
Nei package HBM oggi più diffusi, la memoria ad alta larghezza di banda è posta sullo stesso piano dell’acceleratore e collegata tramite tecniche di packaging avanzato, spesso definite 2,5D. L’idea di zHBM è diversa: collocare fisicamente gli stack HBM sopra l’acceleratore AI, creando un’integrazione verticale fra logica e memoria. 12
13
Il principio è semplice: se i dati devono percorrere una distanza minore, si possono aumentare la larghezza di banda disponibile e l’efficienza energetica, oltre a inserire più capacità nello stesso ingombro. Samsung indica come tecnologia abilitante il bonding di nuova generazione dei wafer, incluso l’Hybrid Copper Bonding, cioè il collegamento ibrido in rame ad alta precisione. 7
48
È importante distinguere il progetto da un prodotto già pronto: Samsung ha mostrato zHBM come modello concettuale e non ha comunicato una tempistica per la commercializzazione. 13
14
Le promesse di prestazioni, densità ed efficienza
Samsung attribuisce a una futura interfaccia basata su zHBM obiettivi molto ambiziosi rispetto alla HBM5 convenzionale:
- circa 8 volte le prestazioni;
- oltre 10 volte la densità di memoria;
- circa 3 volte l’efficienza energetica;
- più del 50% in meno di resistenza termica.
13
48
Durante l’AI Infrastructure Summit, Samsung ha inoltre dichiarato che l’architettura potrebbe aumentare di oltre dieci volte la velocità di risposta dei sistemi AI, con l’obiettivo indicato di arrivare a 1.000 token al secondo. 1
9
Sono però previsioni dell’azienda su un’architettura futura, non benchmark indipendenti ottenuti da un acceleratore commerciale. Portare la memoria direttamente sopra la logica richiede infatti rese produttive elevate, una gestione termica efficace, affidabilità nel tempo e qualifiche con i partner che realizzano gli acceleratori.
Perché l’AI agentica rende centrale il problema della memoria
Aumentare la potenza di calcolo non elimina automaticamente i tempi d’attesa: un acceleratore può restare vincolato al trasferimento dei dati necessari per lavorare. Questo limite diventa particolarmente rilevante per gli agenti AI, che accedono ripetutamente a contesto, memoria e strumenti esterni.
zHBM punta proprio a ridurre il collo di bottiglia della movimentazione dei dati, avvicinando l’HBM all’acceleratore. L’obiettivo è rendere il sistema più reattivo e ridurre l’energia richiesta per spostare le informazioni. 1
7
Il guadagno effettivo sull’esperienza finale, tuttavia, non dipenderà solo dalla posizione della memoria: conteranno anche acceleratore, software, modello AI e progettazione complessiva del package.
zNAND-O: il livello di capacità complementare
Samsung ha affiancato a zHBM zNAND-O, un’architettura NAND ad alte prestazioni pensata per ambienti edge AI e carichi di lavoro ricchi di dati. La sua collocazione prevista è intermedia fra DRAM e NAND tradizionale: maggiore densità rispetto alla DRAM, ma migliori prestazioni I/O, latenza ed efficienza energetica rispetto alla NAND convenzionale. 49
51
I due progetti non svolgono quindi lo stesso compito nella gerarchia di memoria:
- zHBM sarebbe il livello più veloce, strettamente vicino all’acceleratore;
- zNAND-O servirebbe come livello più denso per dati e modelli che sarebbe costoso conservare interamente nella DRAM.
49
53
Samsung ha citato un test con un modello GPT da 120 miliardi di parametri nel quale zNAND-O avrebbe raggiunto gli stessi token al secondo di un server DRAM convenzionale, con un costo operativo pari a un sesto. Si tratta di un risultato riportato da Samsung per quel test, non di una garanzia generale sui costi dei grandi modelli. 54
55
L’azienda collega zNAND-O anche alla sfida più lontana nel tempo dell’AI locale: secondo Samsung, modelli on-device dell’ordine di mille miliardi di parametri potrebbero diventare rilevanti entro il 2030. 53
CXL non sembra destinata a rimpiazzare l’HBM nei calcoli attivi
Il summit ha evidenziato un punto essenziale: avere più capacità di memoria non significa che tutti i livelli di memoria siano intercambiabili.
Daniel Morris, ricercatore di OpenAI sugli acceleratori, ha affermato di non aver individuato un caso d’uso per CXL nell’esecuzione effettiva dei modelli AI, pur vedendo un possibile ruolo per dati poco utilizzati nei modelli di grandi dimensioni. Vidia Thiagarajan di Intel ha descritto il pooling della memoria tramite CXL come un complemento allo storage secondario, non come un sostituto dell’HBM, richiamando il divario di banda tra memoria collegata via CXL e HBM. 18
22
CXL, acronimo di Compute Express Link, resta quindi utile per espandere o condividere capacità in determinate architetture. Ma il quadro che emerge è quello di una memoria a livelli: HBM accanto all’acceleratore per i calcoli sensibili alla banda, CXL e altri livelli di memoria o storage per esigenze di capacità e dati meno “caldi”.
Cosa significa per Samsung, SK hynix e il mercato HBM
Nel breve periodo, la sfida HBM non si decide soltanto sulla qualità di un’idea tecnica. Conta soprattutto la capacità di produrre, qualificare e consegnare memoria compatibile con piattaforme di accelerazione specifiche.
zHBM offre a Samsung una proposta architetturale distintiva sul lungo periodo, ma non elimina i passaggi più difficili: dimostrare rese produttive, comportamento termico, affidabilità e integrazione con i clienti. La crescente prudenza sull’ipotesi che CXL possa sostituire l’HBM nell’esecuzione attiva rafforza invece la rilevanza dell’HBM vicina all’acceleratore. 18
33
36
Per Samsung e SK hynix, dunque, la concorrenza riguarda sia la visione tecnologica sia l’esecuzione: chi riuscirà a trasformare packaging avanzato e nuovi design di memoria in prodotti qualificati e disponibili in volume avrà il vantaggio più concreto.
In sintesi
Il messaggio di Samsung è che le prestazioni AI dipendono sempre meno dal solo throughput di calcolo e sempre più da banda, capacità, consumo e calore della memoria. zHBM propone di affrontare questi vincoli portando l’HBM direttamente sopra l’acceleratore; zNAND-O aggiungerebbe un livello più denso per modelli e dataset di grandi dimensioni.
Le cifre indicate sono rilevanti, ma per ora restano obiettivi di una tecnologia in fase concettuale. La conclusione pratica per chi pianifica infrastrutture AI è soprattutto una: i sistemi futuri probabilmente useranno livelli di memoria sempre più specializzati e integrati verticalmente, con l’HBM ancora al centro del percorso di calcolo ad alte prestazioni. 13
14
18
Studio Global AI
Continue your research
This page includes a source-backed answer you can continue inside Studio Global.
People also ask
What is the short answer to "Samsung zHBM: perché mettere l’HBM direttamente sopra i chip AI può cambiare l’infrastruttura dell’intelligenza artificiale"?
Samsung sostiene che zHBM potrebbe aumentare di oltre dieci volte la velocità di risposta dei sistemi AI, impilando la memoria HBM direttamente sopra l’acceleratore anziché accanto ad esso.
What are the key points to validate first?
Samsung sostiene che zHBM potrebbe aumentare di oltre dieci volte la velocità di risposta dei sistemi AI, impilando la memoria HBM direttamente sopra l’acceleratore anziché accanto ad esso. Per una futura interfaccia con zHBM, l’azienda indica circa 8 volte le prestazioni di HBM5, oltre 10 volte la densità di memoria, 3 volte l’efficienza energetica e più del 50% di resistenza termica in meno.
What should I do next in practice?
Secondo interventi di ricercatori di OpenAI e Intel, CXL può aggiungere capacità e gestire dati poco usati, ma non appare un sostituto dell’HBM per l’esecuzione attiva dei modelli AI.
Sources
asiae.co.kr"Opening the Era of 1,000 Tokens per Second"…Samsung Electronics Drives AI Semiconductor Innovation with zHBM
en.sedaily.comSamsung Touts 10-Fold AI Speed Gain With Stacked zHBM Memory
koreaherald.comSamsung stacks HBM atop AI chips in 3D memory push