AnswersPublished24 sources
Libri comprati, tagliati e distrutti per addestrare l’IA: dentro Project Panama di Anthropic
Dall’inizio del 2024 Anthropic ha portato avanti Project Panama, un’operazione costata decine di milioni di dollari per acquistare e digitalizzare milioni di libri destinati all’addestramento di Claude [2][3][8][9]. Il “destructive scanning” prevede di rimuovere meccanicamente il dorso dei volumi, scansionare rapida...
Pubblicato daModificato con DeepSeek-V4-FlashImmagini generate con GPT Image 1.5
Research answer
Key takeaways
- Dall’inizio del 2024 Anthropic ha portato avanti Project Panama, un’operazione costata decine di milioni di dollari per acquistare e digitalizzare milioni di libri destinati all’addestramento di Claude [2][3][8][9].
- Il “destructive scanning” prevede di rimuovere meccanicamente il dorso dei volumi, scansionare rapidamente le pagine e avviare al riciclo ciò che resta; gli ordini passano spesso da intermediari anonimi [4][6][7].
- Un giudice federale statunitense ha considerato legale l’uso di copie acquistate regolarmente, ma non quello di copie piratate; nel luglio 2026 è stato approvato un accordo collettivo da 1,5 miliardi di dollari [1][5]...
AI Prompt
openai.comCreate a landscape editorial hero image for this Studio Global article: What are the key details about AI companies' practice of "destructive scanning"—secretly purchasing millions of physical books through anony. Article summary: I'll research each of these claims. Topic tags: general, general web, user generated, news. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts with fake numbers, clickbait thumbnails, icons, and tiny thumbnail layouts. Make it useful as an illustrative visual, not as factual evidence.
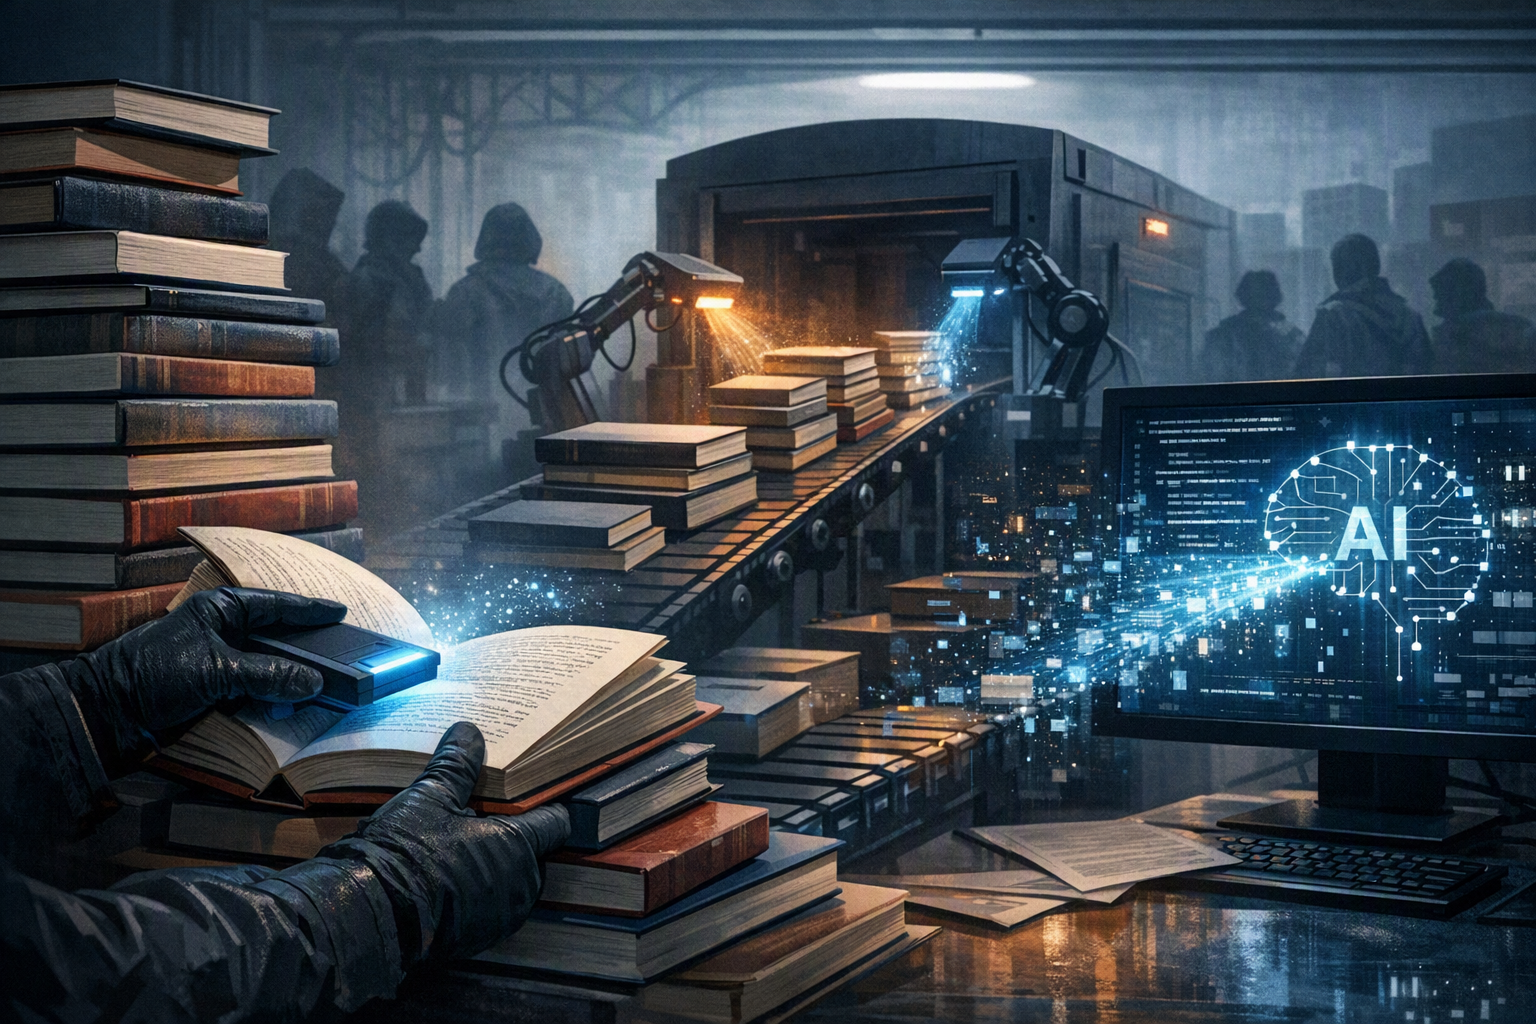
La corsa all’addestramento dei modelli di intelligenza artificiale sta dando vita a una filiera difficile da immaginare: montagne di libri usati acquistati in blocco, rilegature recise con macchinari idraulici, pagine inserite in scanner ad alta velocità e copie cartacee distrutte subito dopo la digitalizzazione.
La pratica è nota come “destructive scanning”, ovvero scansione distruttiva. Le sue dimensioni sono emerse da documenti giudiziari desecretati e da varie inchieste, con particolare attenzione al programma segreto di Anthropic, la società che sviluppa Claude.
Che cos’è la scansione distruttiva
Il procedimento nasce da un’esigenza precisa: ottenere grandi quantità di testi scritti da esseri umani, in un formato facilmente utilizzabile per addestrare i modelli linguistici di grandi dimensioni, o LLM (large language models).
Le aziende acquistano libri fisici in grandi lotti, spesso tramite intermediari che non rendono immediatamente riconoscibile il compratore finale. I volumi vengono poi inviati a strutture industriali, dove una macchina idraulica rimuove il dorso. Le pagine sciolte passano attraverso scanner ad alta velocità e i resti di carta vengono triturati o riciclati .
Studio Global AI
Continue your research
This page includes a source-backed answer you can continue inside Studio Global.
People also ask
What is the short answer to "Libri comprati, tagliati e distrutti per addestrare l’IA: dentro Project Panama di Anthropic"?
Dall’inizio del 2024 Anthropic ha portato avanti Project Panama, un’operazione costata decine di milioni di dollari per acquistare e digitalizzare milioni di libri destinati all’addestramento di Claude [2][3][8][9].
What are the key points to validate first?
Dall’inizio del 2024 Anthropic ha portato avanti Project Panama, un’operazione costata decine di milioni di dollari per acquistare e digitalizzare milioni di libri destinati all’addestramento di Claude [2][3][8][9]. Il “destructive scanning” prevede di rimuovere meccanicamente il dorso dei volumi, scansionare rapidamente le pagine e avviare al riciclo ciò che resta; gli ordini passano spesso da intermediari anonimi [4][6][7].
What should I do next in practice?
Un giudice federale statunitense ha considerato legale l’uso di copie acquistate regolarmente, ma non quello di copie piratate; nel luglio 2026 è stato approvato un accordo collettivo da 1,5 miliardi di dollari [1][5]...
Sources
dallasexpress.comAI Firms Scan Then Destroy Rare Book Editions
emeraldbook.orgWhy AI Companies Are Destroying Original Literature to Train ...
news.com.auAI labs buy, scan, shred millions of rare books
christianactivities.comThe Hidden Costs of Destroying Physical Books for AI Training Data | Christian Activities
