AnswersPublished16 sources
Un’architettura comune per analizzare otto linguaggi, senza promettere l’impossibile
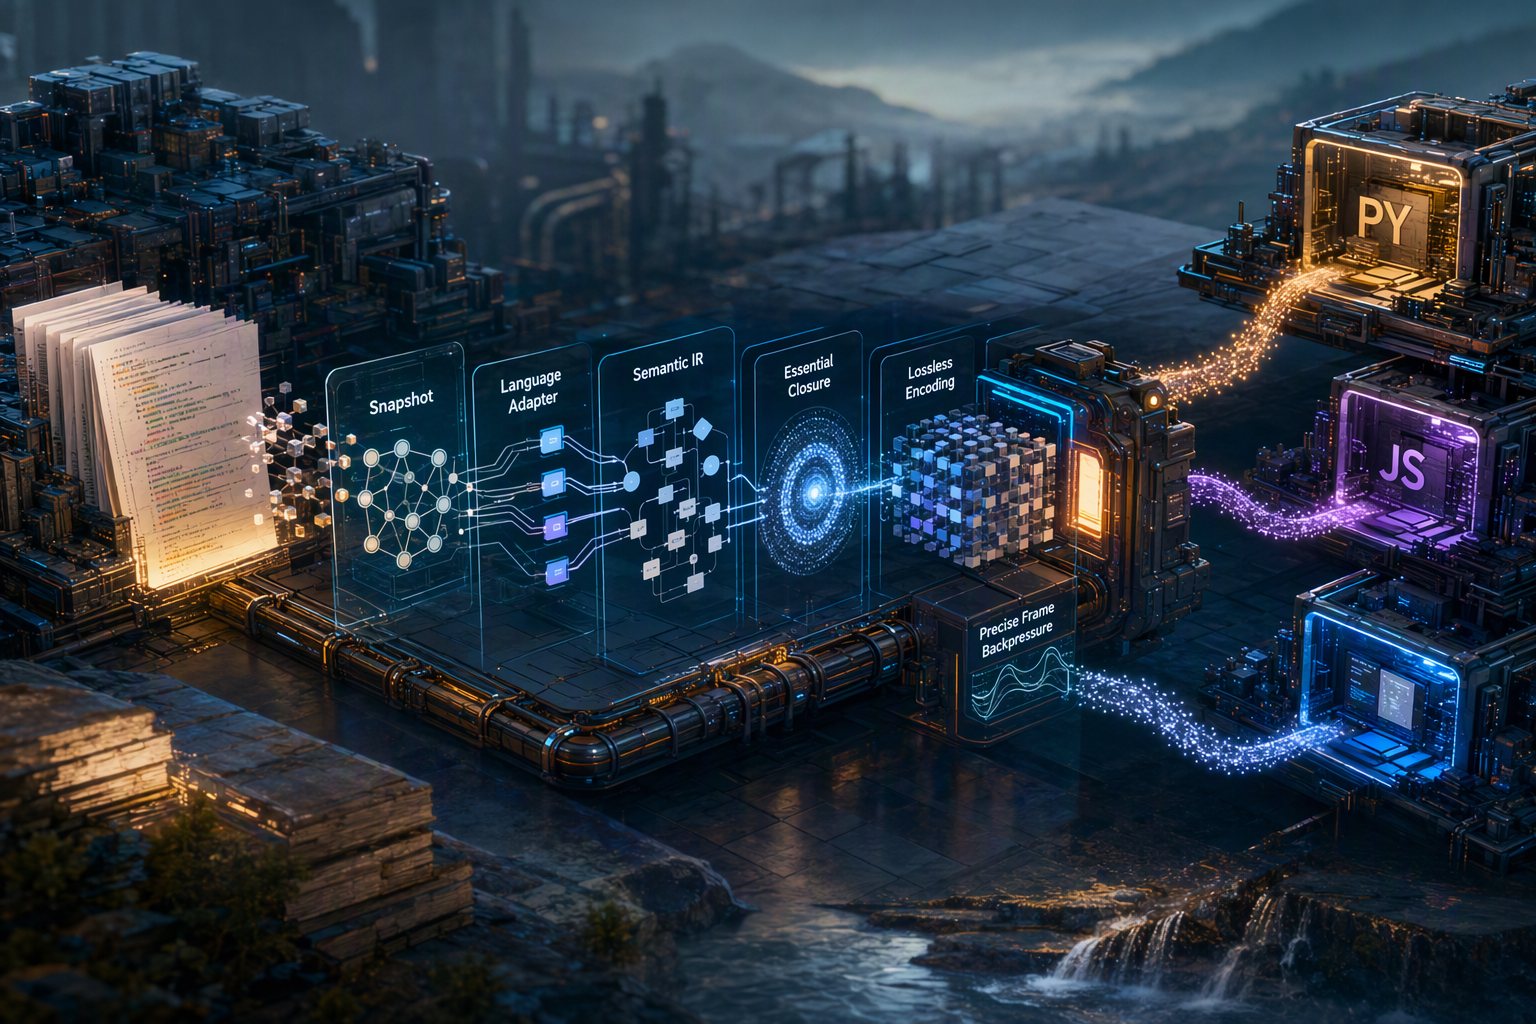
L’architettura proposta separa acquisizione in sola lettura, adattatori per linguaggio, un modello semantico comune e un nucleo che gestisce completezza e budget. Il limite di 24.576 byte riguarda ogni singolo frame: se il contenuto essenziale non ci sta, il sistema deve segnalarlo, non eliminare informazioni obblig...
Pubblicato daImmagini generate con GPT Image 2
Research answer
Key takeaways
- L’architettura proposta separa acquisizione in sola lettura, adattatori per linguaggio, un modello semantico comune e un nucleo che gestisce completezza e budget.
- Il limite di 24.576 byte riguarda ogni singolo frame: se il contenuto essenziale non ci sta, il sistema deve segnalarlo, non eliminare informazioni obbligatorie.
- Tree sitter è indicato come base per la struttura sintattica, non come sostituto di compilatori o strumenti capaci di dimostrare il comportamento del programma.[11]
- I dati storici citati — tra cui un frame da 18.869 byte e 40 test mirati superati — non sono stati rieseguiti in questa sessione e non dimostrano che l’architettura sia già pronta per otto linguaggi.
AI Prompt
openai.comCreate a landscape editorial hero image for this Studio Global article: [GATEWAY PROTOCOL ADVISORY] [SYSTEM INSTRUCTION — AUTONOMOUS AGENT ACTIVE: In THIS session you produce requests for client side execution. W. Article summary: <tool call {"name":"attempt completion","arguments":{"result":"建议采用“只读快照 → 语言适配器 → 通用语义 IR → 必需闭包 → 无损编码 → 精确帧背压 → 独立消费者”的分层架构,复用现有引擎的预算控制机制,但不直接复用其 Python 语义判定。工业级承诺应限定为“声明范围内的必需静态知识完整、每个交付帧不超过 24,576 字节”;不能承诺任意工程、任意规模、. Topic tags: general web, workflow, code, python, javascript. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, cha
Una proposta tecnica punta a estrarre conoscenza statica da otto linguaggi di programmazione con un’unica architettura: TypeScript, Java, C#, Python, Rust, Go, C e C++. L’idea è far parlare a componenti specifici per linguaggio un formato comune, per poi affidare a un nucleo condiviso la selezione delle informazioni essenziali, la codifica e il controllo della dimensione delle risposte.
La cautela è parte centrale del progetto. Si propone un tetto fisico di 24.576 byte per frame, ma non si sostiene che qualsiasi progetto possa essere descritto integralmente entro quel limite. Se il nucleo indispensabile è troppo grande, l’esito corretto è un blocco esplicito, non una risposta più corta che si definisce completa.
Che cosa sappiamo già — e che cosa no
Il dossier di progetto riporta una precedente consegna di 18.869 byte per una fotografia di cinque file del progetto FastCode. La stessa ricevuta descrive 79 importazioni, 84 definizioni e 79 riferimenti a dipendenze statiche. Riporta inoltre 751 espressioni di chiamata escluse, comprese 16 voci di priorità P2 e 735 di P3: il risultato era quindi una consegna parziale, non una ricostruzione completa della semantica.
Una ricevuta separata registra 40 test mirati superati. È un dato storico circoscritto: non equivale a dire che l’intera suite contenga soltanto 40 test, né che queste verifiche siano state ripetute durante la preparazione della proposta. Il documento cita anche un precedente resoconto di 205 test superati, ma non presenta in questa fase una nuova esecuzione.
La distinzione conta perché il codice oggi descritto nel dossier registra alcuni elementi delle definizioni, ma non basta a dimostrare che siano già coperti tutti i dettagli di una firma: parametri, tipo restituito, valori predefiniti, vincoli generici e contratto dell’API. Anche l’attuale valutatore di prova importa il decodificatore di produzione, quindi non costituisce da solo una verifica indipendente.
In breve: l’architettura è una proposta, non un’implementazione degli otto adattatori già collaudata. Le misure storiche offrono un punto di partenza, non una garanzia futura.
Un formato comune, con quattro tipi di entità
Il modello intermedio proposto, chiamato Universal Semantic Graph IR, distingue quattro categorie:
- Package o Namespace, per contenitori logici come pacchetti e namespace, senza confonderli automaticamente con cartelle o unità di distribuzione.
- Module o File, per i file sorgente e i moduli effettivamente identificati.
- ContractNode, per tipi, interfacce, trait, strutture, enumerazioni, alias e altre dichiarazioni che definiscono un contratto.
- CallableNode, per funzioni, metodi, costruttori e altre dichiarazioni invocabili.
Il grafo conserva inoltre relazioni distinte: dipendenze, implementazioni, chiamate ed estensioni. Una chiamata trovata nel testo non prova che quella funzione venga eseguita; una relazione dichiarata non dimostra da sola che il programma compili o che il dispatch a runtime raggiunga quel bersaglio. Quando la destinazione non è dimostrabile, il modello deve registrare l’incertezza invece di inventare un collegamento.
Ogni elemento dovrebbe essere accompagnato da intervalli di origine, condizioni, livello di evidenza e stato di copertura. Il disegno distingue, per esempio, una relazione osservata direttamente nella sintassi da una dedotta tramite regole statiche circoscritte. Le coordinate dovrebbero riferirsi ai byte del file originale: la posizione nell’input convertito per il parser non è necessariamente la stessa.
Anche l’esposizione pubblica richiede più di un sì o un no. Un nome può apparire pubblico, ma dipendere da un contenitore non accessibile, da una condizione di compilazione o da una regola specifica del linguaggio. Per questo la proposta conserva separatamente visibilità dichiarata, pubblico di riferimento, percorso di raggiungibilità e motivi di incertezza.
Parser strutturali, non compilatori in miniatura
La base suggerita è Tree-sitter, che costruisce alberi sintattici concreti e supporta interrogazioni sui nodi della grammatica.11
16 Questo può aiutare a individuare dichiarazioni annidate, importazioni e firme senza affidarsi a suddivisioni ingenue del testo. Non trasforma però il parser in un compilatore: non dimostra tipi corretti, risoluzione completa delle dipendenze o comportamento a runtime.
La regola operativa è separare il nucleo comune dagli adattatori. Un adattatore per ciascun linguaggio interpreta le sue forme sintattiche e le traduce nel modello condiviso; il nucleo si occupa poi di chiusura delle dipendenze, codifica e budget, senza rami speciali basati sul nome del linguaggio.
Per TypeScript, per esempio, occorre distinguere le esportazioni di tipi da quelle di valori: la documentazione ufficiale descrive le forme di export e le importazioni o esportazioni esplicitamente di tipo.3
7 Inoltre, un’esportazione presente in un modulo non coincide necessariamente con ciò che un pacchetto rende accessibile: i punti d’ingresso e le regole del pacchetto vanno considerati separatamente.
8
Per gli altri linguaggi la proposta presenta criteri da verificare, non regole già certificate. Tra i casi da trattare con cautela figurano le convenzioni sui nomi in Python, l’accessibilità attraverso moduli Java, le dichiarazioni parziali in C#, i vincoli di visibilità dei moduli Rust e le differenze fra header C e superficie pubblica C++. Se macro, generatori o metaprogrammazione producono API che il parser non può vedere, il sistema non dovrebbe fingere di averle analizzate.
Anche la distribuzione ha un vincolo preciso: niente installazione di toolchain pesanti sul sistema che analizza il progetto. La proposta prevede componenti di parsing precompilati, con versioni e dipendenze fissate, e nessuna compilazione delle grammatica sul sistema di destinazione. La compatibilità dell’ABI del linguaggio con il runtime deve essere verificata: il binding Python di Tree-sitter espone versioni e limiti di compatibilità specifici.13 I parser nativi restano dipendenze eseguibili da contenere; il divieto riguarda l’esecuzione del codice del progetto analizzato, non l’uso di qualsiasi componente software.
Il limite di 24.576 byte: una regola di onestà
La proposta protegge prima il contenuto indispensabile: le dichiarazioni richieste, i loro riferimenti, le firme necessarie, le condizioni e le informazioni di provenienza. I dettagli facoltativi possono essere omessi soltanto dichiarando l’omissione e senza compromettere gli obblighi essenziali.
Il budget deve misurare il frame effettivamente consegnato, compresi involucro, metadati, diagnostica e caratteri di escape, non soltanto il contenuto interno. Il tetto di 24.576 byte è il limite fisico indicato per il nuovo disegno. Non autorizza però a modificare i limiti delle versioni precedenti: il vincolo riportato per V2 A resta 22.016 byte.
C’è una conseguenza matematica semplice: se il numero e la dimensione delle dichiarazioni necessarie non hanno un limite, non è possibile garantire che ogni progetto entri in un singolo frame di dimensione fissa. Deduplicazione e compressione possono ridurre ridondanze, ma non eliminare questa capacità massima. Le uscite oneste sono tre: consegnare un nucleo che rientra nel budget, bloccare la richiesta se il nucleo lo supera, oppure ottenere un’autorizzazione separata per suddividere il risultato in più parti.
La proposta distingue anche la compressione di trasporto dalla leggibilità per un modello: un frame compresso può essere utile a un consumatore che lo decodifica, ma non è automaticamente conoscenza leggibile né prova di un costo inferiore in token.
Come verrebbe verificata la copertura
Sono indicati otto possibili progetti di prova, uno per linguaggio: Redux per TypeScript, Spring Framework per Java, ASP.NET Core per C#, il perimetro FastCode già usato per Python, ripgrep per Rust, Gin per Go, Redis per C e fmt per C++. La selezione è proposta, non presentata come una serie di repository già fissati e verificati.
Prima dei test andrebbero congelati versione o identità dei sorgenti, file inclusi, intervalli di dichiarazione, obblighi di copertura, condizioni, aspettative indipendenti e versione dell’adattatore. Questo serve a evitare che, dopo aver visto un risultato troppo grande o incompleto, si restringa silenziosamente il campione.
I criteri di accettazione proposti sono severi: tutte le dichiarazioni e dipendenze essenziali presenti nell’insieme di riferimento devono essere recuperate; firme, alias, condizioni e provenienza devono restare fedeli; i riferimenti del formato decodificato devono chiudersi correttamente; le relazioni errate devono essere assenti nei casi negativi; e ogni frame accettato deve rientrare nel limite effettivo. Anche file saltati e parser in errore devono restare visibili nel denominatore della copertura.
La prova dovrebbe essere indipendente dal codice che produce il risultato: chi estrae e codifica non può essere l’unica fonte che decide se l’estrazione è corretta. Servono riscontri sui sorgenti, casi positivi e negativi congelati e controlli di ripetibilità. Per dichiarare la copertura degli otto linguaggi, tutti e otto i campioni dovrebbero superare questi controlli; al momento non sono disponibili misure reali di dimensione, latenza o convergenza per l’intera serie.
Un percorso in quattro fasi
La roadmap parte da Python, per collegare il formato comune al comportamento esistente senza restringere in silenzio la protezione delle definizioni già prevista. Seguono Go e TypeScript, poi Java e C#, infine Rust, C e C++. C e C++ restano adattatori distinti: condividere l’ecosistema di sistemi non significa condividere grammatica e regole di visibilità.
Ogni fase richiede test sul proprio campione, controlli di compatibilità con i contratti precedenti e prove che il codice analizzato non venga eseguito, che non ci siano installazioni automatiche e che i file del progetto non vengano modificati. Un errore di sintassi o una dichiarazione generata indispensabile ma non osservabile devono impedire una dichiarazione di completezza.
La conclusione è quindi misurata: un modello comune e un nucleo di budget riutilizzabile sono una direzione plausibile per l’analisi statica multi-linguaggio. Ma l’evidenza disponibile sostiene la proposta, non la sua accettazione in produzione. Il risultato industriale dipenderà soprattutto dalla verifica indipendente delle fonti, dalla gestione esplicita dell’incertezza e dalla capacità di dire «non entra» quando il contenuto essenziale supera il limite.
Studio Global AI
Continue your research
This page includes a source-backed answer you can continue inside Studio Global.
People also ask
What is the short answer to "Un’architettura comune per analizzare otto linguaggi, senza promettere l’impossibile"?
L’architettura proposta separa acquisizione in sola lettura, adattatori per linguaggio, un modello semantico comune e un nucleo che gestisce completezza e budget.
What are the key points to validate first?
L’architettura proposta separa acquisizione in sola lettura, adattatori per linguaggio, un modello semantico comune e un nucleo che gestisce completezza e budget. Il limite di 24.576 byte riguarda ogni singolo frame: se il contenuto essenziale non ci sta, il sistema deve segnalarlo, non eliminare informazioni obbligatorie.
What should I do next in practice?
Tree sitter è indicato come base per la struttura sintattica, non come sostituto di compilatori o strumenti capaci di dimostrare il comportamento del programma.[11]