Skor yang paling aman dikutip untuk konteks umum adalah 84,9% di GDPval; OpenAI menyebut GDPval menguji pekerjaan pengetahuan yang terdefinisi jelas di 44 profesi.[1] Nilai lain seperti 73,1% di Expert SWE dan 80,5% di BixBench berasal dari ranah tugas berbeda—coding dan bioinformatika—jadi tidak tepat dibandingkan...
Diterbitkan olehDiedit dengan GPT-5.5Gambar dibuat dengan GPT Image 2
Skor yang paling aman dikutip untuk konteks umum adalah 84,9% di GDPval; OpenAI menyebut GDPval menguji pekerjaan pengetahuan yang terdefinisi jelas di 44 profesi.[1]
Nilai lain seperti 73,1% di Expert SWE dan 80,5% di BixBench berasal dari ranah tugas berbeda—coding dan bioinformatika—jadi tidak tepat dibandingkan langsung dengan GDPval.[8][10]
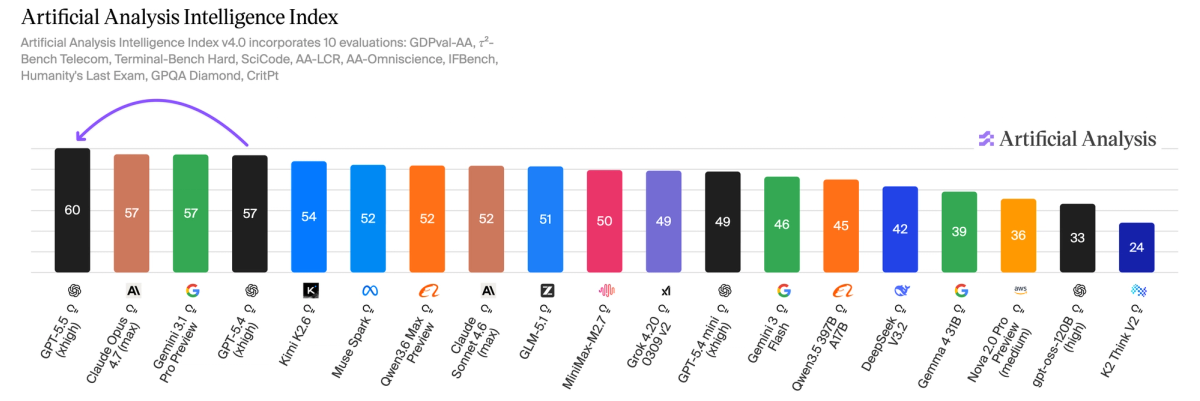
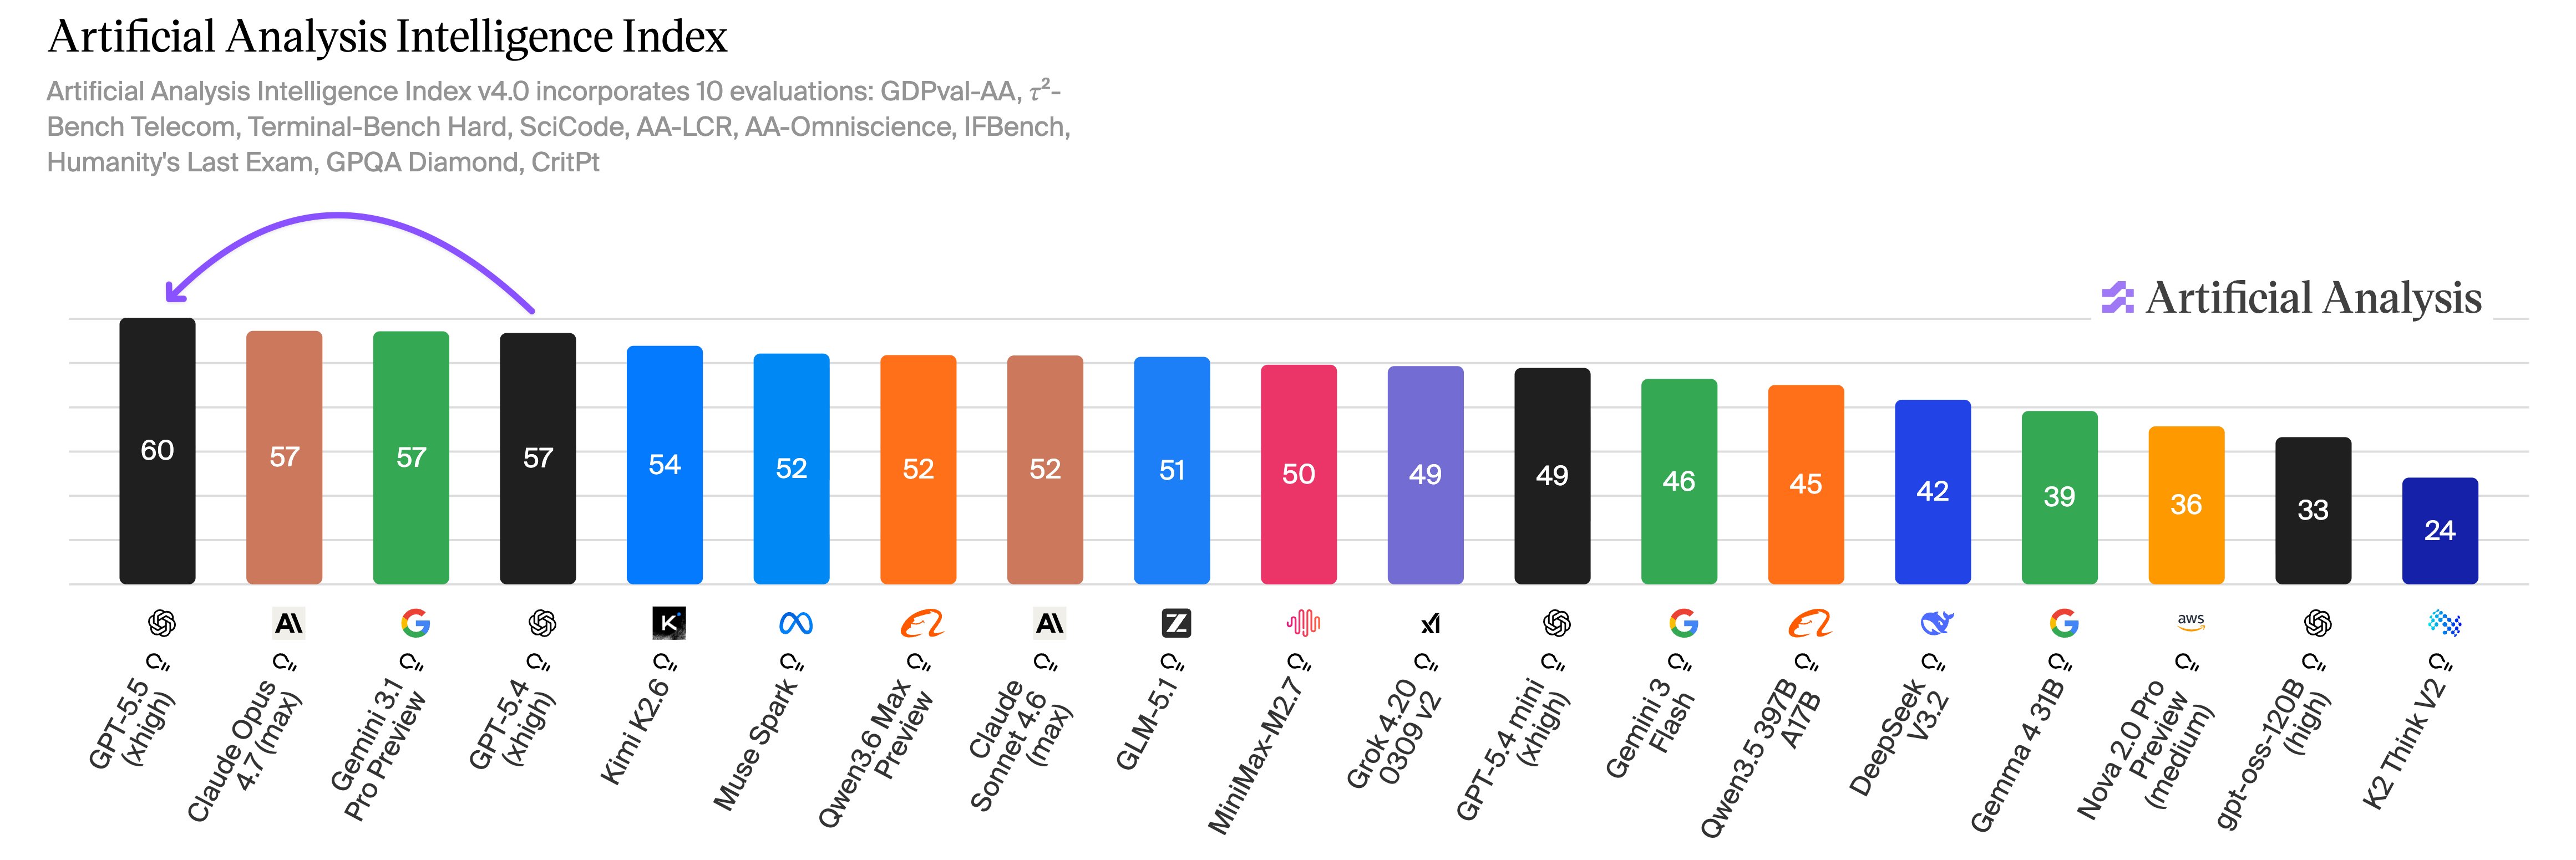
Untuk pembanding model yang lebih luas, Artificial Analysis menempatkan GPT 5.5 di puncak Intelligence Index dengan keunggulan 3 poin, tetapi itu tidak berarti model ini menang di setiap evaluasi tunggal.[3]
GPT-5.5-Benchmark erklärt: Was 84,9 % auf GDPval wirklich bedeutenKI-generierte Illustration zum Vergleich von GPT-5.5-Benchmarks.
AI Perintah
Create a landscape editorial hero image for this Studio Global article: GPT-5.5-Benchmark erklärt: Was 84,9 % auf GDPval wirklich bedeuten. Article summary: Für eine knappe, belastbare Einordnung ist 84,9 % auf GDPval der beste GPT 5.5 Wert: OpenAI nennt ihn selbst und beschreibt GDPval als Test für klar spezifizierte Wissensarbeit über 44 Berufe.. Topic tags: ai, openai, chatgpt, gpt 5, benchmarks. Reference image context from search candidates: Reference image 1: visual subject " GPT-5.5 tops the Artificial Analysis Intelligen" source context "OpenAI's GPT-5.5 is the new leading AI model - Artificial Analysis" Reference image 2: visual subject " GPT-5.5 tops the Artificial Analysis Intelligen" source context "OpenAI's GPT-5.5 is the new leading AI model - Artificial Analysis" Reference image 2: visual subject "![Image 1](https://cdn.sanity.io/images/6vfeftx9/articles/9052d745e6337cd4369bde9219bcf511bebec944-4644x1551.png?
openai.com
Kalau yang Anda cari adalah jawaban cepat atas pertanyaan “benchmark GPT-5.5 berapa?”, angka yang paling aman untuk disebut adalah 84,9% di GDPval. OpenAI sendiri menyebut angka ini, dan menjelaskan GDPval sebagai benchmark untuk menguji kemampuan agen AI menghasilkan pekerjaan pengetahuan yang terdefinisi jelas di 44 profesi.
Namun, angka itu perlu pagar pembatas. Skor GDPval bukan nilai kecerdasan universal, bukan jaminan bahwa GPT-5.5 unggul di semua jenis tugas, dan bukan pembanding langsung untuk coding, bioinformatika, atau hukum. Ia paling tepat dibaca sebagai ukuran performa pada pekerjaan pengetahuan profesional yang instruksinya jelas.
Jawaban singkat yang paling tepat
Jika hanya boleh mengutip satu angka, formulasi yang paling bersih adalah:
Menurut OpenAI, GPT-5.5 mencetak 84,9% di GDPval, benchmark yang menguji kemampuan agen AI membuat pekerjaan pengetahuan yang terdefinisi jelas di 44 profesi.
Studio Global AI
Lanjutkan penelitian Anda
Halaman ini berisi jawaban yang didukung sumber yang dapat Anda lanjutkan di dalam Studio Global.
Apa jawaban singkat untuk "Benchmark GPT-5.5: arti skor 84,9% di GDPval"?
Skor yang paling aman dikutip untuk konteks umum adalah 84,9% di GDPval; OpenAI menyebut GDPval menguji pekerjaan pengetahuan yang terdefinisi jelas di 44 profesi.[1]
Apa poin penting yang harus divalidasi terlebih dahulu?
Skor yang paling aman dikutip untuk konteks umum adalah 84,9% di GDPval; OpenAI menyebut GDPval menguji pekerjaan pengetahuan yang terdefinisi jelas di 44 profesi.[1] Nilai lain seperti 73,1% di Expert SWE dan 80,5% di BixBench berasal dari ranah tugas berbeda—coding dan bioinformatika—jadi tidak tepat dibandingkan langsung dengan GDPval.[8][10]
Apa yang harus saya lakukan selanjutnya dalam latihan?
Untuk pembanding model yang lebih luas, Artificial Analysis menempatkan GPT 5.5 di puncak Intelligence Index dengan keunggulan 3 poin, tetapi itu tidak berarti model ini menang di setiap evaluasi tunggal.[3]
Kalimat ini penting karena tidak memisahkan angka dari konteksnya. Tanpa konteks, 84,9% mudah disalahartikan sebagai “nilai total” GPT-5.5. Padahal benchmark AI biasanya mengukur kemampuan tertentu, dengan rancangan tugas dan cara penilaian tertentu pula.
Angka-angka utama yang sering disebut
Benchmark atau perbandingan
Nilai yang dilaporkan
Apa yang diukur
Cara membacanya
GDPval
84,9%
Pekerjaan pengetahuan yang terdefinisi jelas di 44 profesi
Angka dari pengumuman OpenAI, sehingga paling cocok untuk jawaban singkat umum.
Expert-SWE
73,1%
Tugas coding; menurut laporan, ini adalah evaluasi internal untuk tugas dengan estimasi waktu penyelesaian 20 jam
Lebih relevan untuk pengembangan perangkat lunak, tetapi tidak sebanding langsung dengan GDPval.
BixBench
80,5%
Benchmark bioinformatika dunia nyata
Relevan untuk bioinformatika, dengan catatan bahwa dalam sumber yang tersedia di sini, dukungan faktualnya tidak sekuat angka GDPval yang langsung disebut OpenAI.
Artificial Analysis Intelligence Index
Peringkat pertama, unggul 3 poin
Indeks model eksternal dari Artificial Analysis
Berguna untuk membaca posisi GPT-5.5 terhadap model lain, tetapi bukan satu benchmark resmi dari OpenAI.
Mengapa 84,9%, 73,1%, dan 80,5% tidak bisa dijejerkan begitu saja
Di atas kertas, 84,9%, 73,1%, dan 80,5% tampak seperti nilai dari satu daftar ujian yang sama. Kenyataannya tidak begitu.
84,9% di GDPval merujuk pada pekerjaan pengetahuan yang dirumuskan jelas di banyak profesi.
73,1% di Expert-SWE merujuk pada tugas coding dalam evaluasi internal yang dilaporkan untuk pekerjaan dengan estimasi penyelesaian 20 jam.
80,5% di BixBench merujuk pada tugas bioinformatika dunia nyata.
Jadi, pertanyaan yang lebih berguna bukan “angka mana yang paling tinggi?”, melainkan “benchmark mana yang paling dekat dengan kebutuhan saya?” Untuk pekerjaan pengetahuan umum, GDPval lebih relevan. Untuk pengembangan perangkat lunak, Expert-SWE lebih dekat. Untuk bioinformatika, BixBench lebih sesuai secara tema.
Apa arti posisi GPT-5.5 di Artificial Analysis
Artificial Analysis melaporkan bahwa GPT-5.5 memimpin Intelligence Index mereka dengan selisih 3 poin. Dalam tulisan yang sama, Artificial Analysis juga menyebut OpenAI memimpin lima evaluasi utama mereka dan berada di posisi kedua, di belakang Gemini 3.1 Pro Preview, pada tiga evaluasi lain.
Nuansanya penting: peringkat pertama di sebuah indeks eksternal tidak otomatis berarti menang di semua tes. Artinya, menurut metodologi Artificial Analysis, GPT-5.5 berada di posisi teratas secara keseluruhan dalam indeks tersebut.
Hati-hati dengan angka headline yang berdiri sendiri
Beberapa laporan lain menyebut angka seperti 91,7% untuk kemampuan legal AI atau 82,7% dalam konteks agentic coding. Angka semacam ini bisa saja penting untuk bidang tertentu. Namun untuk jawaban benchmark yang bersifat umum, angka-angka itu kurang ideal jika rancangan uji, kelompok pembanding, dan tujuan pengukurannya tidak dijelaskan sejelas GDPval dalam pengumuman OpenAI.
Angka mana yang sebaiknya dikutip?
Untuk kebanyakan konteks umum, gunakan ini:
GPT-5.5 mencapai 84,9% di GDPval menurut OpenAI; GDPval menguji kemampuan agen AI menghasilkan pekerjaan pengetahuan yang terdefinisi jelas di 44 profesi.
Jika konteksnya lebih spesifik, pilih benchmark sesuai kebutuhan:
Pekerjaan pengetahuan umum: 84,9% di GDPval.
Pengembangan perangkat lunak: 73,1% di Expert-SWE.
Bioinformatika: 80,5% di BixBench, dengan catatan sumber yang tersedia lebih terbatas dibanding klaim GDPval dari OpenAI.
Perbandingan model secara luas: peringkat pertama di Artificial Analysis Intelligence Index dengan keunggulan 3 poin.
Kesimpulan
Benchmark singkat terbaik untuk GPT-5.5 adalah 84,9% di GDPval. Angka ini langsung disebut oleh OpenAI dan punya ruang lingkup yang jelas: pekerjaan pengetahuan yang terdefinisi baik di 44 profesi.
Angka lain tetap bisa berguna, tetapi hanya jika disandingkan dengan konteksnya. Dengan begitu, benchmark tidak berubah menjadi klaim berlebihan—dan pembaca bisa menilai GPT-5.5 berdasarkan jenis tugas yang benar-benar ingin diukur.
mexc.com
OpenAI’s GPT-5.5 Launches With 91.7% Benchmark Score | MEXC News
Kalimat ini penting karena tidak memisahkan angka dari konteksnya. Tanpa konteks, 84,9% mudah disalahartikan sebagai “nilai total” GPT-5.5. Padahal benchmark AI biasanya mengukur kemampuan tertentu, dengan rancangan tugas dan cara penilaian tertentu pula.
Angka-angka utama yang sering disebut
Benchmark atau perbandingan
Nilai yang dilaporkan
Apa yang diukur
Cara membacanya
GDPval
84,9%
Pekerjaan pengetahuan yang terdefinisi jelas di 44 profesi
Angka dari pengumuman OpenAI, sehingga paling cocok untuk jawaban singkat umum.
Expert-SWE
73,1%
Tugas coding; menurut laporan, ini adalah evaluasi internal untuk tugas dengan estimasi waktu penyelesaian 20 jam
Lebih relevan untuk pengembangan perangkat lunak, tetapi tidak sebanding langsung dengan GDPval.
BixBench
80,5%
Benchmark bioinformatika dunia nyata
Relevan untuk bioinformatika, dengan catatan bahwa dalam sumber yang tersedia di sini, dukungan faktualnya tidak sekuat angka GDPval yang langsung disebut OpenAI.
Artificial Analysis Intelligence Index
Peringkat pertama, unggul 3 poin
Indeks model eksternal dari Artificial Analysis
Berguna untuk membaca posisi GPT-5.5 terhadap model lain, tetapi bukan satu benchmark resmi dari OpenAI.
Mengapa 84,9%, 73,1%, dan 80,5% tidak bisa dijejerkan begitu saja
Di atas kertas, 84,9%, 73,1%, dan 80,5% tampak seperti nilai dari satu daftar ujian yang sama. Kenyataannya tidak begitu.
84,9% di GDPval merujuk pada pekerjaan pengetahuan yang dirumuskan jelas di banyak profesi.
73,1% di Expert-SWE merujuk pada tugas coding dalam evaluasi internal yang dilaporkan untuk pekerjaan dengan estimasi penyelesaian 20 jam.
80,5% di BixBench merujuk pada tugas bioinformatika dunia nyata.
Jadi, pertanyaan yang lebih berguna bukan “angka mana yang paling tinggi?”, melainkan “benchmark mana yang paling dekat dengan kebutuhan saya?” Untuk pekerjaan pengetahuan umum, GDPval lebih relevan. Untuk pengembangan perangkat lunak, Expert-SWE lebih dekat. Untuk bioinformatika, BixBench lebih sesuai secara tema.
Apa arti posisi GPT-5.5 di Artificial Analysis
Artificial Analysis melaporkan bahwa GPT-5.5 memimpin Intelligence Index mereka dengan selisih 3 poin. Dalam tulisan yang sama, Artificial Analysis juga menyebut OpenAI memimpin lima evaluasi utama mereka dan berada di posisi kedua, di belakang Gemini 3.1 Pro Preview, pada tiga evaluasi lain.
Nuansanya penting: peringkat pertama di sebuah indeks eksternal tidak otomatis berarti menang di semua tes. Artinya, menurut metodologi Artificial Analysis, GPT-5.5 berada di posisi teratas secara keseluruhan dalam indeks tersebut.
Hati-hati dengan angka headline yang berdiri sendiri
Beberapa laporan lain menyebut angka seperti 91,7% untuk kemampuan legal AI atau 82,7% dalam konteks agentic coding. Angka semacam ini bisa saja penting untuk bidang tertentu. Namun untuk jawaban benchmark yang bersifat umum, angka-angka itu kurang ideal jika rancangan uji, kelompok pembanding, dan tujuan pengukurannya tidak dijelaskan sejelas GDPval dalam pengumuman OpenAI.
Angka mana yang sebaiknya dikutip?
Untuk kebanyakan konteks umum, gunakan ini:
GPT-5.5 mencapai 84,9% di GDPval menurut OpenAI; GDPval menguji kemampuan agen AI menghasilkan pekerjaan pengetahuan yang terdefinisi jelas di 44 profesi.
Jika konteksnya lebih spesifik, pilih benchmark sesuai kebutuhan:
Pekerjaan pengetahuan umum: 84,9% di GDPval.
Pengembangan perangkat lunak: 73,1% di Expert-SWE.
Bioinformatika: 80,5% di BixBench, dengan catatan sumber yang tersedia lebih terbatas dibanding klaim GDPval dari OpenAI.
Perbandingan model secara luas: peringkat pertama di Artificial Analysis Intelligence Index dengan keunggulan 3 poin.
Kesimpulan
Benchmark singkat terbaik untuk GPT-5.5 adalah 84,9% di GDPval. Angka ini langsung disebut oleh OpenAI dan punya ruang lingkup yang jelas: pekerjaan pengetahuan yang terdefinisi baik di 44 profesi.
Angka lain tetap bisa berguna, tetapi hanya jika disandingkan dengan konteksnya. Dengan begitu, benchmark tidak berubah menjadi klaim berlebihan—dan pembaca bisa menilai GPT-5.5 berdasarkan jenis tugas yang benar-benar ingin diukur.
mexc.com
OpenAI’s GPT-5.5 Launches With 91.7% Benchmark Score | MEXC News