JawabanDipublikasikan13 sumber
Implan Otak UCSF Terjemahkan Ucapan dan Gestur pada Kelumpuhan Berat
Array ECoG berdensitas tinggi dengan 253 elektroda merekam sinyal dari korteks sensorimotor saat peserta berusaha berbicara dan membuat gestur tubuh bagian atas. Decoder AI terpisah menerjemahkan sinyal untuk ucapan dan gerakan avatar secara serentak dalam hitungan detik.
Diterbitkan olehGambar dibuat dengan GPT Image 2
Jawaban penelitian
Poin-poin penting
- Array ECoG berdensitas tinggi dengan 253 elektroda merekam sinyal dari korteks sensorimotor saat peserta berusaha berbicara dan membuat gestur tubuh bagian atas.
- Decoder AI terpisah menerjemahkan sinyal untuk ucapan dan gerakan avatar secara serentak dalam hitungan detik.
- Studi ini melibatkan tiga orang dengan kelumpuhan pada saluran vokal dan anggota gerak.
- Teknologi masih berupa demonstrasi penelitian berkabel, dengan sasaran pengembangan menuju sistem implan nirkabel sepenuhnya.
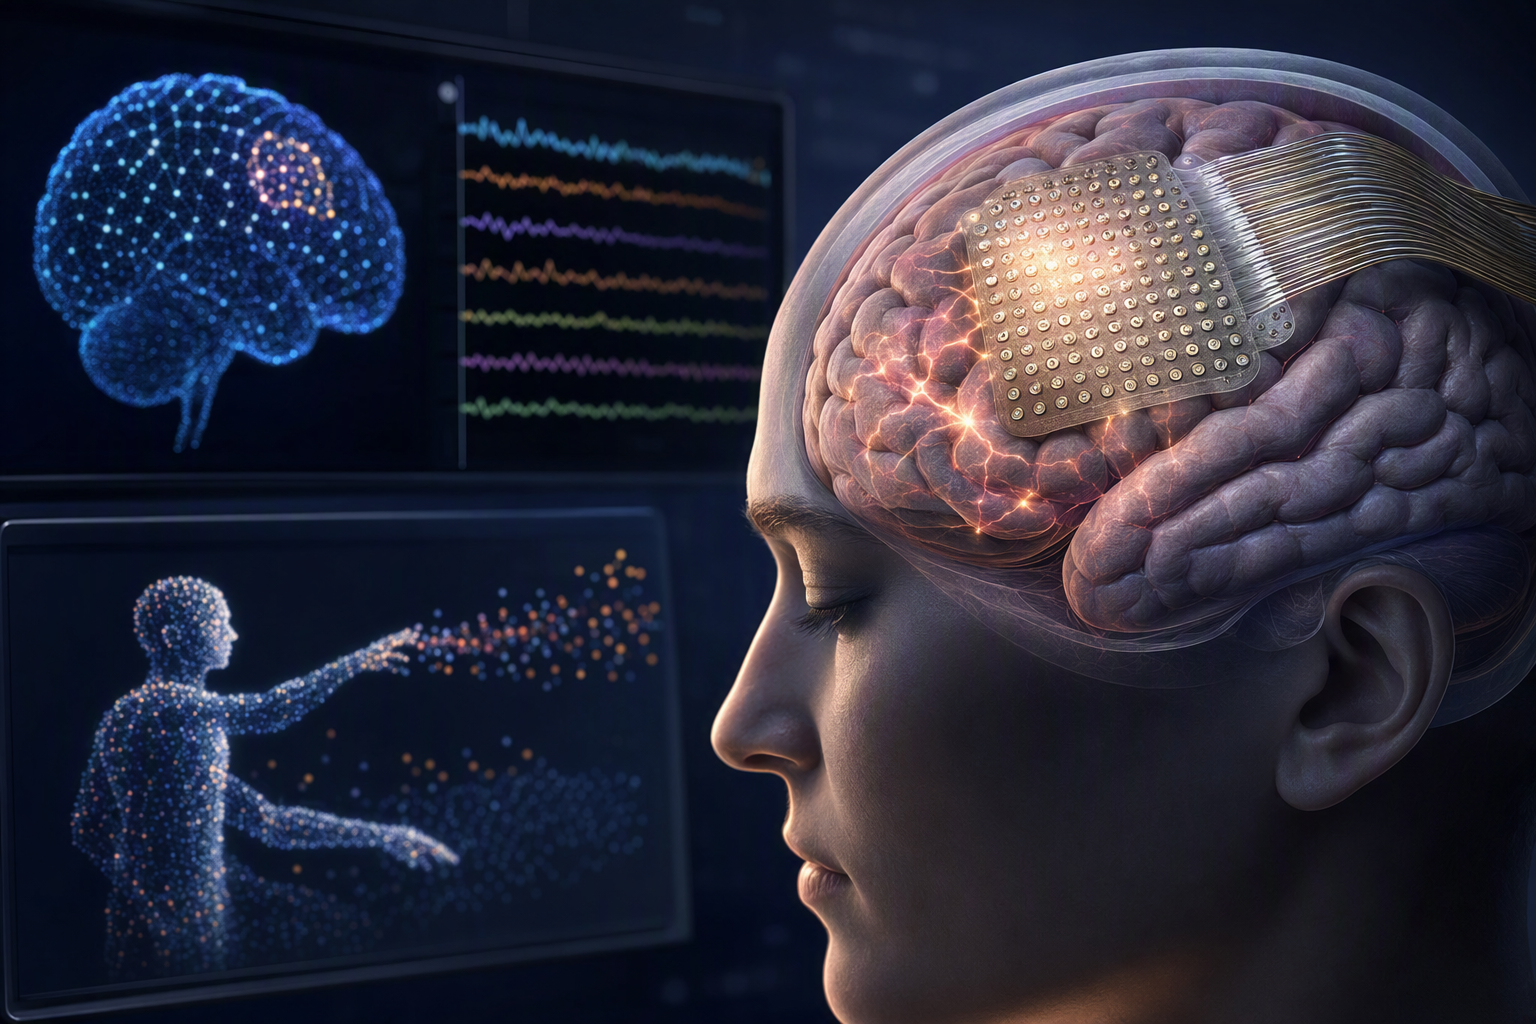
AI Perintah
openai.comCreate a landscape editorial hero image for this Studio Global article: How did University of California, San Francisco researchers use a 253 electrode sensorimotor cortex brain computer interface to simultaneous. Article summary: UCSF researchers placed a 253 electrode, high density electrocorticography array over sensorimotor cortex—the region involved in planning speech and movement—and used it to record neural activity while participants attem. Topic tags: general web, ai, privacy, regulation, video. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts
Peneliti University of California, San Francisco (UCSF) menggunakan antarmuka otak-komputer atau brain-computer interface (BCI) berupa susunan elektrokortikografi (ECoG) berdensitas tinggi dengan 253 elektroda. Array ini dipasang di atas korteks sensorimotor, wilayah otak yang berperan dalam perencanaan gerak dan bicara.
Saat peserta dengan kelumpuhan berat berupaya berbicara dan melakukan gestur tubuh bagian atas, perangkat merekam aktivitas saraf tersebut. Sistem pembelajaran mesin kemudian menerjemahkannya, dalam hitungan detik, menjadi keluaran ucapan dan gerakan yang tampil bersamaan melalui avatar virtual yang dipersonalisasi. 2
3
Cara sistem menerjemahkan niat pengguna
Implan menangkap pola aktivitas korteks yang berkaitan dengan upaya menggerakkan saluran vokal dan tubuh bagian atas, walaupun peserta tidak dapat menjalankan gerakan itu secara fisik akibat kelumpuhan. 2
3
Tim UCSF tidak memakai satu decoder umum untuk seluruh bentuk komunikasi. Mereka melatih decoder pembelajaran mesin yang spesifik untuk masing-masing tugas:
- satu decoder memetakan aktivitas otak ke ucapan yang dimaksudkan;
- decoder lain memetakan sinyal tersebut ke perintah atau kinematika gestur bagi avatar.
2
3
Temuan pentingnya, aktivitas saraf ketika peserta mencoba berbicara sambil memberi gestur ternyata bukan sekadar penjumlahan sederhana dari sinyal saat berbicara saja dan saat membuat gestur saja. Karena itu, sistem dilatih memakai tugas komunikasi gabungan yang lebih alami. Pendekatan ini membantu menyelaraskan suara dan gerakan avatar, alih-alih membuat keduanya bekerja sendiri-sendiri. Bukti yang tersedia mendukung hasil multimodal serentak ini, tetapi belum cukup untuk mengukur tingkat nonaditivitas sinyal atau performa decoder secara kuantitatif. 2
3
Mengapa ucapan dan gestur sama-sama penting
Sistem teks-ke-suara berbasis pelacakan mata dapat membantu komunikasi, tetapi pengguna biasanya harus memilih huruf atau ikon satu per satu. Proses itu bisa lambat dan melelahkan. Selain itu, kata-kata saja tidak selalu menyampaikan seluruh maksud percakapan: penekanan, anggukan, menunjuk, atau gerak tubuh bagian atas juga membawa makna sosial.
Dengan avatar yang dapat berbicara sekaligus bergerak, pengguna berpotensi menyampaikan pesan verbal dan nonverbal secara paralel—misalnya melambaikan tangan saat menyapa atau mengangguk untuk menyatakan setuju. Namun, ini masih merupakan demonstrasi penelitian, bukan perangkat komunikasi klinis yang sudah tersedia untuk penggunaan umum. 2
3
Peserta dan batasan saat ini
Penelitian ini melibatkan tiga orang dengan kelumpuhan pada saluran vokal dan anggota gerak. Mereka diminta berupaya berbicara dan membuat gestur tubuh bagian atas saat sistem mendekode kedua bentuk komunikasi tersebut. 2
3
Sumber yang tersedia tidak mengidentifikasi diagnosis maupun penyebab kelumpuhan setiap peserta secara individual, dan juga tidak merinci seluruh daftar tugas eksperimen. Laporan terkait studi menyebut populasi seperti ini dapat mencakup orang dengan kondisi antara lain stroke dan amyotrophic lateral sclerosis (ALS), tetapi bukti yang diberikan tidak memungkinkan penyebab tertentu dikaitkan kepada peserta tertentu.
Keterbatasan utama saat ini adalah sistemnya masih berkabel. Grid kortikal harus terhubung secara fisik ke perangkat perekaman dan komputasi di luar tubuh, sehingga belum praktis untuk penggunaan mandiri dalam kehidupan sehari-hari. Arah pengembangan berikutnya adalah sistem nirkabel yang sepenuhnya ditanamkan agar kabel yang menembus kulit dapat dihilangkan. Belum ada informasi yang cukup dalam sumber yang tersedia mengenai jadwal, produsen perangkat, atau status regulasinya.
Kelanjutan riset UCSF pada 2023
Riset ini merupakan pengembangan dari kerja tim Edward Chang pada 2023 di jurnal Nature. Dalam studi sebelumnya, array 253 kanal di korteks sensorimotor digunakan pada satu orang dengan kelumpuhan berat dan anartria—ketidakmampuan berbicara akibat gangguan fungsi motorik—untuk mendekode kalimat yang ingin diucapkan dan mendukung avatar. 1
Sistem 2023 berfokus pada keluaran ucapan serta animasi wajah avatar. Studi yang lebih baru memperluas pendekatan rekaman kortikal berdensitas tinggi dan decoding AI itu ke komunikasi gestural tubuh bagian atas yang berlangsung serentak dengan ucapan. 1
2
Studio Global AI
Lanjutkan penelitian Anda
Halaman ini berisi jawaban yang didukung sumber yang dapat Anda lanjutkan di dalam Studio Global.
Orang-orang juga bertanya
Apa jawaban singkat untuk "Implan Otak UCSF Terjemahkan Ucapan dan Gestur pada Kelumpuhan Berat"?
Array ECoG berdensitas tinggi dengan 253 elektroda merekam sinyal dari korteks sensorimotor saat peserta berusaha berbicara dan membuat gestur tubuh bagian atas.
Apa poin penting yang harus divalidasi terlebih dahulu?
Array ECoG berdensitas tinggi dengan 253 elektroda merekam sinyal dari korteks sensorimotor saat peserta berusaha berbicara dan membuat gestur tubuh bagian atas. Decoder AI terpisah menerjemahkan sinyal untuk ucapan dan gerakan avatar secara serentak dalam hitungan detik.
Apa yang harus saya lakukan selanjutnya dalam latihan?
Studi ini melibatkan tiga orang dengan kelumpuhan pada saluran vokal dan anggota gerak.
Sumber
pmc.ncbi.nlm.nih.govA high-performance neuroprosthesis for speech decoding and ...
magazine.ucsf.eduWinter 2022
changlab.ucsf.edu