ZAYA1‑8B‑Diffusion‑Preview: Cara Baru Mempercepat Generasi Teks AI Hingga 7,7×
Zyphra mengubah model ZAYA1‑8B berbasis autoregresif menjadi model difusi yang dapat menghasilkan blok 16 token sekaligus, dengan klaim percepatan decoding hingga 4,6× sampai 7,7× tergantung metode sampling. Pendekatan ini menggeser proses generasi teks dari urutan token satu‑per‑satu menjadi komputasi paralel, meng...
Diterbitkan olehDiedit dengan GPT-5.5Gambar dibuat dengan GPT Image 2
Zyphra mengubah model ZAYA1‑8B berbasis autoregresif menjadi model difusi yang dapat menghasilkan blok 16 token sekaligus, dengan klaim percepatan decoding hingga 4,6× sampai 7,7× tergantung metode sampling.
Pendekatan ini menggeser proses generasi teks dari urutan token satu‑per‑satu menjadi komputasi paralel, mengurangi hambatan bandwidth memori yang sering terjadi pada LLM tradisional.
Jika terbukti stabil dalam penggunaan nyata, teknik ini berpotensi menurunkan biaya inferensi, mempercepat proses reinforcement learning, dan meningkatkan efisiensi model AI secara keseluruhan.
What is Zyphra’s new ZAYA1-8B-Diffusion-Preview model, how does converting its autoregressive ZAYA1-8B into a Mixture-of-Experts diffusion lDiffusion-style language models can draft multiple tokens simultaneously instead of generating them sequentially.
AI Perintah
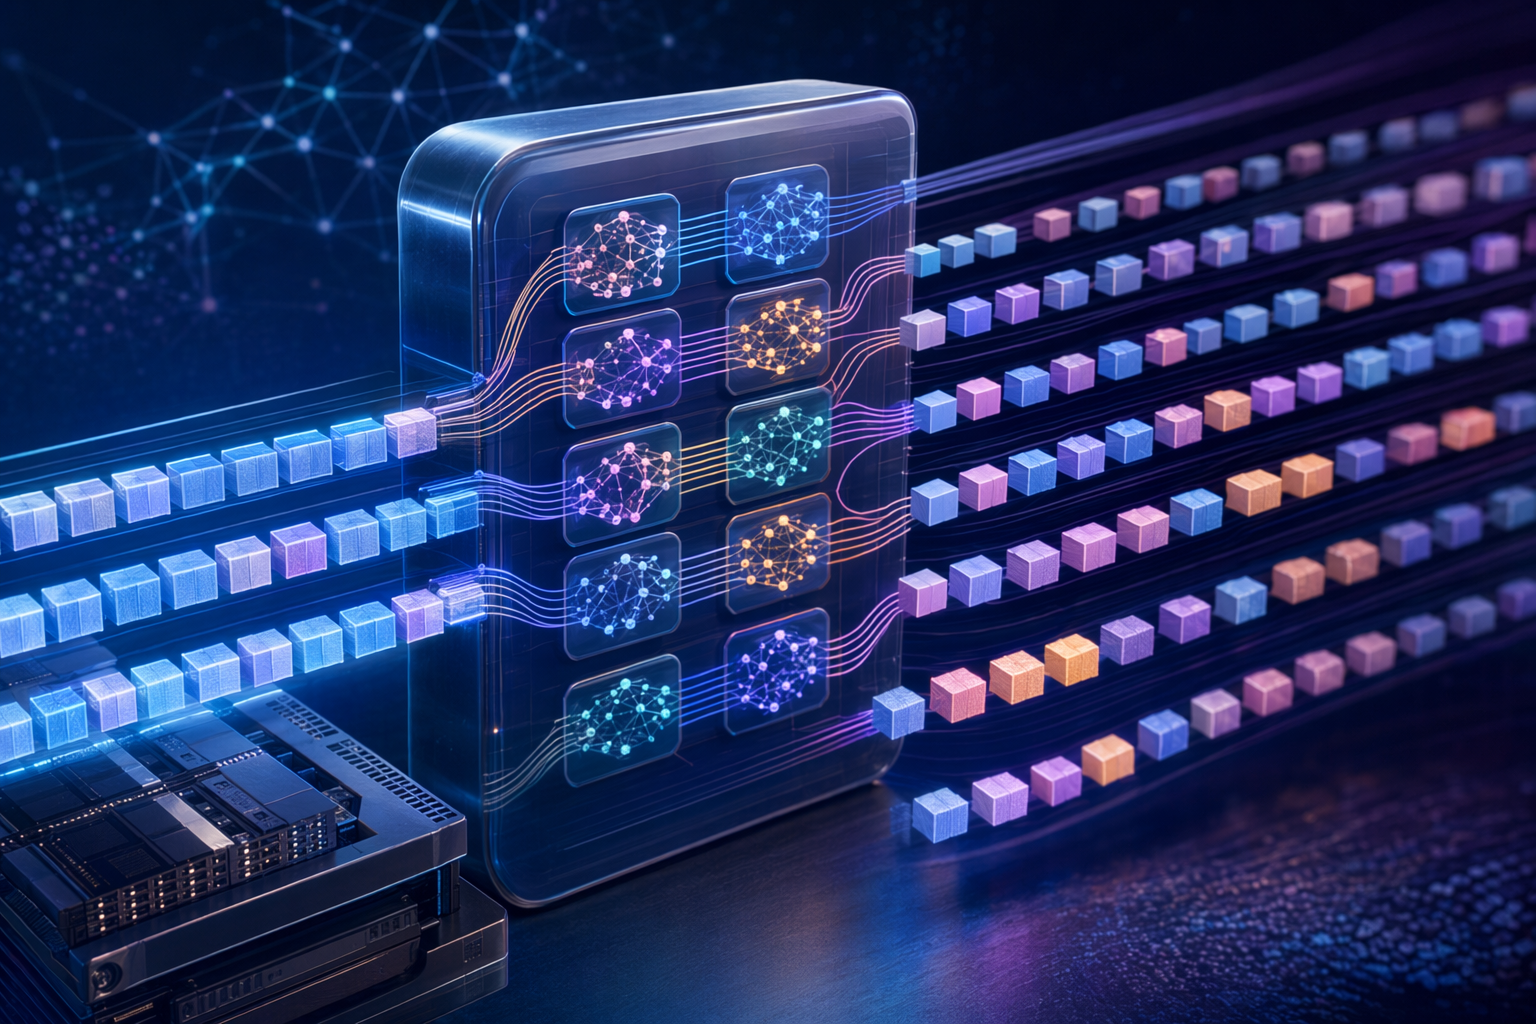
Create a landscape editorial hero image for this Studio Global article: What is Zyphra’s new ZAYA1-8B-Diffusion-Preview model, how does converting its autoregressive ZAYA1-8B into a Mixture-of-Experts diffusion l. Article summary: Zyphra’s ZAYA1-8B-Diffusion-Preview is an experimental diffusion-language version of its ZAYA1-8B MoE model, designed to decode blocks of text in parallel rather than strictly one token at a time. Zyphra claims it can ge. Topic tags: general, academic, general web, user generated. Reference image context from search candidates: Reference image 1: visual subject "# Zyphra Releases ZAYA1-8B: A Reasoning MoE Trained on AMD Hardware That Punches Far Above Its Weight Class. Zyphra AI has released ZAYA1-8B, a small Mixture of Experts (MoE) langu" source context "Zyphra Releases ZAYA1-8B: A Reasoning MoE Trained on AMD Hardware That Punches Far Above Its Weight Class
openai.com
Model eksperimental ZAYA1‑8B‑Diffusion‑Preview dari startup AI Zyphra menawarkan pendekatan baru untuk mempercepat cara model bahasa besar (LLM) menghasilkan teks. Alih‑alih membuat kata atau token satu per satu seperti LLM tradisional, model ini mampu membuat blok berisi 16 token sekaligus dalam satu langkah komputasi. Hasilnya, Zyphra melaporkan percepatan decoding hingga 4,6× dengan sampler “lossless” dan sampai 7,7× dengan teknik logit‑mixing dalam konfigurasi tertentu.
Menariknya, model ini tidak dilatih dari nol sebagai model difusi. Zyphra justru mengonversi model autoregresif yang sudah ada menjadi model difusi, membuka kemungkinan bahwa LLM konvensional dapat ditingkatkan kecepatannya tanpa harus membangun arsitektur baru dari awal.
Studio Global AI
Lanjutkan penelitian Anda
Halaman ini berisi jawaban yang didukung sumber yang dapat Anda lanjutkan di dalam Studio Global.
Apa jawaban singkat untuk "ZAYA1‑8B‑Diffusion‑Preview: Cara Baru Mempercepat Generasi Teks AI Hingga 7,7×"?
Zyphra mengubah model ZAYA1‑8B berbasis autoregresif menjadi model difusi yang dapat menghasilkan blok 16 token sekaligus, dengan klaim percepatan decoding hingga 4,6× sampai 7,7× tergantung metode sampling.
Apa poin penting yang harus divalidasi terlebih dahulu?
Zyphra mengubah model ZAYA1‑8B berbasis autoregresif menjadi model difusi yang dapat menghasilkan blok 16 token sekaligus, dengan klaim percepatan decoding hingga 4,6× sampai 7,7× tergantung metode sampling. Pendekatan ini menggeser proses generasi teks dari urutan token satu‑per‑satu menjadi komputasi paralel, mengurangi hambatan bandwidth memori yang sering terjadi pada LLM tradisional.
Apa yang harus saya lakukan selanjutnya dalam latihan?
Jika terbukti stabil dalam penggunaan nyata, teknik ini berpotensi menurunkan biaya inferensi, mempercepat proses reinforcement learning, dan meningkatkan efisiensi model AI secara keseluruhan.
ZAYA1‑8B‑Diffusion‑Preview dibangun di atas model ZAYA1‑8B, sebuah model reasoning berbasis arsitektur mixture‑of‑experts (MoE). Model ini memiliki sedikit di atas 8 miliar parameter, tetapi hanya sekitar 760 juta parameter yang aktif saat inferensi, sehingga lebih hemat komputasi dibanding model dense dengan ukuran serupa.
Dalam arsitektur MoE, jaringan terdiri dari beberapa sub‑model kecil yang disebut "expert". Untuk setiap token, hanya sebagian expert yang diaktifkan. Pendekatan ini membantu menekan biaya komputasi tanpa mengorbankan performa secara signifikan.
Mengapa decoding LLM biasanya lambat
Sebagian besar LLM saat ini menggunakan metode autoregressive generation. Prosesnya sederhana tetapi tidak efisien untuk paralelisme:
Model memprediksi satu token berikutnya.
KV cache diperbarui dengan token tersebut.
Proses diulang untuk token berikutnya.
Karena setiap token bergantung pada token sebelumnya, proses ini harus berjalan secara berurutan. Hal ini sering menyebabkan bottleneck bandwidth memori ketika model terus‑menerus mengakses KV cache selama generasi teks.
Bagaimana model difusi menghasilkan 16 token sekaligus
Pendekatan difusi mengubah mekanisme decoding tersebut.
Alih‑alih memprediksi satu token per langkah, model mengusulkan blok kandidat token secara paralel. Dalam versi preview ini, satu langkah difusi menghasilkan 16 token sekaligus.
Alur kerjanya kira‑kira seperti ini:
Model membuat beberapa draf kandidat token untuk satu blok.
Sebuah sampler mengevaluasi kandidat tersebut.
Token yang diterima ditambahkan ke output, lalu proses diulang untuk blok berikutnya.
Karena token dalam satu blok berbagi awalan (prefix) dan keadaan KV cache yang sama, komputasi bisa dilakukan secara paralel dalam satu forward pass GPU. Ini menggeser pekerjaan dari proses yang terikat bandwidth memori menjadi komputasi paralel yang lebih cocok untuk GPU modern.
Dua strategi sampling dan perbedaan kecepatannya
Performa model bergantung pada metode sampling yang digunakan saat decoding.
Lossless sampler
Menggunakan aturan penerimaan mirip dengan speculative decoding.
Zyphra melaporkan sekitar 4,6× percepatan decoding dibanding metode autoregresif.
Dirancang untuk menjaga kualitas model tanpa penurunan evaluasi yang sistematis.
Logit‑mixing sampler
Menggabungkan distribusi logit dari model difusi dan autoregresif.
Meningkatkan tingkat penerimaan token.
Klaim percepatan hingga 7,7×, tetapi dengan kemungkinan penurunan kualitas dalam beberapa kasus.
Perlu dicatat bahwa angka tersebut sebagian besar berasal dari laporan internal Zyphra, sehingga benchmark independen masih diperlukan untuk memverifikasi performanya di berbagai skenario penggunaan.
Mengapa penggunaan GPU AMD menarik perhatian
Proyek ini juga menonjol karena menggunakan infrastruktur GPU AMD untuk pelatihannya—sesuatu yang relatif jarang dalam ekosistem AI modern yang didominasi Nvidia.
Zyphra menyebut model ini sebagai model bahasa difusi pertama yang dilatih di GPU AMD, menunjukkan bahwa pelatihan dan eksperimen LLM skala besar tidak harus bergantung pada satu vendor hardware saja.
Jika pendekatan ini terbukti efektif dan dapat direplikasi, persaingan di pasar hardware AI bisa menjadi lebih terbuka.
Peran Compressed Convolutional Attention (CCA)
ZAYA1‑8B juga menggunakan mekanisme yang disebut Compressed Convolutional Attention (CCA). Tujuannya adalah menurunkan biaya komputasi pada tahap perhatian (attention), terutama saat operasi paralel besar.
Hal ini penting untuk decoding difusi karena proses menghasilkan banyak token sekaligus mirip dengan fase prefill pada inferensi—fase yang biasanya sangat bergantung pada efisiensi mekanisme attention.
Dengan menekan biaya attention, CCA membantu membuat generasi multi‑token secara paralel menjadi lebih praktis dalam skala besar.
Dampaknya terhadap biaya inferensi
Jika percepatan decoding ini terbukti konsisten di sistem produksi, dampaknya bisa signifikan bagi ekonomi AI:
GPU dapat menghasilkan lebih banyak token per detik
biaya per token menjadi lebih rendah
latency untuk respons panjang berkurang
Namun Zyphra juga mencatat bahwa pipeline inferensi model difusi masih belum seoptimal sistem autoregresif yang sudah matang, sehingga hasil di dunia nyata mungkin berbeda dari pengukuran teoritis.
Mengapa ini penting untuk reinforcement learning
Banyak model reasoning modern dilatih menggunakan reinforcement learning dengan rollouts, yaitu proses menghasilkan banyak kandidat jawaban selama pelatihan.
Karena proses ini sangat bergantung pada kecepatan generasi, decoding yang lebih cepat dapat:
menurunkan biaya pelatihan RL
memungkinkan eksperimen test‑time compute yang lebih besar
meningkatkan jumlah jalur penalaran yang dapat dieksplorasi per prompt
Dalam praktiknya, proses generasi sering menjadi salah satu komponen biaya terbesar dalam pipeline pelatihan berbasis RL.
Arah baru dalam efisiensi model AI
ZAYA1‑8B‑Diffusion‑Preview menunjukkan tren yang semakin jelas dalam riset AI: bukan hanya membuat model lebih besar, tetapi juga membuatnya lebih efisien per dolar komputasi.
Pendekatan Zyphra menggabungkan beberapa strategi sekaligus:
arsitektur mixture‑of‑experts
decoding berbasis difusi
mekanisme attention yang lebih efisien
pelatihan pada ekosistem hardware alternatif
Jika pendekatan seperti ini terbukti stabil dan dapat diskalakan, cara industri mengoptimalkan model bahasa mungkin akan bergeser—dari sekadar mengejar ukuran model menuju peningkatan throughput, efisiensi biaya, dan pemanfaatan hardware.
zyphra.comZAYA1-8B-Diffusion-Preview: Efficient Parallel Decoding ...
venturebeat.comMeet ZAYA1-8B, a super efficient, open reasoning model trained on ...
gigazine.netA new spreading language model, 'ZAYA1-8B-Diffusion-Preview,' developed with an AMD AI chip, has emerged, transforming autoregressive models into spreading models.
phemex.comZyphra's AMD-Based Diffusion Model Boosts Speed by 7.7x - Phemex