GPT 5.5 के लिए सबसे साफ और मजबूत छोटा बेंचमार्क GDPval पर 84.9% है; OpenAI इसे 44 पेशों में स्पष्ट रूप से तय ज्ञान कार्य की परीक्षा बताता है।[1] Expert SWE पर 73.1% और BixBench पर 80.5% जैसे आंकड़े अलग अलग क्षेत्रों—कोडिंग और बायोइन्फॉर्मेटिक्स—से जुड़े हैं, इसलिए उन्हें GDPval से सीधे नहीं मिलाना चाहिए।[8][10] बड़े...
प्रकाशितकर्ताGPT-5.5 से संपादितGPT Image 2 से चित्र बनाए गए
GPT 5.5 के लिए सबसे साफ और मजबूत छोटा बेंचमार्क GDPval पर 84.9% है; OpenAI इसे 44 पेशों में स्पष्ट रूप से तय ज्ञान कार्य की परीक्षा बताता है।[1]
Expert SWE पर 73.1% और BixBench पर 80.5% जैसे आंकड़े अलग अलग क्षेत्रों—कोडिंग और बायोइन्फॉर्मेटिक्स—से जुड़े हैं, इसलिए उन्हें GDPval से सीधे नहीं मिलाना चाहिए।[8][10]
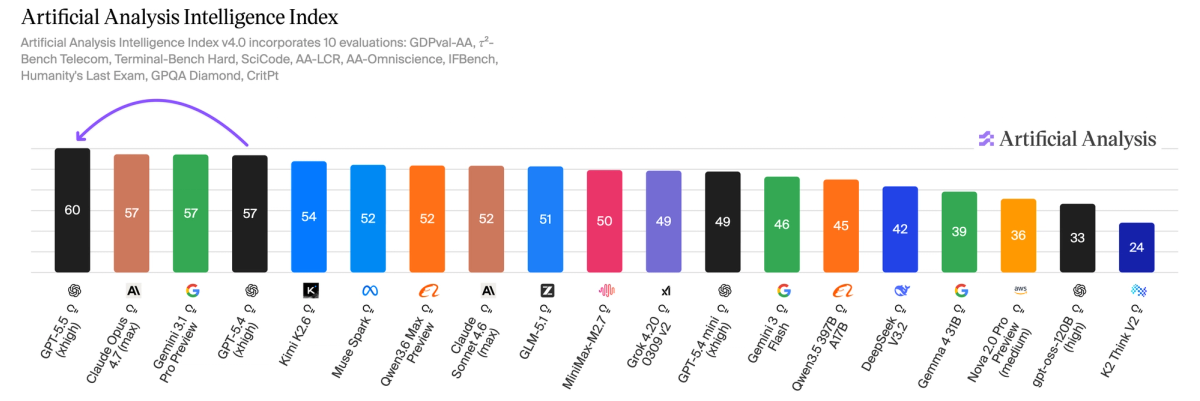
बड़े मॉडल तुलना के लिए Artificial Analysis उपयोगी संकेत देता है: GPT 5.5 वहां Intelligence Index में 3 अंकों की बढ़त के साथ आगे बताया गया है, लेकिन इसका अर्थ हर एक टेस्ट में जीत नहीं है।[3]
GPT-5.5-Benchmark erklärt: Was 84,9 % auf GDPval wirklich bedeutenKI-generierte Illustration zum Vergleich von GPT-5.5-Benchmarks.
AI संकेत
Create a landscape editorial hero image for this Studio Global article: GPT-5.5-Benchmark erklärt: Was 84,9 % auf GDPval wirklich bedeuten. Article summary: Für eine knappe, belastbare Einordnung ist 84,9 % auf GDPval der beste GPT 5.5 Wert: OpenAI nennt ihn selbst und beschreibt GDPval als Test für klar spezifizierte Wissensarbeit über 44 Berufe.. Topic tags: ai, openai, chatgpt, gpt 5, benchmarks. Reference image context from search candidates: Reference image 1: visual subject " GPT-5.5 tops the Artificial Analysis Intelligen" source context "OpenAI's GPT-5.5 is the new leading AI model - Artificial Analysis" Reference image 2: visual subject " GPT-5.5 tops the Artificial Analysis Intelligen" source context "OpenAI's GPT-5.5 is the new leading AI model - Artificial Analysis" Reference image 2: visual subject "![Image 1](https://cdn.sanity.io/images/6vfeftx9/articles/9052d745e6337cd4369bde9219bcf511bebec944-4644x1551.png?
openai.com
अगर सवाल है कि GPT-5.5 का “मुख्य बेंचमार्क” क्या है, तो सबसे छोटा और सावधान जवाब है: GDPval पर 84.9%। OpenAI के अनुसार GDPval ऐसे AI एजेंटों की क्षमता परखता है जो 44 पेशों में साफ-साफ परिभाषित ज्ञान-कार्य तैयार करते हैं, और GPT-5.5 इस पर 84.9% स्कोर करता है।
लेकिन यही पूरी कहानी नहीं है। यह स्कोर कोई सार्वभौमिक “AI बुद्धिमत्ता” या हर काम की गुणवत्ता का अंतिम प्रमाणपत्र नहीं है। यह खास तौर पर कामकाजी ज्ञान-कार्य, निर्देश समझने और तय परिणाम तैयार करने की क्षमता के बारे में बताता है।
सबसे उपयोगी छोटा जवाब: GDPval पर 84.9%
यदि किसी रिपोर्ट, प्रेजेंटेशन या तुलना में केवल एक आंकड़ा देना हो, तो इसे इस तरह कहना सबसे ठीक रहेगा:
OpenAI के अनुसार GPT-5.5 ने GDPval पर 84.9% स्कोर किया; GDPval 44 पेशों में स्पष्ट रूप से तय ज्ञान-कार्य तैयार करने की क्षमता को परखता है।
Studio Global AI
अपना शोध जारी रखें
इस पृष्ठ में एक स्रोत-समर्थित उत्तर शामिल है जिसे आप Studio Global के अंदर जारी रख सकते हैं।
"GPT-5.5 बेंचमार्क: GDPval पर 84.9% का असली मतलब" का संक्षिप्त उत्तर क्या है?
GPT 5.5 के लिए सबसे साफ और मजबूत छोटा बेंचमार्क GDPval पर 84.9% है; OpenAI इसे 44 पेशों में स्पष्ट रूप से तय ज्ञान कार्य की परीक्षा बताता है।[1]
सबसे पहले सत्यापित करने योग्य मुख्य बिंदु क्या हैं?
GPT 5.5 के लिए सबसे साफ और मजबूत छोटा बेंचमार्क GDPval पर 84.9% है; OpenAI इसे 44 पेशों में स्पष्ट रूप से तय ज्ञान कार्य की परीक्षा बताता है।[1] Expert SWE पर 73.1% और BixBench पर 80.5% जैसे आंकड़े अलग अलग क्षेत्रों—कोडिंग और बायोइन्फॉर्मेटिक्स—से जुड़े हैं, इसलिए उन्हें GDPval से सीधे नहीं मिलाना चाहिए।[8][10]
मुझे अभ्यास में आगे क्या करना चाहिए?
बड़े मॉडल तुलना के लिए Artificial Analysis उपयोगी संकेत देता है: GPT 5.5 वहां Intelligence Index में 3 अंकों की बढ़त के साथ आगे बताया गया है, लेकिन इसका अर्थ हर एक टेस्ट में जीत नहीं है।[3]
यह आंकड़ा GPT-5.5 को एक “कामकाजी मॉडल” के रूप में समझने में मदद करता है। फिर भी GDPval को कोडिंग टेस्ट, बायोइन्फॉर्मेटिक्स टेस्ट या किसी बाहरी मॉडल-रैंकिंग के बराबर नहीं मानना चाहिए। अलग-अलग बेंचमार्क अलग-अलग सवाल पूछते हैं।
मुख्य सार्वजनिक आंकड़े एक नजर में
बेंचमार्क या तुलना
बताया गया स्कोर
यह क्या मापता है
कैसे समझें
GDPval
84.9%
44 पेशों में स्पष्ट रूप से तय ज्ञान-कार्य
OpenAI की GPT-5.5 घोषणा में सीधे बताया गया, इसलिए सामान्य संदर्भ के लिए सबसे साफ छोटा बेंचमार्क।
Expert-SWE
73.1%
कोडिंग कार्य; एक रिपोर्ट के मुताबिक यह अनुमानित 20 घंटे के काम वाली कोडिंग टास्क के लिए कंपनी की आंतरिक परीक्षा है
सॉफ्टवेयर विकास के लिए GDPval से ज्यादा प्रासंगिक, लेकिन GDPval से सीधे तुलना योग्य नहीं।
BixBench
80.5%
वास्तविक दुनिया के बायोइन्फॉर्मेटिक्स कार्य
बायोइन्फॉर्मेटिक्स के संदर्भ में उपयोगी, लेकिन उपलब्ध स्रोतों में यह OpenAI के GDPval दावे जितना प्रत्यक्ष रूप से पुष्ट नहीं है।
Artificial Analysis Intelligence Index
पहला स्थान, 3 अंकों की बढ़त
Artificial Analysis का बाहरी मॉडल-इंडेक्स
व्यापक मॉडल-तुलना में मददगार, पर यह OpenAI का एकल आधिकारिक बेंचमार्क नहीं है।
इन प्रतिशतों को सीधे क्यों नहीं मिलाना चाहिए
84.9%, 73.1% और 80.5% देखने में एक ही तालिका के नंबर लग सकते हैं, लेकिन वे अलग-अलग परीक्षाओं के परिणाम हैं।
GDPval पर 84.9%: कई पेशों में तय ज्ञान-कार्य तैयार करने की क्षमता से जुड़ा है।
Expert-SWE पर 73.1%: कोडिंग कार्यों की आंतरिक परीक्षा से जुड़ा बताया गया है।
BixBench पर 80.5%: बायोइन्फॉर्मेटिक्स कार्यों से जुड़ा बताया गया है।
इसलिए बेहतर सवाल यह नहीं है कि “सबसे बड़ा प्रतिशत कौन-सा है?” बेहतर सवाल है: “मेरे इस्तेमाल के लिए सही बेंचमार्क कौन-सा है?” सामान्य ऑफिस या ज्ञान-कार्य के लिए GDPval ज्यादा नजदीक बैठता है; सॉफ्टवेयर इंजीनियरिंग के लिए Expert-SWE अधिक उपयोगी संकेत दे सकता है; और बायोइन्फॉर्मेटिक्स के लिए BixBench ज्यादा विषय-संबंधी है।
Artificial Analysis वाला दावा क्या बताता है
Artificial Analysis के अनुसार GPT-5.5 उसके Intelligence Index में 3 अंकों की बढ़त के साथ शीर्ष पर है। उसी रिपोर्ट में यह भी बताया गया है कि OpenAI पांच headline evaluations में आगे है और तीन अन्य में Gemini 3.1 Pro Preview से पीछे है।
यानी बाहरी इंडेक्स में पहला स्थान मिलने का मतलब यह नहीं कि GPT-5.5 हर एक उप-परीक्षा में सबसे आगे है। इसका अर्थ केवल इतना है कि Artificial Analysis की अपनी पद्धति के अनुसार कुल मिलाकर GPT-5.5 आगे रखा गया है।
सुर्खियों वाले अकेले आंकड़ों से सावधान रहें
कुछ रिपोर्टों में GPT-5.5 के लिए दूसरे स्कोर भी दिखते हैं, जैसे legal AI क्षमताओं के संदर्भ में 91.7% या agentic coding के संदर्भ में 82.7%। ये आंकड़े अपने-अपने खास क्षेत्र में रोचक हो सकते हैं, लेकिन सामान्य बेंचमार्क उत्तर के लिए तब तक कम उपयोगी हैं जब तक टेस्ट का ढांचा, तुलना-समूह और मापी गई क्षमता उतनी ही स्पष्ट न हो जितनी GDPval के मामले में है।
कौन-सा आंकड़ा उद्धृत करें?
ज्यादातर सामान्य संदर्भों में सबसे साफ वाक्य यह होगा:
GPT-5.5 ने OpenAI के अनुसार GDPval पर 84.9% स्कोर किया; GDPval 44 पेशों में स्पष्ट रूप से परिभाषित ज्ञान-कार्य तैयार करने की क्षमता को जांचता है।
अगर संदर्भ ज्यादा खास है, तो बेंचमार्क भी उसी हिसाब से चुनें:
सामान्य ज्ञान-कार्य: GDPval पर 84.9%।
सॉफ्टवेयर विकास: Expert-SWE पर 73.1%।
बायोइन्फॉर्मेटिक्स: BixBench पर 80.5%, साथ में स्रोत-सीमा की सावधानी।
व्यापक मॉडल-तुलना: Artificial Analysis Intelligence Index में 3 अंकों की बढ़त के साथ पहला स्थान।
निष्कर्ष
GPT-5.5 के लिए सबसे भरोसेमंद छोटा बेंचमार्क GDPval पर 84.9% है। यह OpenAI की ओर से सीधे बताया गया आंकड़ा है और इसका माप-क्षेत्र भी स्पष्ट है: 44 पेशों में तय ज्ञान-कार्य तैयार करना। बाकी स्कोर बेकार नहीं हैं, लेकिन उन्हें हमेशा उनके अपने बेंचमार्क और उपयोग-क्षेत्र के साथ ही पढ़ना चाहिए।
mexc.com
OpenAI’s GPT-5.5 Launches With 91.7% Benchmark Score | MEXC News
यह आंकड़ा GPT-5.5 को एक “कामकाजी मॉडल” के रूप में समझने में मदद करता है। फिर भी GDPval को कोडिंग टेस्ट, बायोइन्फॉर्मेटिक्स टेस्ट या किसी बाहरी मॉडल-रैंकिंग के बराबर नहीं मानना चाहिए। अलग-अलग बेंचमार्क अलग-अलग सवाल पूछते हैं।
मुख्य सार्वजनिक आंकड़े एक नजर में
बेंचमार्क या तुलना
बताया गया स्कोर
यह क्या मापता है
कैसे समझें
GDPval
84.9%
44 पेशों में स्पष्ट रूप से तय ज्ञान-कार्य
OpenAI की GPT-5.5 घोषणा में सीधे बताया गया, इसलिए सामान्य संदर्भ के लिए सबसे साफ छोटा बेंचमार्क।
Expert-SWE
73.1%
कोडिंग कार्य; एक रिपोर्ट के मुताबिक यह अनुमानित 20 घंटे के काम वाली कोडिंग टास्क के लिए कंपनी की आंतरिक परीक्षा है
सॉफ्टवेयर विकास के लिए GDPval से ज्यादा प्रासंगिक, लेकिन GDPval से सीधे तुलना योग्य नहीं।
BixBench
80.5%
वास्तविक दुनिया के बायोइन्फॉर्मेटिक्स कार्य
बायोइन्फॉर्मेटिक्स के संदर्भ में उपयोगी, लेकिन उपलब्ध स्रोतों में यह OpenAI के GDPval दावे जितना प्रत्यक्ष रूप से पुष्ट नहीं है।
Artificial Analysis Intelligence Index
पहला स्थान, 3 अंकों की बढ़त
Artificial Analysis का बाहरी मॉडल-इंडेक्स
व्यापक मॉडल-तुलना में मददगार, पर यह OpenAI का एकल आधिकारिक बेंचमार्क नहीं है।
इन प्रतिशतों को सीधे क्यों नहीं मिलाना चाहिए
84.9%, 73.1% और 80.5% देखने में एक ही तालिका के नंबर लग सकते हैं, लेकिन वे अलग-अलग परीक्षाओं के परिणाम हैं।
GDPval पर 84.9%: कई पेशों में तय ज्ञान-कार्य तैयार करने की क्षमता से जुड़ा है।
Expert-SWE पर 73.1%: कोडिंग कार्यों की आंतरिक परीक्षा से जुड़ा बताया गया है।
BixBench पर 80.5%: बायोइन्फॉर्मेटिक्स कार्यों से जुड़ा बताया गया है।
इसलिए बेहतर सवाल यह नहीं है कि “सबसे बड़ा प्रतिशत कौन-सा है?” बेहतर सवाल है: “मेरे इस्तेमाल के लिए सही बेंचमार्क कौन-सा है?” सामान्य ऑफिस या ज्ञान-कार्य के लिए GDPval ज्यादा नजदीक बैठता है; सॉफ्टवेयर इंजीनियरिंग के लिए Expert-SWE अधिक उपयोगी संकेत दे सकता है; और बायोइन्फॉर्मेटिक्स के लिए BixBench ज्यादा विषय-संबंधी है।
Artificial Analysis वाला दावा क्या बताता है
Artificial Analysis के अनुसार GPT-5.5 उसके Intelligence Index में 3 अंकों की बढ़त के साथ शीर्ष पर है। उसी रिपोर्ट में यह भी बताया गया है कि OpenAI पांच headline evaluations में आगे है और तीन अन्य में Gemini 3.1 Pro Preview से पीछे है।
यानी बाहरी इंडेक्स में पहला स्थान मिलने का मतलब यह नहीं कि GPT-5.5 हर एक उप-परीक्षा में सबसे आगे है। इसका अर्थ केवल इतना है कि Artificial Analysis की अपनी पद्धति के अनुसार कुल मिलाकर GPT-5.5 आगे रखा गया है।
सुर्खियों वाले अकेले आंकड़ों से सावधान रहें
कुछ रिपोर्टों में GPT-5.5 के लिए दूसरे स्कोर भी दिखते हैं, जैसे legal AI क्षमताओं के संदर्भ में 91.7% या agentic coding के संदर्भ में 82.7%। ये आंकड़े अपने-अपने खास क्षेत्र में रोचक हो सकते हैं, लेकिन सामान्य बेंचमार्क उत्तर के लिए तब तक कम उपयोगी हैं जब तक टेस्ट का ढांचा, तुलना-समूह और मापी गई क्षमता उतनी ही स्पष्ट न हो जितनी GDPval के मामले में है।
कौन-सा आंकड़ा उद्धृत करें?
ज्यादातर सामान्य संदर्भों में सबसे साफ वाक्य यह होगा:
GPT-5.5 ने OpenAI के अनुसार GDPval पर 84.9% स्कोर किया; GDPval 44 पेशों में स्पष्ट रूप से परिभाषित ज्ञान-कार्य तैयार करने की क्षमता को जांचता है।
अगर संदर्भ ज्यादा खास है, तो बेंचमार्क भी उसी हिसाब से चुनें:
सामान्य ज्ञान-कार्य: GDPval पर 84.9%।
सॉफ्टवेयर विकास: Expert-SWE पर 73.1%।
बायोइन्फॉर्मेटिक्स: BixBench पर 80.5%, साथ में स्रोत-सीमा की सावधानी।
व्यापक मॉडल-तुलना: Artificial Analysis Intelligence Index में 3 अंकों की बढ़त के साथ पहला स्थान।
निष्कर्ष
GPT-5.5 के लिए सबसे भरोसेमंद छोटा बेंचमार्क GDPval पर 84.9% है। यह OpenAI की ओर से सीधे बताया गया आंकड़ा है और इसका माप-क्षेत्र भी स्पष्ट है: 44 पेशों में तय ज्ञान-कार्य तैयार करना। बाकी स्कोर बेकार नहीं हैं, लेकिन उन्हें हमेशा उनके अपने बेंचमार्क और उपयोग-क्षेत्र के साथ ही पढ़ना चाहिए।
mexc.com
OpenAI’s GPT-5.5 Launches With 91.7% Benchmark Score | MEXC News