उत्तरप्रकाशित17 स्रोत
Qualcomm Adreno Neural Fusion: AI रेंडरिंग अब सीधे मोबाइल GPU के भीतर
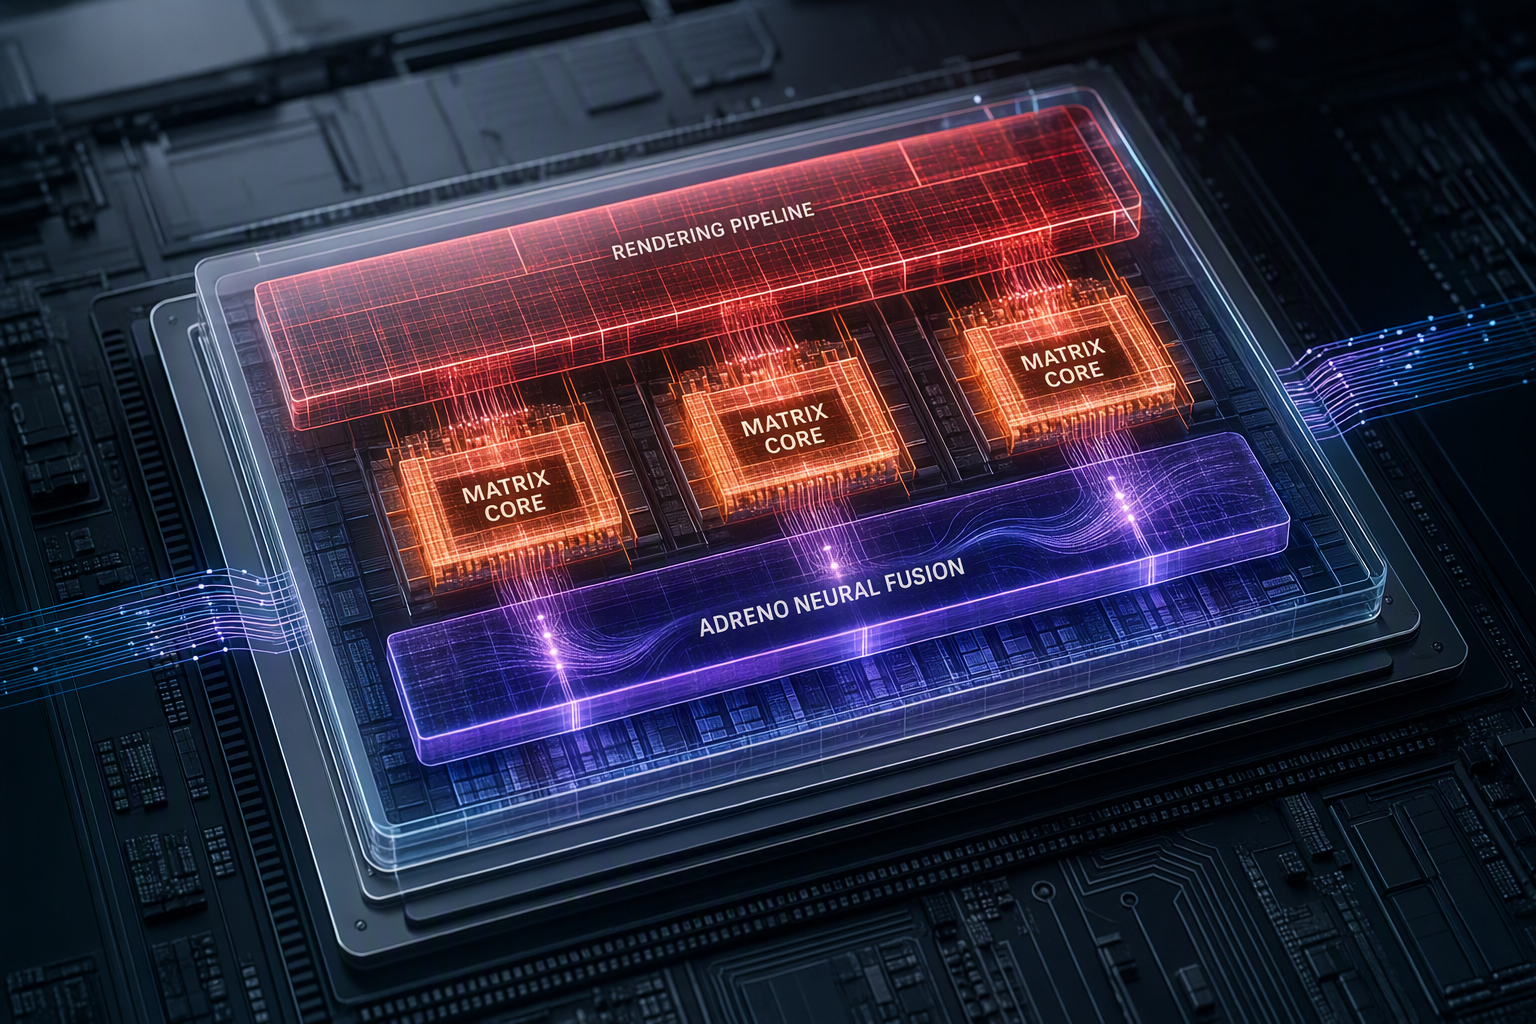
नई तीन स्लाइस Adreno GPU संरचना में हर स्लाइस के साथ एक समर्पित Matrix Core होगा, जो AI सुपर रिज़ॉल्यूशन और फ्रेम जनरेशन को ग्राफिक्स पाइपलाइन के भीतर चलाएगा। GPU में 1.45GHz तक की क्लॉक स्पीड और 18MB Adreno High Performance Memory (HPM) दी गई है, ताकि रेंडरिंग डेटा GPU के पास रहे और सिस्टम मेमोरी पर निर्भरता घटे। Q...
प्रकाशितकर्ताGPT-5.6 Terra से संपादितGPT Image 2 से चित्र बनाए गए
शोध उत्तर
मुख्य निष्कर्ष
- नई तीन स्लाइस Adreno GPU संरचना में हर स्लाइस के साथ एक समर्पित Matrix Core होगा, जो AI सुपर रिज़ॉल्यूशन और फ्रेम जनरेशन को ग्राफिक्स पाइपलाइन के भीतर चलाएगा।
- GPU में 1.45GHz तक की क्लॉक स्पीड और 18MB Adreno High Performance Memory (HPM) दी गई है, ताकि रेंडरिंग डेटा GPU के पास रहे और सिस्टम मेमोरी पर निर्भरता घटे।
- Qualcomm ने Unity और Unreal Engine समर्थन की बात कही है। कंपनी के पावर व इमेज क्वालिटी दावे अभी स्वतंत्र परीक्षणों से सत्यापित नहीं हुए हैं।
AI संकेत
openai.comCreate a landscape editorial hero image for this Studio Global article: How does Qualcomm’s next-generation flagship Snapdragon Adreno GPU integrate three dedicated Matrix Cores and Adreno Neural Fusion directly. Article summary: Qualcomm is moving AI graphics from a separate NPU round trip into the GPU itself: each of the new Adreno GPU’s three rendering slices contains a dedicated Matrix Core, and Neural Fusion coordinates those cores with rend. Topic tags: general, general web, documentation. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts with fake
Qualcomm की Adreno Neural Fusion तकनीक का मूल विचार यह है कि गेमिंग के लिए AI रेंडरिंग को GPU के बाहर अलग काम की तरह न चलाया जाए। इसके बजाय, AI सुपर-रिज़ॉल्यूशन और फ्रेम जनरेशन जैसे काम सीधे Adreno GPU की ग्राफिक्स पाइपलाइन में किए जाएं। कंपनी का कहना है कि इससे मोबाइल गेम्स में बेहतर तस्वीर, कम देरी और कम बिजली खपत मिल सकती है। 1
4
हर GPU स्लाइस के साथ एक Matrix Core
आने वाली Adreno डिजाइन में तीन GPU स्लाइस हैं और हर स्लाइस के साथ एक समर्पित Adreno Matrix Core जोड़ा गया है। ये AI-कंप्यूट ब्लॉक हैं, जिन्हें उन्नत ग्राफिक्स मॉडल को GPU के भीतर ही चलाने के लिए बनाया गया है। 2
4
यह व्यवस्था इसलिए अहम है क्योंकि सुपर-रिज़ॉल्यूशन और फ्रेम जनरेशन को रेंडर हो चुके फ्रेम, मोशन डेटा, टाइल और बीच के रेंडरिंग परिणामों तक तेज पहुंच चाहिए होती है। AI हार्डवेयर को ग्राफिक्स आर्किटेक्चर के भीतर रखने से डेटा को अलग प्रोसेसिंग ब्लॉकों के बीच भेजने और उनके तालमेल की जरूरत कम हो सकती है। Qualcomm के मुताबिक, इससे लेटेंसी और पावर ओवरहेड घटता है। 1
3
Neural Fusion वास्तव में क्या करता है?
Adreno Neural Fusion वह संयुक्त रेंडरिंग वर्कफ़्लो है जिसमें शामिल हैं:
- न्यूरल प्रोसेसिंग,
- AI सुपर-रिज़ॉल्यूशन,
- और फ्रेम जनरेशन।
1
सरल शब्दों में, कोई गेम कम आंतरिक रिज़ॉल्यूशन पर फ्रेम रेंडर कर सकता है और फिर AI मॉडल उससे उच्च गुणवत्ता वाली अंतिम तस्वीर बना सकता है। इसी तरह, रेंडर किए गए फ्रेमों की जानकारी के आधार पर अतिरिक्त फ्रेम बनाए जा सकते हैं। उद्देश्य यह है कि हर पिक्सल और हर फ्रेम को पारंपरिक तरीके से पूरी तरह रेंडर किए बिना भी स्क्रीन पर तस्वीर अधिक विस्तृत और गेमप्ले अधिक स्मूद दिखे।
Qualcomm का दावा है कि यह तकनीक तस्वीर को ज्यादा शार्प और स्थिर बनाएगी तथा शिमरिंग, फ्लिकर और घोस्टिंग जैसे विजुअल आर्टिफैक्ट कम करेगी। हालांकि, अलग-अलग गेम में गुणवत्ता और इनपुट लेटेंसी का परिणाम उसके इंटीग्रेशन पर निर्भर करेगा; अभी स्वतंत्र बेंचमार्क उपलब्ध नहीं हैं। 1
13
18MB Adreno HPM का महत्व
GPU में 18MB Adreno High Performance Memory (HPM) भी है। इसे GPU के पास मौजूद कम-लेटेंसी मेमोरी के रूप में बताया गया है। इसका इस्तेमाल टाइल-आधारित रेंडरिंग डेटा, फ्रेम बफर और कंप्यूट वर्कलोड को स्थानीय रूप से रखने के लिए किया जा सकता है, ताकि सिस्टम मेमोरी तक बार-बार पहुंचने की जरूरत घटे। 1
4
मुख्य मेमोरी पर कम डेटा ट्रैफिक से बैंडविड्थ की मांग, लेटेंसी और ऊर्जा खर्च कम हो सकता है—खासकर उन वर्कलोड में जो इंटरमीडिएट इमेज डेटा को कई बार इस्तेमाल करते हैं। रिपोर्टों के अनुसार, तीन-स्लाइस GPU की पीक क्लॉक 1.45GHz है, जो पिछली डिजाइन के 1.2GHz से अधिक है। इस आर्किटेक्चर के साथ करीब 12% पावर-एफिशिएंसी सुधार का भी उल्लेख किया गया है। 2
5
40% कम GPU पावर का दावा: इसे कैसे समझें
Qualcomm ने प्रासंगिक AI-रेंडरिंग स्थितियों में पिछले समाधान की तुलना में GPU पावर खपत 40% तक कम होने का दावा किया है। 13
इसे हर फोन, हर गेम, हर रिज़ॉल्यूशन और हर तापमान पर बैटरी लाइफ में 40% बढ़ोतरी नहीं मानना चाहिए। असली नतीजे गेम के इंटीग्रेशन, AI मॉडल, डिस्प्ले रिफ्रेश रेट, फोन की कूलिंग और इस बात पर निर्भर होंगे कि गेम GPU, CPU या मेमोरी में से किससे सीमित है। रिटेल डिवाइस और समर्थित गेम्स के स्वतंत्र परीक्षण तक ये आंकड़े कंपनी के लक्ष्य और उसके माप के रूप में देखना ज्यादा उचित है।
Unity और Unreal Engine का समर्थन
Qualcomm का कहना है कि Adreno Neural Fusion को Unity और Unreal Engine दोनों में समर्थन मिलेगा। 1
4 इंजन स्तर का समर्थन स्टूडियो के लिए इसे अपनाना आसान बना सकता है, लेकिन इसका अर्थ यह नहीं कि हर गेम अपने-आप इस फीचर का उपयोग करेगा या सभी गेम्स में समान विजुअल व प्रदर्शन लाभ मिलेगा।
Snapdragon की अगली पीढ़ी की रणनीति में इसकी जगह
यह GPU घोषणा Qualcomm के अगली पीढ़ी के Oryon CPU के प्रीव्यू के साथ आई है, जिसके 5GHz तक पहुंचने का कंपनी का दावा है। साथ ही, Qualcomm ने FlexCache पेश किया है—एक कैश आर्किटेक्चर जिसमें अलग-अलग प्रकार के CPU कोर जरूरत के अनुसार एक साझा कैश पूल का उपयोग कर सकते हैं। इसका उद्देश्य बड़े वर्कलोड को कैश में बनाए रखना और उन्हें बार-बार धीमी मेमोरी में जाने से रोकना है।
इन घोषणाओं से Qualcomm की व्यापक हेटेरोजीनियस-कंप्यूटिंग रणनीति सामने आती है: ग्राफिक्स के पास वाले AI काम Matrix Cores सहित GPU संभाले, जबकि CPU और FlexCache सामान्य ऐप प्रतिक्रिया, मल्टीटास्किंग और बदलते वर्कलोड में मदद करें। कंपनी ने 22 से 24 सितंबर को माउई में Snapdragon Summit तय किया था, जहां Hexagon NPU समेत प्लेटफॉर्म के और विवरण आने की उम्मीद थी। 11
अभी क्या पता नहीं है?
आर्किटेक्चर का खाका सामने आ चुका है, लेकिन कुछ अहम सवाल बाकी हैं:
- इस Adreno डिजाइन को किन अंतिम Snapdragon उत्पादों में शामिल किया जाएगा?
- कौन से गेम Neural Fusion सक्षम करके लॉन्च होंगे?
- अलग-अलग गेम्स में सुपर-रिज़ॉल्यूशन और फ्रेम जनरेशन की गुणवत्ता व लेटेंसी कैसी होगी?
- फोन के लंबे गेमिंग सत्रों में थर्मल सीमा के तहत पावर बचत के दावे कितने टिकेंगे?
- GPU के Matrix Cores वाले ग्राफिक्स-AI कार्य और SoC के दूसरे हिस्सों में होने वाले ऑन-डिवाइस AI कार्यों का बंटवारा कैसे होगा?
मुख्य बदलाव स्पष्ट है: Qualcomm AI रेंडरिंग को बाहरी ऐड-ऑन के बजाय GPU का मूल हिस्सा बनाना चाहता है। असली परीक्षा तब होगी जब बाजार में आने वाले फोन और समर्थित गेम यह दिखाएं कि इससे लगातार बेहतर इमेज क्वालिटी, स्मूद गेमप्ले और मापने लायक बैटरी बचत मिलती है या नहीं।
Studio Global AI
अपना शोध जारी रखें
इस पृष्ठ में एक स्रोत-समर्थित उत्तर शामिल है जिसे आप Studio Global के अंदर जारी रख सकते हैं।
लोग पूछते भी हैं
"Qualcomm Adreno Neural Fusion: AI रेंडरिंग अब सीधे मोबाइल GPU के भीतर" का संक्षिप्त उत्तर क्या है?
नई तीन स्लाइस Adreno GPU संरचना में हर स्लाइस के साथ एक समर्पित Matrix Core होगा, जो AI सुपर रिज़ॉल्यूशन और फ्रेम जनरेशन को ग्राफिक्स पाइपलाइन के भीतर चलाएगा।
सबसे पहले सत्यापित करने योग्य मुख्य बिंदु क्या हैं?
नई तीन स्लाइस Adreno GPU संरचना में हर स्लाइस के साथ एक समर्पित Matrix Core होगा, जो AI सुपर रिज़ॉल्यूशन और फ्रेम जनरेशन को ग्राफिक्स पाइपलाइन के भीतर चलाएगा। GPU में 1.45GHz तक की क्लॉक स्पीड और 18MB Adreno High Performance Memory (HPM) दी गई है, ताकि रेंडरिंग डेटा GPU के पास रहे और सिस्टम मेमोरी पर निर्भरता घटे।
मुझे अभ्यास में आगे क्या करना चाहिए?
Qualcomm ने Unity और Unreal Engine समर्थन की बात कही है। कंपनी के पावर व इमेज क्वालिटी दावे अभी स्वतंत्र परीक्षणों से सत्यापित नहीं हुए हैं।
सूत्र
9to5google.comQualcomm's next premium chip has an Adreno Neural ...
xenospectrum.comQualcomm Debuts Adreno Neural Fusion: AI Cores Built ...
hothardware.comQualcomm Unveils Adreno Neural Fusion To Supercharge Mobile Gaming