उत्तरप्रकाशित15 स्रोत
टेनसेंट का Hy-Memory: AI एजेंटों के लिए एक क्रांतिकारी स्मृति तंत्र
Hy Memory टेनसेंट हुनयुआन द्वारा OpenClaw प्रकार के दीर्घकालिक सहयोगी AI एजेंटों के लिए लॉन्च किया गया एक मेमोरी प्लगइन है, जिसे एजेंटों के 'दूसरे दिमाग़' के रूप में वर्णित किया गया है [7][8]। OpenClaw द्वारा सादे Markdown फ़ाइलों में मेमोरी संग्रहीत करने की पारंपरिक विधि के विपरीत, Hy Memory एक 6 परत मेमोरी ढाँचा,...
प्रकाशितकर्ताDeepSeek-V4-Pro से संपादितGPT Image 1.5 से चित्र बनाए गए
शोध उत्तर
मुख्य निष्कर्ष
- Hy Memory टेनसेंट हुनयुआन द्वारा OpenClaw प्रकार के दीर्घकालिक सहयोगी AI एजेंटों के लिए लॉन्च किया गया एक मेमोरी प्लगइन है, जिसे एजेंटों के 'दूसरे दिमाग़' के रूप में वर्णित किया गया है [7][8]।
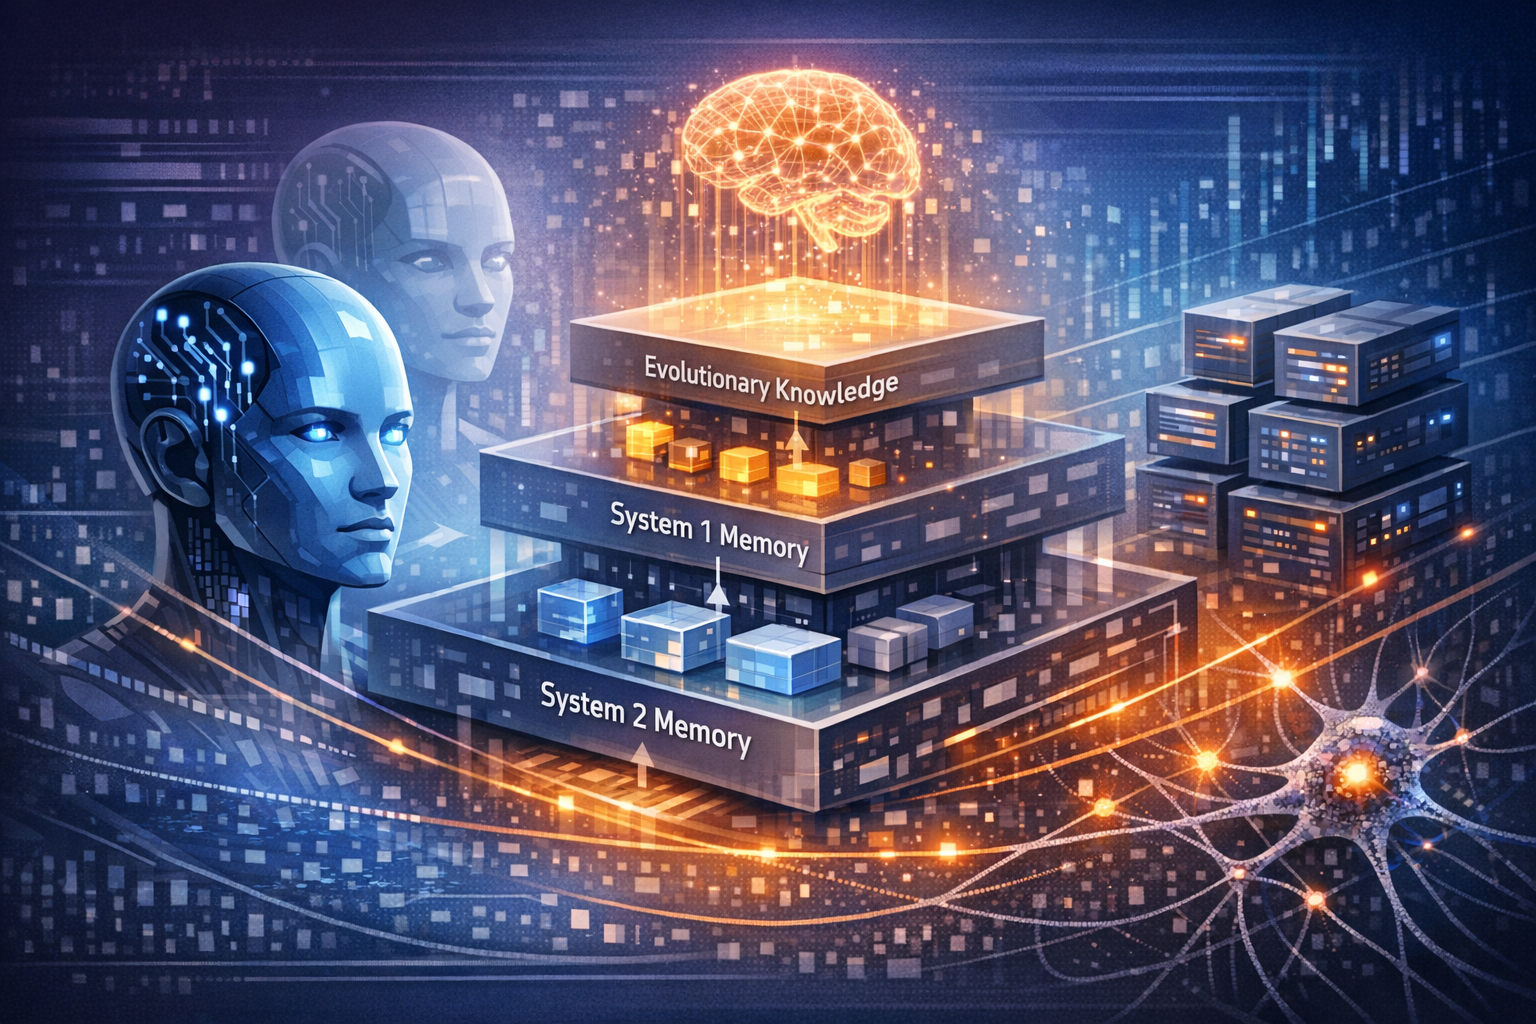
- OpenClaw द्वारा सादे Markdown फ़ाइलों में मेमोरी संग्रहीत करने की पारंपरिक विधि के विपरीत, Hy Memory एक 6 परत मेमोरी ढाँचा, System 1/System 2 दोहरी प्रणाली और विकास श्रृंखला तंत्र जोड़ता है [4][6][8]।
- प्रदर्शन परीक्षणों में, Hy Memory ने मेमोरी प्रविष्टियों में 70% से अधिक की कमी, सूचना घनत्व में 45% से अधिक की वृद्धि, और टोकन खपत में 35% की कमी दिखाई है। इसकी लेखन गति Graphiti से 8 गुना तेज़ बताई गई है [5][6][7]।
AI संकेत
openai.comCreate a landscape editorial hero image for this Studio Global article: What is Tencent's Hy-Memory plugin, and how does its three-tier, six-level, System 1/System 2 memory architecture (including the evolutionar. Article summary: Here is the full answer:. Topic tags: general, academic, documentation, general web. Reference image context from search candidates: Reference image 1: visual subject "# Tencent Open-Sources TencentDB Agent Memory: A 4-Tier Local Memory Pipeline for AI Agents. Tencent has released TencentDB Agent Memory, an open-source memory system for AI agents" source context "Tencent Open-Sources TencentDB Agent Memory: A 4-Tier Local ..." Reference image 2: visual subject "# Tencent Open-Sources TencentDB Agent Memory: A 4-Tier Local Memory Pipeline for AI Agents. Tencent has released TencentDB Agent Memory, an open-source memory system for AI agents" source context "Tence
कल्पना कीजिए कि आपका AI असिस्टेंट आपकी कही हर बात को बिखरे हुए पन्नों पर नोट करने के बजाय, एक सुव्यवस्थित डिजिटल डायरी में दर्ज कर रहा है, जहाँ पुरानी और नई जानकारियाँ आपस में जुड़ी रहती हैं और वह आपकी आदतों व पसंद को लगातार बेहतर ढंग से समझता जाता है। यही मूल विचार है टेनसेंट के Hy-Memory का, जिसे OpenClaw जैसे दीर्घकालिक सहयोगी AI एजेंटों को एक शक्तिशाली "दूसरा दिमाग़" देने के लिए डिज़ाइन किया गया है ।
OpenClaw का मूलभूत तरीका मेमोरी को साधारण Markdown फ़ाइलों में संजोना है । लेकिन Hy-Memory इसे एक क्रांतिकारी मोड़ देता है। यह एक 6-स्तरीय मेमोरी ढाँचा, System 1/System 2 नामक दोहरी प्रणाली और एक विकास-श्रृंखला तंत्र (evolutionary chain mechanism) पेश करता है, जो AI की याददाश्त को पहले से कहीं अधिक संरचित और सटीक बनाता है ।
Studio Global AI
अपना शोध जारी रखें
इस पृष्ठ में एक स्रोत-समर्थित उत्तर शामिल है जिसे आप Studio Global के अंदर जारी रख सकते हैं।
लोग पूछते भी हैं
"टेनसेंट का Hy-Memory: AI एजेंटों के लिए एक क्रांतिकारी स्मृति तंत्र" का संक्षिप्त उत्तर क्या है?
Hy Memory टेनसेंट हुनयुआन द्वारा OpenClaw प्रकार के दीर्घकालिक सहयोगी AI एजेंटों के लिए लॉन्च किया गया एक मेमोरी प्लगइन है, जिसे एजेंटों के 'दूसरे दिमाग़' के रूप में वर्णित किया गया है [7][8]।
सबसे पहले सत्यापित करने योग्य मुख्य बिंदु क्या हैं?
Hy Memory टेनसेंट हुनयुआन द्वारा OpenClaw प्रकार के दीर्घकालिक सहयोगी AI एजेंटों के लिए लॉन्च किया गया एक मेमोरी प्लगइन है, जिसे एजेंटों के 'दूसरे दिमाग़' के रूप में वर्णित किया गया है [7][8]। OpenClaw द्वारा सादे Markdown फ़ाइलों में मेमोरी संग्रहीत करने की पारंपरिक विधि के विपरीत, Hy Memory एक 6 परत मेमोरी ढाँचा, System 1/System 2 दोहरी प्रणाली और विकास श्रृंखला तंत्र जोड़ता है [4][6][8]।
मुझे अभ्यास में आगे क्या करना चाहिए?
प्रदर्शन परीक्षणों में, Hy Memory ने मेमोरी प्रविष्टियों में 70% से अधिक की कमी, सूचना घनत्व में 45% से अधिक की वृद्धि, और टोकन खपत में 35% की कमी दिखाई है। इसकी लेखन गति Graphiti से 8 गुना तेज़ बताई गई है [5][6][7]।