ZAYA1‑8B‑Diffusion‑Preview: जब AI एक‑एक नहीं, 16 टोकन एक साथ लिखता है
Zyphra का ZAYA1‑8B‑Diffusion‑Preview, उसके ZAYA1‑8B MoE मॉडल का diffusion संस्करण है जो एक बार में 16 टोकन बनाकर 4.6× से 7.7× तक decoding speedup का दावा करता है। यह तरीका पारंपरिक token‑by‑token autoregressive जनरेशन के बजाय parallel block generation का उपयोग करता है, जिससे GPU का उपयोग अधिक कुशल हो सकता है। अगर यह...
प्रकाशितकर्ताGPT-5.5 से संपादितGPT Image 2 से चित्र बनाए गए
Zyphra का ZAYA1‑8B‑Diffusion‑Preview, उसके ZAYA1‑8B MoE मॉडल का diffusion संस्करण है जो एक बार में 16 टोकन बनाकर 4.6× से 7.7× तक decoding speedup का दावा करता है।
यह तरीका पारंपरिक token‑by‑token autoregressive जनरेशन के बजाय parallel block generation का उपयोग करता है, जिससे GPU का उपयोग अधिक कुशल हो सकता है।
अगर यह तकनीक बड़े पैमाने पर काम करती है, तो AI inference की लागत कम हो सकती है और reinforcement learning ट्रेनिंग में रोलआउट तेज़ हो सकते हैं।
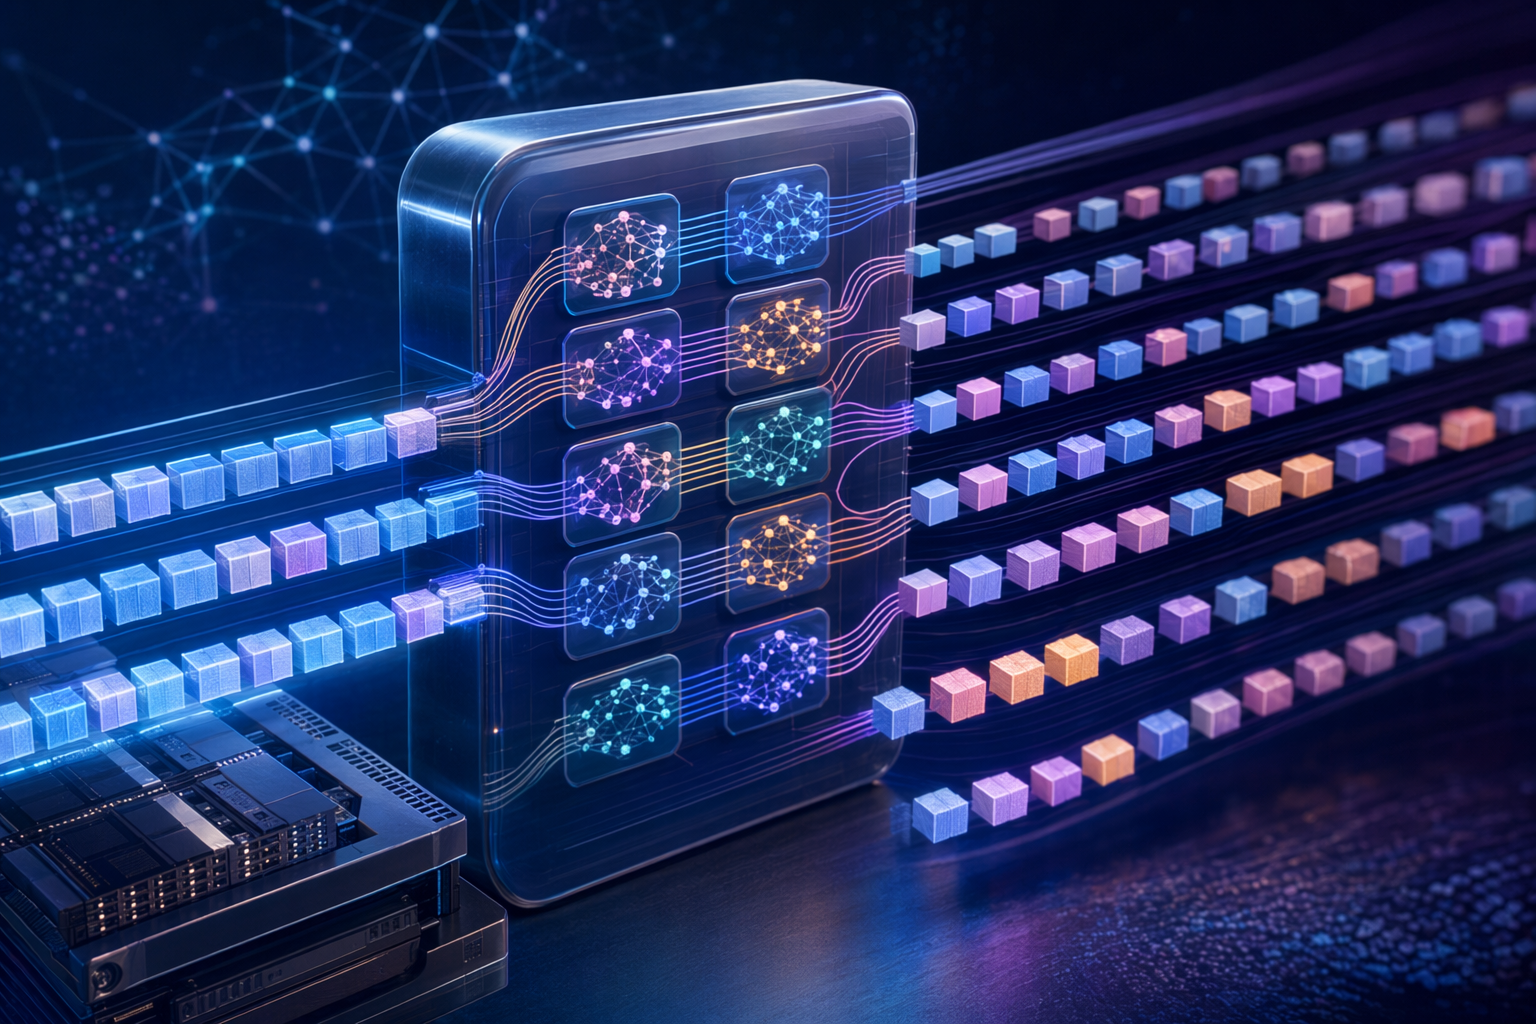
What is Zyphra’s new ZAYA1-8B-Diffusion-Preview model, how does converting its autoregressive ZAYA1-8B into a Mixture-of-Experts diffusion lDiffusion-style language models can draft multiple tokens simultaneously instead of generating them sequentially.
AI संकेत
Create a landscape editorial hero image for this Studio Global article: What is Zyphra’s new ZAYA1-8B-Diffusion-Preview model, how does converting its autoregressive ZAYA1-8B into a Mixture-of-Experts diffusion l. Article summary: Zyphra’s ZAYA1-8B-Diffusion-Preview is an experimental diffusion-language version of its ZAYA1-8B MoE model, designed to decode blocks of text in parallel rather than strictly one token at a time. Zyphra claims it can ge. Topic tags: general, academic, general web, user generated. Reference image context from search candidates: Reference image 1: visual subject "# Zyphra Releases ZAYA1-8B: A Reasoning MoE Trained on AMD Hardware That Punches Far Above Its Weight Class. Zyphra AI has released ZAYA1-8B, a small Mixture of Experts (MoE) langu" source context "Zyphra Releases ZAYA1-8B: A Reasoning MoE Trained on AMD Hardware That Punches Far Above Its Weight Class
openai.com
तेज़ भाषा मॉडल के लिए diffusion आधारित तरीका
AI स्टार्टअप Zyphra ने ZAYA1‑8B‑Diffusion‑Preview नाम का एक प्रयोगात्मक भाषा मॉडल पेश किया है। इसकी खासियत यह है कि यह पारंपरिक autoregressive decoding को छोड़कर diffusion‑style generation का उपयोग करता है।
जहाँ अधिकांश भाषा मॉडल एक समय में सिर्फ एक टोकन (शब्द या शब्द का हिस्सा) बनाते हैं, वहीं यह मॉडल एक साथ 16 टोकन के ब्लॉक का मसौदा तैयार कर सकता है। इसी वजह से कंपनी के अनुसार decoding प्रक्रिया में लगभग 4.6× से 7.7× तक गति बढ़ सकती है, हालांकि वास्तविक प्रदर्शन उपयोग के तरीके पर निर्भर करेगा।
दिलचस्प बात यह है कि यह मॉडल शून्य से diffusion मॉडल के रूप में प्रशिक्षित नहीं किया गया। इसके बजाय, Zyphra ने अपने मौजूदा autoregressive मॉडल को ही diffusion शैली में कन्वर्ट किया। इससे यह संकेत मिलता है कि भविष्य में अन्य LLM भी इसी तरह बदले जा सकते हैं।
Studio Global AI
अपना शोध जारी रखें
इस पृष्ठ में एक स्रोत-समर्थित उत्तर शामिल है जिसे आप Studio Global के अंदर जारी रख सकते हैं।
"ZAYA1‑8B‑Diffusion‑Preview: जब AI एक‑एक नहीं, 16 टोकन एक साथ लिखता है" का संक्षिप्त उत्तर क्या है?
Zyphra का ZAYA1‑8B‑Diffusion‑Preview, उसके ZAYA1‑8B MoE मॉडल का diffusion संस्करण है जो एक बार में 16 टोकन बनाकर 4.6× से 7.7× तक decoding speedup का दावा करता है।
सबसे पहले सत्यापित करने योग्य मुख्य बिंदु क्या हैं?
Zyphra का ZAYA1‑8B‑Diffusion‑Preview, उसके ZAYA1‑8B MoE मॉडल का diffusion संस्करण है जो एक बार में 16 टोकन बनाकर 4.6× से 7.7× तक decoding speedup का दावा करता है। यह तरीका पारंपरिक token‑by‑token autoregressive जनरेशन के बजाय parallel block generation का उपयोग करता है, जिससे GPU का उपयोग अधिक कुशल हो सकता है।
मुझे अभ्यास में आगे क्या करना चाहिए?
अगर यह तकनीक बड़े पैमाने पर काम करती है, तो AI inference की लागत कम हो सकती है और reinforcement learning ट्रेनिंग में रोलआउट तेज़ हो सकते हैं।
Diffusion‑Preview वास्तव में Zyphra के ZAYA1‑8B मॉडल पर आधारित है। यह एक mixture‑of‑experts (MoE) आर्किटेक्चर वाला reasoning मॉडल है।
इसमें कुल 8 अरब से अधिक पैरामीटर हैं, लेकिन inference के दौरान लगभग 760 मिलियन पैरामीटर ही सक्रिय होते हैं।
MoE मॉडल में कई छोटे‑छोटे "एक्सपर्ट" नेटवर्क होते हैं। हर टोकन के लिए उनमें से कुछ ही सक्रिय होते हैं। इससे मॉडल का प्रदर्शन बनाए रखते हुए कम्प्यूट लागत कम की जा सकती है।
Autoregressive मॉडल धीमे क्यों होते हैं
आज के अधिकांश बड़े भाषा मॉडल autoregressive generation का उपयोग करते हैं। इसका मतलब है कि हर नया टोकन पिछले पूरे टेक्स्ट पर निर्भर होता है।
प्रक्रिया आम तौर पर इस तरह चलती है:
अगला टोकन बनाओ
उसे KV cache में जोड़ो
फिर अगले टोकन के लिए वही प्रक्रिया दोहराओ
क्योंकि हर कदम पिछले टोकन पर निर्भर होता है, इसलिए यह प्रक्रिया सीक्वेंशियल होती है और आसानी से parallel नहीं हो पाती। बार‑बार KV cache एक्सेस करने से अक्सर memory bandwidth bottleneck बन जाता है।
diffusion मॉडल 16 टोकन एक साथ कैसे बनाता है
Zyphra का diffusion तरीका इस प्रक्रिया को बदल देता है।
एक‑एक टोकन बनाने की बजाय, मॉडल एक साथ कई संभावित टोकनों का ब्लॉक तैयार करता है। इस प्रीव्यू मॉडल में हर diffusion स्टेप में 16 टोकन प्रस्तावित किए जाते हैं।
साधारण रूप में प्रक्रिया कुछ ऐसी होती है:
मॉडल 16 टोकनों के कई संभावित ड्राफ्ट बनाता है।
एक sampler तय करता है कि कौन‑से टोकन स्वीकार किए जा सकते हैं।
स्वीकार किए गए टोकन आउटपुट में जुड़ जाते हैं, फिर अगला ब्लॉक शुरू होता है।
क्योंकि इन टोकनों का prefix और KV cache एक ही होता है, इसलिए GPU एक ही forward pass में कई टोकनों की गणना कर सकता है। इससे काम sequential memory access से हटकर parallel compute पर शिफ्ट हो जाता है, जो आधुनिक GPU के लिए ज्यादा अनुकूल है।
दो तरह के sampler और उनकी गति
Zyphra ने दो अलग decoding रणनीतियों का उल्लेख किया है:
Lossless sampler
speculative decoding जैसे नियमों का उपयोग करता है
लगभग 4.6× तेज़ decoding का दावा
मूल्यांकन प्रदर्शन में कोई व्यवस्थित गिरावट नहीं दिखाने के लिए डिज़ाइन किया गया
Logit‑mixing sampler
diffusion और autoregressive दोनों के logits को मिलाता है
अधिक टोकन स्वीकार किए जा सकते हैं
अधिकतम 7.7× speedup, लेकिन गुणवत्ता में कुछ गिरावट संभव
इन परिणामों का अधिकांश हिस्सा Zyphra की अपनी रिपोर्ट पर आधारित है, इसलिए स्वतंत्र बेंचमार्क भविष्य में अधिक स्पष्ट तस्वीर देंगे।
AMD GPU पर प्रशिक्षण क्यों खास है
AI उद्योग में अधिकांश बड़े मॉडल Nvidia GPU पर प्रशिक्षित किए जाते हैं। लेकिन Zyphra का कहना है कि यह पहला diffusion भाषा मॉडल है जिसे AMD GPU पर प्रशिक्षित किया गया।
कंपनी ने अपने बेस मॉडल और उसके diffusion संस्करण दोनों को AMD AI स्टैक पर ट्रेन किया। अगर यह तरीका व्यापक रूप से दोहराया जा सके, तो AI हार्डवेयर के क्षेत्र में Nvidia के अलावा भी प्रतिस्पर्धा बढ़ सकती है।
Compressed Convolutional Attention (CCA)
ZAYA1‑8B में Zyphra की एक तकनीक भी शामिल है जिसे Compressed Convolutional Attention (CCA) कहा जाता है। इसका उद्देश्य attention computation की लागत को कम करना है।
Diffusion decoding में एक साथ कई टोकन प्रोसेस करना अक्सर prefill‑जैसे बड़े parallel ऑपरेशन जैसा हो जाता है। ऐसे में attention की लागत कम होना महत्वपूर्ण है, क्योंकि इससे multi‑token generation अधिक व्यावहारिक बन सकता है।
inference लागत पर संभावित असर
अगर Zyphra के बताए गए speedup वास्तविक उत्पादन सिस्टम में भी मिलते हैं, तो इसके कई असर हो सकते हैं:
एक GPU से प्रति सेकंड अधिक टोकन आउटपुट
प्रति टोकन लागत कम
लंबे जवाबों में कम latency
हालाँकि कंपनी खुद भी मानती है कि diffusion‑style inference अभी उतना optimized नहीं है जितना पारंपरिक autoregressive स्टैक, इसलिए वास्तविक लाभ अलग हो सकते हैं।
reinforcement learning ट्रेनिंग के लिए महत्व
कई आधुनिक reasoning मॉडल reinforcement learning (RL) के साथ प्रशिक्षित किए जाते हैं। इसमें मॉडल को प्रशिक्षण के दौरान बहुत बड़ी संख्या में संभावित जवाब जनरेट करने पड़ते हैं, जिन्हें "rollouts" कहा जाता है।
अगर जनरेशन तेज़ हो जाए तो:
RL ट्रेनिंग सस्ती हो सकती है
अधिक sampling प्रयोग किए जा सकते हैं
एक ही प्रॉम्प्ट के लिए कई reasoning paths जांचे जा सकते हैं
यानी inference की गति सीधे‑सीधे RL प्रशिक्षण की लागत और गति को प्रभावित करती है।
कुशल AI मॉडल की दिशा में नया प्रयोग
ZAYA1‑8B‑Diffusion‑Preview AI विकास के एक बड़े रुझान की ओर इशारा करता है। अब ध्यान केवल बड़े मॉडल बनाने पर नहीं, बल्कि "प्रति डॉलर अधिक बुद्धिमत्ता" हासिल करने पर भी है।
इस प्रयोग में कई दक्षता रणनीतियाँ एक साथ दिखती हैं:
mixture‑of‑experts आर्किटेक्चर
diffusion‑style decoding
वैकल्पिक attention मैकेनिज्म
Nvidia के बाहर का हार्डवेयर स्टैक
अगर ये तकनीकें बड़े पैमाने पर सफल साबित होती हैं, तो भविष्य के भाषा मॉडल केवल अधिक शक्तिशाली ही नहीं बल्कि अधिक तेज़, सस्ते और हार्डवेयर‑कुशल भी हो सकते हैं। फिलहाल ZAYA1‑8B‑Diffusion‑Preview को इस दिशा में एक शुरुआती लेकिन महत्वपूर्ण प्रयोग माना जा रहा है।