AI मॉडल कोलैप्स: सिंथेटिक डेटा पर बार‑बार ट्रेनिंग क्यों बन सकती है खतरा
रिसर्च के अनुसार जब AI मॉडल बार‑बार सिंथेटिक (AI‑जनरेटेड) डेटा पर ट्रेन होते हैं तो “मॉडल कोलैप्स” हो सकता है, जिसमें डेटा के दुर्लभ पैटर्न धीरे‑धीरे गायब हो जाते हैं। रिकर्सिव ट्रेनिंग में हर पीढ़ी का मॉडल पहले वाले मॉडल की गलतियों और पक्षपात को और बढ़ा देता है, जिससे डेटा डिस्ट्रीब्यूशन के ‘टेल’ यानी दुर्लभ उदाहरण...
प्रकाशितकर्ताGPT-5.5 से संपादितGPT Image 2 से चित्र बनाए गए
रिसर्च के अनुसार जब AI मॉडल बार‑बार सिंथेटिक (AI‑जनरेटेड) डेटा पर ट्रेन होते हैं तो “मॉडल कोलैप्स” हो सकता है, जिसमें डेटा के दुर्लभ पैटर्न धीरे‑धीरे गायब हो जाते हैं।
रिकर्सिव ट्रेनिंग में हर पीढ़ी का मॉडल पहले वाले मॉडल की गलतियों और पक्षपात को और बढ़ा देता है, जिससे डेटा डिस्ट्रीब्यूशन के ‘टेल’ यानी दुर्लभ उदाहरण मिटने लगते हैं।
अध्ययनों से संकेत मिलता है कि थोड़ा सा वास्तविक डेटा या मजबूत प्रायर नॉलेज भी ट्रेनिंग को स्थिर रख सकता है और मॉडल को वास्तविकता से भटकने से बचा सकता है।
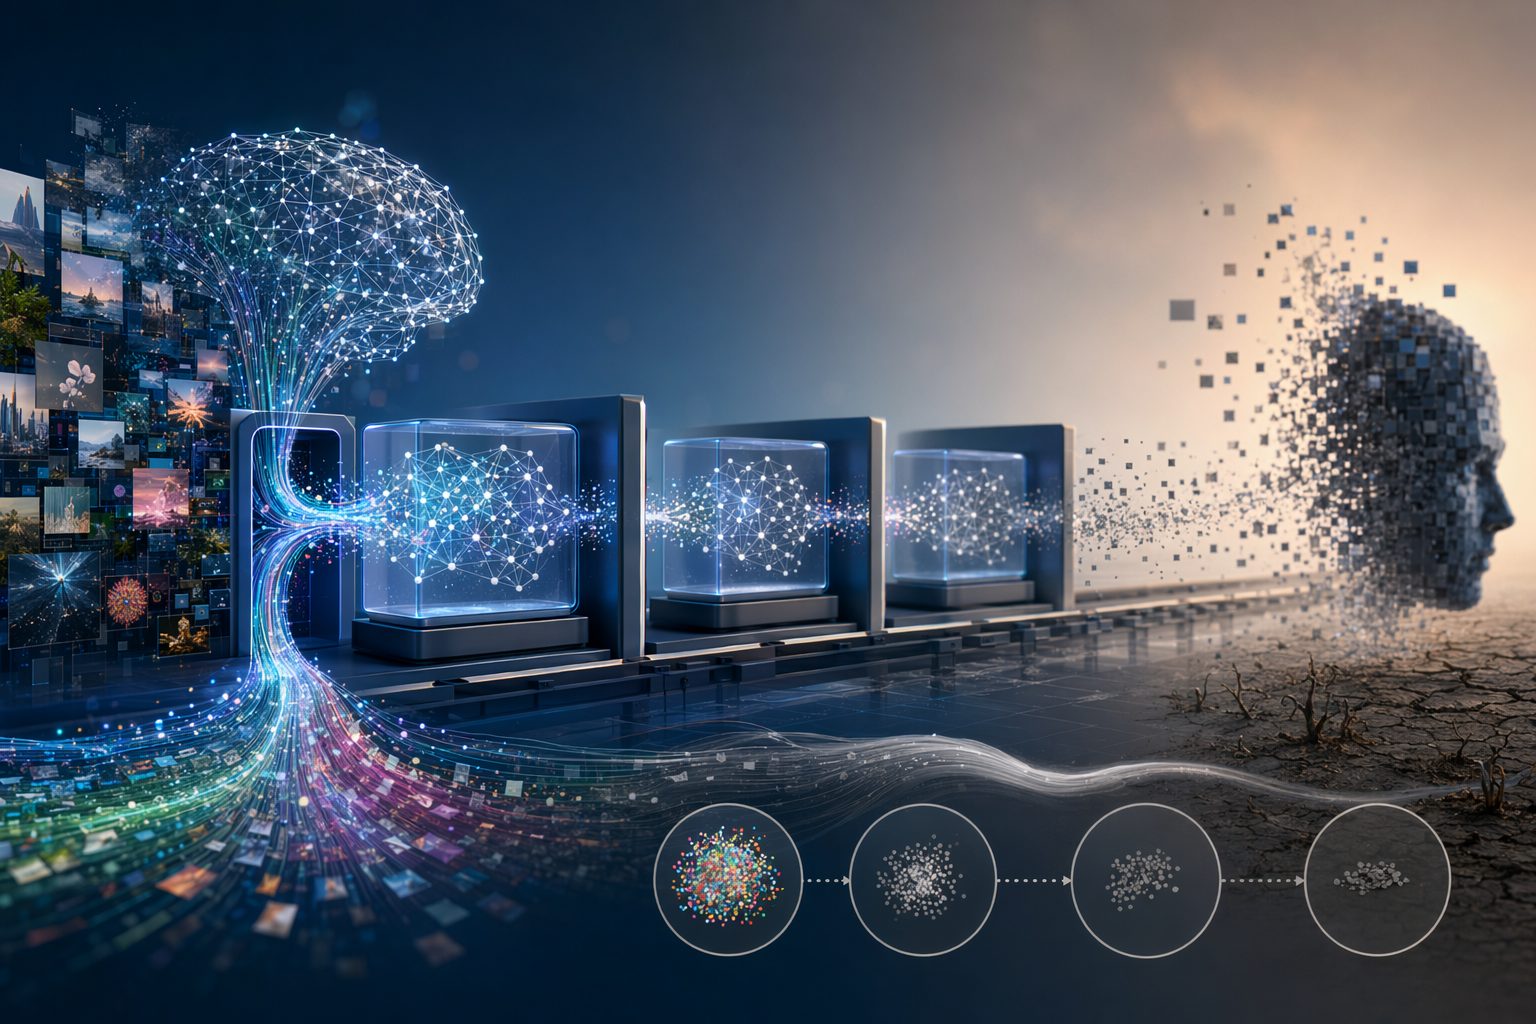
What does the new study on AI model collapse find about preventing degradation when models are trained on synthetic data, why does recursiveRecursive training on AI‑generated data can gradually erase rare patterns from a model’s learned distribution, a phenomenon researchers call model collapse.
AI संकेत
Create a landscape editorial hero image for this Studio Global article: What does the new study on AI model collapse find about preventing degradation when models are trained on synthetic data, why does recursive. Article summary: The study describes model collapse as a failure mode where recursively trained generative models lose information about the original data distribution, especially its rare or low-probability regions.. Topic tags: general, government, education, academic, general web. Reference image context from search candidates: Reference image 1: visual subject "However, as AI-generated data increasingly populates the internet, an important question arises: What happens when new AI models are trained on datasets containing their previous o" source context "Avoiding Model Collapse in AI Training - Risk Insight" Reference image 2: visual subject "Artificial intelligence models
openai.com
जनरेटिव AI सिस्टम—जैसे बड़े भाषा मॉडल—अब अक्सर सिंथेटिक डेटा से भी ट्रेन किए जाते हैं, यानी ऐसा कंटेंट जो किसी पहले AI मॉडल ने बनाया हो। लेकिन शोधकर्ताओं ने चेतावनी दी है कि अगर यह प्रक्रिया लगातार चलती रहे तो एक समस्या पैदा हो सकती है जिसे “मॉडल कोलैप्स” कहा जाता है। इसमें मॉडल धीरे‑धीरे वास्तविक डेटा की विविधता को सही तरह से दर्शाने की क्षमता खो देता है।
एक प्रमुख अध्ययन में पाया गया कि जब मॉडल असली दुनिया के डेटा के बजाय बार‑बार AI‑जनरेटेड आउटपुट से सीखते हैं, तो वे मूल डेटा वितरण के दुर्लभ पैटर्न को भूलने लगते हैं। कई ट्रेनिंग चक्रों के बाद यह समस्या बढ़ती जाती है और अंततः मॉडल की “हकीकत की तस्वीर” ही विकृत हो सकती है।
Studio Global AI
अपना शोध जारी रखें
इस पृष्ठ में एक स्रोत-समर्थित उत्तर शामिल है जिसे आप Studio Global के अंदर जारी रख सकते हैं।
"AI मॉडल कोलैप्स: सिंथेटिक डेटा पर बार‑बार ट्रेनिंग क्यों बन सकती है खतरा" का संक्षिप्त उत्तर क्या है?
रिसर्च के अनुसार जब AI मॉडल बार‑बार सिंथेटिक (AI‑जनरेटेड) डेटा पर ट्रेन होते हैं तो “मॉडल कोलैप्स” हो सकता है, जिसमें डेटा के दुर्लभ पैटर्न धीरे‑धीरे गायब हो जाते हैं।
सबसे पहले सत्यापित करने योग्य मुख्य बिंदु क्या हैं?
रिसर्च के अनुसार जब AI मॉडल बार‑बार सिंथेटिक (AI‑जनरेटेड) डेटा पर ट्रेन होते हैं तो “मॉडल कोलैप्स” हो सकता है, जिसमें डेटा के दुर्लभ पैटर्न धीरे‑धीरे गायब हो जाते हैं। रिकर्सिव ट्रेनिंग में हर पीढ़ी का मॉडल पहले वाले मॉडल की गलतियों और पक्षपात को और बढ़ा देता है, जिससे डेटा डिस्ट्रीब्यूशन के ‘टेल’ यानी दुर्लभ उदाहरण मिटने लगते हैं।
मुझे अभ्यास में आगे क्या करना चाहिए?
अध्ययनों से संकेत मिलता है कि थोड़ा सा वास्तविक डेटा या मजबूत प्रायर नॉलेज भी ट्रेनिंग को स्थिर रख सकता है और मॉडल को वास्तविकता से भटकने से बचा सकता है।
आज यह सवाल इसलिए भी अहम हो गया है क्योंकि इंटरनेट पर AI‑जनरेटेड सामग्री तेजी से बढ़ रही है—और वही भविष्य के AI मॉडलों के ट्रेनिंग डेटा का हिस्सा भी बन सकती है।
“मॉडल कोलैप्स” का मतलब क्या है
मॉडल कोलैप्स एक ऐसी स्थिति है जिसमें जनरेटिव मॉडल तब खराब होने लगते हैं जब उन्हें मूल मानव‑निर्मित डेटा की जगह पिछले मॉडलों द्वारा बनाए गए डेटा से ट्रेन किया जाता है।
शोध में पाया गया कि इस तरह की रिकर्सिव ट्रेनिंग मॉडल में स्थायी खामियां पैदा कर सकती है। खासकर, मॉडल डेटा डिस्ट्रीब्यूशन के "टेल"—यानी दुर्लभ या असामान्य उदाहरण—के बारे में जानकारी खोने लगते हैं।
समय के साथ परिणाम यह होता है कि मॉडल का आउटपुट:
कम विविध हो जाता है
ज़्यादातर आम पैटर्न को ही दोहराता है
दुर्लभ या अनोखे मामलों को ठीक से संभाल नहीं पाता
यह प्रभाव कई प्रकार के जनरेटिव मॉडलों में देखा गया है, जैसे:
Large Language Models (LLMs)
Variational Autoencoders (VAEs)
Gaussian Mixture Models (GMMs)
कई अलग‑अलग मॉडल परिवारों में इसका दिखना यह संकेत देता है कि यह किसी एक आर्किटेक्चर की समस्या नहीं, बल्कि सिंथेटिक डेटा पर रिकर्सिव लर्निंग की सामान्य सीमा हो सकती है।
रिकर्सिव ट्रेनिंग में दुर्लभ पैटर्न क्यों गायब हो जाते हैं
इस समस्या के पीछे एक सरल सांख्यिकीय कारण है।
जब कोई मॉडल डेटा जनरेट करता है, तो वह अक्सर उच्च‑संभावना वाले पैटर्न ज्यादा बनाता है और दुर्लभ घटनाओं को कम। ये दुर्लभ घटनाएं डेटा वितरण के "टेल" में होती हैं और सैंपलिंग में पहले से ही कम दिखती हैं।
अब अगर अगली पीढ़ी का मॉडल उसी सिंथेटिक डेटा से ट्रेन होता है:
दुर्लभ उदाहरण पहले से भी कम दिखाई देते हैं
मॉडल थोड़ा विकृत वितरण सीखता है
अगली पीढ़ी उस विकृति को और बढ़ा देती है
हर नई ट्रेनिंग पीढ़ी पिछले मॉडल के पक्षपात को बढ़ाती जाती है। आखिरकार डेटा वितरण के टेल लगभग गायब हो सकते हैं।
एक बार जब ये दुर्लभ उदाहरण ट्रेनिंग कॉर्पस से हट जाते हैं, तो बाद के मॉडल उन्हें फिर से “खोज” नहीं सकते—क्योंकि उनके अस्तित्व का सबूत ही गायब हो चुका होता है।
असली डेटा या प्रायर नॉलेज कैसे बचा सकते हैं मॉडल को
हालिया विश्लेषण का एक दिलचस्प निष्कर्ष यह है कि इस समस्या को रोकने के लिए बहुत ज्यादा वास्तविक डेटा जरूरी नहीं हो सकता।
Exponential families नामक सांख्यिकीय मॉडलों पर आधारित शोध में पाया गया कि यदि ट्रेनिंग प्रक्रिया में वास्तविक वितरण से आया सिर्फ एक भी डेटा पॉइंट शामिल हो, तो वह पूरे सिस्टम को “एंकर” कर सकता है। यह संकेत देता है कि दुर्लभ पैटर्न मौजूद हैं, जिससे मॉडल गलत वितरण पर स्थिर नहीं होता।
इसी तरह, prior knowledge—यानी मॉडल में पहले से डाली गई संरचनात्मक धारणाएं या सीमाएं—भी मदद कर सकती हैं। ये मॉडल को पूरी तरह सिंथेटिक डेटा के पक्षपात की ओर बहकने से रोकती हैं।
व्यवहारिक रूप से इसका मतलब है:
वास्तविक डेटा दुर्लभ लेकिन सही पैटर्न को संरक्षित रखता है
प्रायर नॉलेज मॉडल को अनियंत्रित रूप से भटकने से रोकती है
भले ही सिंथेटिक डेटा की मात्रा बहुत ज्यादा हो, ये “एंकर” ट्रेनिंग को स्थिर बना सकते हैं।
बड़े भाषा मॉडलों के लिए यह क्यों महत्वपूर्ण है
यह समस्या खास तौर पर Large Language Models (LLMs) के लिए महत्वपूर्ण हो गई है।
इन मॉडलों को ट्रेन करने के लिए आम तौर पर इंटरनेट से विशाल डेटा इकट्ठा किया जाता है। लेकिन जैसे‑जैसे ऑनलाइन कंटेंट में AI‑जनरेटेड टेक्स्ट बढ़ रहा है, भविष्य के ट्रेनिंग डेटासेट में भी सिंथेटिक सामग्री का अनुपात बढ़ सकता है।
अगर भविष्य के मॉडल मुख्यतः इसी AI‑जनरेटेड डेटा पर प्रशिक्षित होते हैं, तो वे धीरे‑धीरे मानव भाषा और ज्ञान की विविधता से दूर हो सकते हैं।
संभावित परिणाम हो सकते हैं:
जनरेटेड आउटपुट में कम विविधता
दुर्लभ या असामान्य मामलों में कमजोर प्रदर्शन
वास्तविक दुनिया की जानकारी का संकुचित प्रतिनिधित्व
इसलिए शोधकर्ता चेतावनी देते हैं कि भविष्य के AI विकास के लिए विश्वसनीय मानव‑जनित डेटा तक पहुंच बनाए रखना या ऐसे तंत्र बनाना जरूरी होगा जो मूल डेटा वितरण को सुरक्षित रखें।
मौजूदा सबूतों की सीमाएं
हालांकि मॉडल कोलैप्स का तंत्र अच्छी तरह समर्थित है, कुछ विवरण अभी भी शोध के अधीन हैं। उदाहरण के लिए, “सिर्फ एक वास्तविक डेटा पॉइंट” से कोलैप्स रुकने का दावा मुख्यतः सैद्धांतिक विश्लेषण और सरल सांख्यिकीय मॉडलों पर आधारित है, न कि बड़े पैमाने के वास्तविक LLM ट्रेनिंग प्रयोगों पर।
इसका मतलब है कि वास्तविक प्रणालियों में आवश्यक असली डेटा की मात्रा मॉडल आर्किटेक्चर, डेटासेट और ट्रेनिंग प्रक्रिया पर निर्भर कर सकती है।
फिर भी मूल संदेश स्पष्ट है: अगर AI केवल AI से सीखता रहा, तो समय के साथ वास्तविकता के कुछ हिस्से गायब हो सकते हैं। इसलिए लंबे समय तक सटीक और विश्वसनीय AI बनाए रखने के लिए वास्तविक दुनिया के डेटा से जुड़ाव बनाए रखना जरूरी है।
arxiv.org
Lost in Retraining: Roaming the Parameter Space of ...