नियमों से एआई एजेंट तक: आर्टिफिशियल इंटेलिजेंस का विकास कैसे हुआ
1955 में ‘आर्टिफिशियल इंटेलिजेंस’ शब्द गढ़े जाने के बाद एआई का विकास मोटे तौर पर भविष्यवाणी और वर्गीकरण से कंटेंट निर्माण, और फिर टूल्स के जरिए योजना बनाकर कार्रवाई करने तक हुआ। पारंपरिक एआई सीमित और मापे जा सकने वाले कामों, जैसे धोखाधड़ी पहचानने और सिफारिश देने, में प्रभावी है; जनरेटिव एआई टेक्स्ट, तस्वीरें और कोड...
प्रकाशितकर्ताGPT-5.6 Luna से संपादितGPT Image 1.5 से चित्र बनाए गए
1955 में ‘आर्टिफिशियल इंटेलिजेंस’ शब्द गढ़े जाने के बाद एआई का विकास मोटे तौर पर भविष्यवाणी और वर्गीकरण से कंटेंट निर्माण, और फिर टूल्स के जरिए योजना बनाकर कार्रवाई करने तक हुआ।
पारंपरिक एआई सीमित और मापे जा सकने वाले कामों, जैसे धोखाधड़ी पहचानने और सिफारिश देने, में प्रभावी है; जनरेटिव एआई टेक्स्ट, तस्वीरें और कोड बना सकता है, लेकिन गलत जानकारी को आत्मविश्वास से पेश कर सकता है; एजेंटिक एआई ब...
सिंगापुर का 2026 एजेंटिक एआई फ्रेमवर्क सीमित स्वायत्तता, न्यूनतम आवश्यक एक्सेस, निगरानी और संवेदनशील कार्रवाइयों से पहले मानव मंजूरी जैसे उपायों पर जोर देता है।
How has artificial intelligence evolved over the past seven decades from traditional rule-based systems that classify data and predict outcoAI’s evolution can be understood as a progression from prediction to generation and autonomous action.
AI संकेत
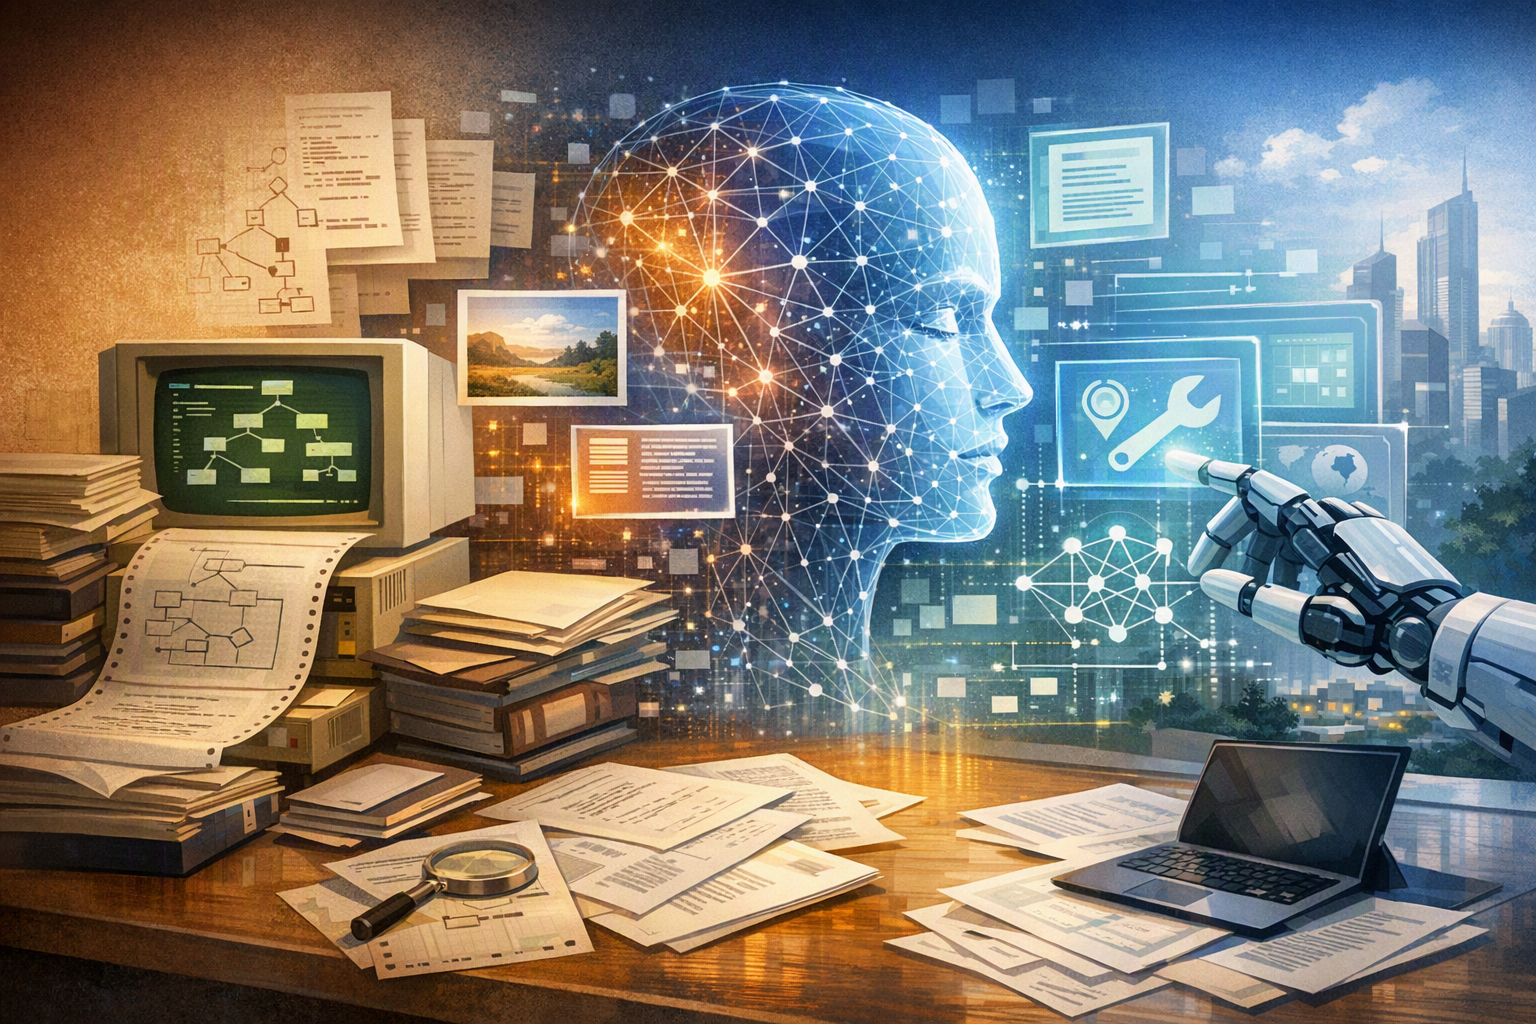
Create a landscape editorial hero image for this Studio Global article: How has artificial intelligence evolved over the past seven decades from traditional rule-based systems that classify data and predict outco. Article summary: Artificial intelligence has shifted from systems that followed human-written rules or learned narrow prediction patterns, to models that generate new content, and now to agents that can plan and act through software tool. Topic tags: general, government, education, academic, documentation. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, waterma
openai.com
आर्टिफिशियल इंटेलिजेंस का विकास किसी पुरानी तकनीक को एक झटके में हटाकर नई तकनीक अपनाने की कहानी नहीं है। इसकी क्षमताएं परत-दर-परत जुड़ती गई हैं। पहले ऐसे सिस्टम थे जो तय नियमों का पालन करते थे या सीमित दायरे में अनुमान लगाते थे। फिर ऐसे मॉडल आए जो टेक्स्ट, तस्वीरें और कोड बना सकते हैं। अब एआई एजेंट लक्ष्य को छोटे चरणों में बांटकर टूल्स का इस्तेमाल करते हुए उपयोगकर्ता की ओर से कार्रवाई भी कर सकते हैं।
इस सफर को समझने का सबसे आसान तरीका है: भविष्यवाणी करो → निर्माण करो → योजना बनाकर कार्रवाई करो। हर चरण में एआई की उपयोगिता बढ़ी है—और गलती होने पर उसके संभावित परिणाम भी अधिक गंभीर हुए हैं।
1. पारंपरिक एआई: नियम, वर्गीकरण और भविष्यवाणी
एआई शोध के शुरुआती दौर में प्रतीकात्मक तर्क (symbolic reasoning) पर काफी जोर था। प्रोग्रामर ज्ञान को नियमों के रूप में दर्ज करते और सिस्टम को संभावित समाधानों में खोज करने के लिए तैयार करते। शतरंज जैसे खेलों के प्रोग्राम इसका अच्छा उदाहरण हैं: वे स्पष्ट नियमों के दायरे में संभावित चालों का मूल्यांकन कर सकते थे। ‘आर्टिफिशियल इंटेलिजेंस’ शब्द 1955 में कंप्यूटर वैज्ञानिक जॉन मैकार्थी ने गढ़ा था। उन्होंने इसे “बुद्धिमान मशीनें बनाने का विज्ञान और इंजीनियरिंग” बताया था।
इसके बाद सांख्यिकीय मशीन लर्निंग ने हाथ से लिखे नियमों पर निर्भरता घटाई और ऐतिहासिक डेटा से पैटर्न सीखने की क्षमता बढ़ाई। ऐसे सिस्टम आमतौर पर इनपुट लेकर सीमित दायरे वाला आउटपुट देते हैं, जैसे:
संदिग्ध लेन-देन को चिह्नित करना;
क्रेडिट जोखिम का अनुमान लगाना;
स्वास्थ्य संबंधी किसी परिणाम की संभावना बताना;
सुझाए जाने वाले उत्पाद या वीडियो की रैंकिंग करना; या
बोले गए वाक्य के पीछे उपयोगकर्ता की मंशा पहचानना।
व्यवहार में ये सिस्टम केवल नियम-आधारित नहीं होते। इनमें नियमों, सांख्यिकीय मॉडलों और मशीन लर्निंग का संयोजन हो सकता है।
पारंपरिक एआई आज भी उपयोगी क्यों है?
Studio Global AI
अपना शोध जारी रखें
इस पृष्ठ में एक स्रोत-समर्थित उत्तर शामिल है जिसे आप Studio Global के अंदर जारी रख सकते हैं।
"नियमों से एआई एजेंट तक: आर्टिफिशियल इंटेलिजेंस का विकास कैसे हुआ" का संक्षिप्त उत्तर क्या है?
1955 में ‘आर्टिफिशियल इंटेलिजेंस’ शब्द गढ़े जाने के बाद एआई का विकास मोटे तौर पर भविष्यवाणी और वर्गीकरण से कंटेंट निर्माण, और फिर टूल्स के जरिए योजना बनाकर कार्रवाई करने तक हुआ।
सबसे पहले सत्यापित करने योग्य मुख्य बिंदु क्या हैं?
1955 में ‘आर्टिफिशियल इंटेलिजेंस’ शब्द गढ़े जाने के बाद एआई का विकास मोटे तौर पर भविष्यवाणी और वर्गीकरण से कंटेंट निर्माण, और फिर टूल्स के जरिए योजना बनाकर कार्रवाई करने तक हुआ। पारंपरिक एआई सीमित और मापे जा सकने वाले कामों, जैसे धोखाधड़ी पहचानने और सिफारिश देने, में प्रभावी है; जनरेटिव एआई टेक्स्ट, तस्वीरें और कोड बना सकता है, लेकिन गलत जानकारी को आत्मविश्वास से पेश कर सकता है; एजेंटिक एआई ब...
मुझे अभ्यास में आगे क्या करना चाहिए?
सिंगापुर का 2026 एजेंटिक एआई फ्रेमवर्क सीमित स्वायत्तता, न्यूनतम आवश्यक एक्सेस, निगरानी और संवेदनशील कार्रवाइयों से पहले मानव मंजूरी जैसे उपायों पर जोर देता है।
जब लक्ष्य स्पष्ट हो, डेटा प्रासंगिक हो और अलग-अलग गलतियों की लागत मापी जा सके, तब भविष्यवाणी करने वाले सिस्टम काफी प्रभावी होते हैं। वे बड़ी मात्रा में जानकारी तेजी से संसाधित कर सकते हैं, एक समान प्रक्रिया लागू कर सकते हैं और ऐसे पैटर्न पहचान सकते हैं जो इंसान की नजर से छूट जाएं।
लेकिन इन्हीं सिस्टमों की ताकत उनकी सीमा भी बन जाती है। इन्हें आमतौर पर किसी परिभाषित काम के लिए बनाया जाता है। उदाहरण के लिए, धोखाधड़ी पहचानने वाला मॉडल लेन-देन को स्कोर कर सकता है, लेकिन किसी नीति दस्तावेज को समझाकर रिपोर्ट लिखना या किसी बिल्कुल नई परिस्थिति में लचीले ढंग से काम करना उसके दायरे से बाहर हो सकता है। इसका प्रदर्शन प्रशिक्षण डेटा की गुणवत्ता और उस लक्ष्य पर भी निर्भर करता है, जिसकी भविष्यवाणी के लिए मॉडल को तैयार किया गया है।
क्रेडिट, भर्ती, बीमा और स्वास्थ्य सेवाओं जैसे क्षेत्रों में इससे महत्वपूर्ण नैतिक सवाल उठते हैं। ऐतिहासिक डेटा सामाजिक पूर्वाग्रहों को दोहरा सकता है और अपारदर्शी स्कोरिंग सिस्टम के फैसलों को चुनौती देना मुश्किल हो सकता है। इसलिए एआई गवर्नेंस में स्पष्ट उद्देश्य, अलग-अलग प्रासंगिक समूहों के लिए सटीकता और निष्पक्षता की जांच, निजता की सुरक्षा, फैसले की व्याख्या और बड़े प्रभाव वाले मामलों में मानव समीक्षा शामिल होनी चाहिए। पक्षपात, गलत सूचना और दुरुपयोग की चिंताएं केवल चैटबॉट्स तक सीमित नहीं हैं; वे व्यापक एआई नीति के मुद्दे हैं।
2. जनरेटिव एआई: लेबल बताने से कंटेंट बनाने तक
जनरेटिव एआई ने उपयोगकर्ता का सवाल “यह किस श्रेणी में आता है?” से बदलकर “इस निर्देश के आधार पर कुछ बनाओ या बदलो” कर दिया है। बड़े एआई मॉडल टेक्स्ट, तस्वीरें, ऑडियो और कोड तैयार कर सकते हैं। इनके इस्तेमाल से ग्राहक सेवा के जवाबों का मसौदा बनाना, अनुवाद करना, पढ़ाई में मदद लेना, कानूनी सामग्री का सारांश तैयार करना, सॉफ्टवेयर विकसित करना और रचनात्मक काम करना आसान हो सकता है।
जनरेटिव सिस्टम पहली ड्राफ्ट तैयार करने में लगने वाला समय और खर्च घटा सकते हैं। वे जटिल जानकारी के लिए बातचीत आधारित इंटरफेस देते हैं और पेशेवरों की क्षमता बढ़ा सकते हैं, बजाय इसके कि केवल किसी तय फैसले को स्वचालित करें।
सबसे बड़ी कमजोरी: विश्वसनीय लगना, सच होने की गारंटी नहीं
जनरेटिव मॉडल आत्मविश्वास से ऐसी बात कह सकते हैं जो गढ़ी हुई या गलत हो—जैसे कोई स्रोत, कानूनी मिसाल, चिकित्सा दावा या कोड। NIST इस तरह के आउटपुट के लिए confabulation शब्द इस्तेमाल करता है, यानी “आत्मविश्वास के साथ कही गई लेकिन गलत या झूठी सामग्री”; आम बोलचाल में इसे hallucination कहा जाता है।
जहां तथ्यात्मक शुद्धता जरूरी हो, वहां हर महत्वपूर्ण उत्तर की जांच आवश्यक है। भरोसेमंद स्रोतों से जानकारी लेना, उद्धरण और संदर्भ देना, व्यवस्थित मूल्यांकन करना, क्षेत्र-विशेष परीक्षण और योग्य मानव समीक्षा उपयोगी सुरक्षा उपाय हैं। धाराप्रवाह उत्तर को प्रमाण नहीं, बल्कि एक प्रारंभिक मसौदा या अनुमान समझना चाहिए।
जनरेटिव एआई के व्यापक जोखिम
जनरेटिव एआई से डेटा सुरक्षा, बौद्धिक संपदा, गलत सूचना और आउटपुट के स्रोत की पहचान से जुड़े सवाल भी उठते हैं। यूरोपीय आयोग के शोध-उपयोग संबंधी दिशानिर्देश इन जोखिमों को रेखांकित करते हैं और कहते हैं कि एआई की मदद लेने के बावजूद प्रकाशित काम की अंतिम जिम्मेदारी इंसानों की रहती है।
शिक्षा में एक अलग चुनौती सामने आती है। यदि विद्यार्थी नियमित रूप से लेखन, तर्क और समस्या-समाधान का काम एआई को सौंप दें, तो उन्हें चमकदार परिणाम मिल सकता है, लेकिन मूल कौशल का अभ्यास कम हो सकता है। शिक्षा संबंधी दिशानिर्देश गलत, पक्षपाती या हानिकारक सामग्री, डेटा उल्लंघन, बौद्धिक संपदा के उल्लंघन और अकादमिक ईमानदारी से जुड़ी चुनौतियों को ऐसे जोखिमों में गिनाते हैं, जिनका संस्थानों को प्रबंधन करना चाहिए।
संवेदनशील बातचीत में सुरक्षा संबंधी विफलताएं और गंभीर हो सकती हैं। सिस्टम घृणास्पद, हिंसक, यौन या हेरफेर करने वाली सामग्री बना सकते हैं या खुद को नुकसान पहुंचाने की बात कहने वाले व्यक्ति को अनुचित जवाब दे सकते हैं। NIST खतरनाक या हिंसक सुझाव, निजता और हानिकारक पक्षपात को भी ऐसे जोखिमों में शामिल करता है, जिन पर ध्यान देना जरूरी है। उच्च जोखिम वाली परिस्थितियों में एआई को योग्य देखभाल या मानवीय सुरक्षा-व्यवस्था का विकल्प नहीं बनाया जाना चाहिए। ऐसे सिस्टमों में स्पष्ट रूप से मना करने की क्षमता, संकट की स्थिति में मानव सहायता तक पहुंचाने की व्यवस्था और मजबूत निजता नियंत्रण होने चाहिए।
3. एजेंटिक एआई: योजना बनाना, टूल्स इस्तेमाल करना और कार्रवाई करना
एजेंटिक एआई किसी मॉडल के चारों ओर एक ‘एक्शन लूप’ जोड़ता है। एजेंट केवल एक बार जवाब देने के बजाय लक्ष्य को समझ सकता है, उसे चरणों में बांट सकता है, ब्राउज़र, कोड रनर, ईमेल सेवा या एपीआई जैसे टूल्स इस्तेमाल कर सकता है, परिणामों की जांच कर सकता है, अपनी योजना बदल सकता है और काम आगे बढ़ा सकता है।
स्टैनफोर्ड एजेंटिक एआई को ऐसे स्वायत्त या अर्ध-स्वायत्त सिस्टम के रूप में परिभाषित करता है, जो लक्ष्यों को समझ या तय कर सकते हैं, कार्रवाइयों का क्रम बना सकते हैं, टूल्स का इस्तेमाल कर सकते हैं, प्रतिक्रिया के आधार पर निर्णय बदल सकते हैं और तय सीमाओं के भीतर काम पूरा करने के लिए अनुकूलित हो सकते हैं।
व्यावहारिक अंतर को इस तरह समझें:
भविष्यवाणी करने वाला सिस्टम किसी लेन-देन को स्कोर करता है;
जनरेटिव सिस्टम उसके बारे में जवाब का मसौदा तैयार करता है; और
एजेंट, जरूरी अनुमति मिलने पर, लेन-देन की जांच, केस फाइल का अपडेट और संदेश भेजने जैसी कार्रवाई कर सकता है।
सॉफ्टवेयर विकास में Google का Jules इसका उदाहरण है। Google के अनुसार, यह एक asynchronous coding agent है, जो रिपॉजिटरी से जुड़ता है, कोडबेस को क्लाउड वर्चुअल मशीन में कॉपी करता है और बाद में समीक्षा के लिए कोडिंग कार्य करता है। टूल्स का इस्तेमाल करने वाले ओपन-सोर्स एजेंट एक दूसरा मॉडल पेश करते हैं। भर्ती क्षेत्र में LinkedIn का Hiring Assistant दिखाता है कि एजेंटिक वर्कफ्लो सोर्सिंग और हायरिंग तक भी पहुंच सकते हैं।
एजेंट इसलिए आकर्षक हैं क्योंकि वे केवल अगला कदम सुझाने के बजाय कई चरणों वाला काम पूरा कर सकते हैं। कोई कोडिंग एजेंट बग की जांच कर सकता है, कई फाइलों में बदलाव कर सकता है, टेस्ट चला सकता है और समीक्षा के लिए pull request तैयार कर सकता है। इसी तरह कोई वर्कफ्लो एजेंट जानकारी जुटाकर उसे व्यवस्थित कर सकता है और मंजूरी के लिए संचार सामग्री तैयार कर सकता है।
स्वायत्तता बढ़ने पर जोखिम क्यों बढ़ता है?
योजना बनाने की क्षमता का अर्थ यह नहीं है कि सिस्टम दुनिया को विश्वसनीय ढंग से समझता भी है। एजेंट किसी वेबपेज को गलत समझ सकता है, खराब योजना चुन सकता है, दुर्भावनापूर्ण निर्देश का पालन कर सकता है या कई चरणों में एक छोटी गलती को बड़ा बना सकता है। 2026 Stanford AI Index के अनुसार, OSWorld नामक वास्तविक कंप्यूटर कार्यों के बेंचमार्क पर एजेंटों की सफलता दर 12% से बढ़कर लगभग 66% हुई, लेकिन वे अब भी करीब हर तीन में से एक प्रयास में विफल रहे।
चैटबॉट की hallucination अक्सर संचार से जुड़ी समस्या रह सकती है। लेकिन जिस एजेंट के पास लॉगिन क्रेडेंशियल, ब्राउज़र एक्सेस या भुगतान की अनुमति हो, वही गलती वास्तविक बाहरी कार्रवाई में बदल सकती है। इसलिए एजेंटिक एआई गवर्नेंस में केवल आउटपुट की गुणवत्ता नहीं, बल्कि अनुमतियां, कार्रवाई को वापस लेने की क्षमता और जवाबदेही भी शामिल होनी चाहिए।
एआई एजेंटों के प्रमुख सुरक्षा जोखिम
सबसे गंभीर जोखिम वहां पैदा होते हैं जहां एजेंट सिस्टम, पैसे, डेटा या दूसरे लोगों को प्रभावित कर सकता है:
बिना अनुमति भुगतान: एजेंट गलत वस्तु चुन सकता है, बजट से अधिक खर्च कर सकता है या किसी दुर्भावनापूर्ण वेबपेज से प्रभावित हो सकता है।
निजी डेटा का रिसाव और चोरी: ईमेल, फाइलों, ग्राहक रिकॉर्ड, सोर्स कोड या एपीआई कुंजियों तक पहुंच जानकारी के खुलासे का अवसर पैदा करती है, खासकर prompt injection के जरिए।
साइबर सुरक्षा और सॉफ्टवेयर को नुकसान: एजेंट असुरक्षित कोड लिख सकता है, कॉन्फिगरेशन बदल सकता है, संसाधन मिटा सकता है या लॉग और बाहरी टूल्स के जरिए गोपनीय जानकारी उजागर कर सकता है।
जवाबदेही का अभाव: मॉडल प्रदाता, एप्लिकेशन डेवलपर, एजेंट तैनात करने वाला संगठन, टूल प्रदाता और उपयोगकर्ता—इनमें से किसकी जिम्मेदारी है, यह अस्पष्ट हो सकता है।
हेरफेर: लगातार बातचीत करने वाले एजेंट उपयोगकर्ता पर अनुचित प्रभाव डाल सकते हैं, खासकर तब जब व्यक्ति कमजोर स्थिति में हो या सिस्टम अपनी वास्तविक क्षमता से अधिक भरोसेमंद दिखाई दे।
जिम्मेदार एआई गवर्नेंस कैसी होनी चाहिए?
नियंत्रणों का स्तर सिस्टम की क्षमता और गलती के संभावित परिणामों के अनुरूप होना चाहिए।
भविष्यवाणी करने वाले एआई के लिए संगठनों को उद्देश्य स्पष्ट करना चाहिए, सटीकता और निष्पक्षता मापनी चाहिए, व्यक्तिगत डेटा की रक्षा करनी चाहिए और बड़े प्रभाव वाले फैसलों की व्याख्या या उन्हें चुनौती देने के रास्ते देने चाहिए।
जनरेटिव एआई के लिए महत्वपूर्ण दावों की पुष्टि, hallucination और हानिकारक आउटपुट की जांच, संवेदनशील डेटा पर नियंत्रण, सामग्री के स्रोत और बौद्धिक संपदा से जुड़े सवालों का समाधान जरूरी है। कानूनी, चिकित्सा, वित्तीय और सुरक्षा-संबंधी फैसलों की जिम्मेदारी योग्य इंसानों के पास रहनी चाहिए।
एजेंटों के लिए तकनीकी और संगठनात्मक नियंत्रण और आगे जाने चाहिए:
उपयोग का दायरा सीमित करें। तैनाती से पहले तय करें कि एजेंट क्या कर सकता है और क्या नहीं।
एक्सेस सीमित रखें। न्यूनतम आवश्यक अधिकार वाले क्रेडेंशियल, सीमित टूल्स, लेन-देन की सीमा और sandboxed वातावरण इस्तेमाल करें।
महत्वपूर्ण पड़ावों पर मंजूरी लें। वित्तीय, कानूनी, निजता और सुरक्षा से जुड़ी कार्रवाइयां उचित मानव अनुमति के बिना नहीं होनी चाहिए।
हर गतिविधि का रिकॉर्ड रखें। लॉग बनाए रखें, व्यवहार पर निगरानी करें और घटनाओं की जिम्मेदारी स्पष्ट करें।
विपरीत परिस्थितियों में परीक्षण करें। prompt injection, डेटा बाहर भेजने, हानिकारक व्यवहार और विफलता से उबरने की क्षमता की तैनाती से पहले और उसके दौरान जांच करें।
मानव नियंत्रण बनाए रखें। लोग एजेंट की महत्वपूर्ण कार्रवाई को रोक, बदल और चुनौती दे सकें।
सिंगापुर की Infocomm Media Development Authority (IMDA) का Model AI Governance Framework for Agentic AI इसी जोखिम-आधारित दृष्टिकोण को सामने रखता है। यह उन संगठनों के लिए है जो एजेंट खुद विकसित करते हैं या तीसरे पक्ष के समाधान तैनात करते हैं। इसका मुख्य सबक है कि स्वायत्तता धीरे-धीरे बढ़ाई जानी चाहिए: पहले केवल पढ़ने और सहायता देने वाले काम, फिर कम जोखिम वाली कार्रवाइयां, और अपरिवर्तनीय या बड़े प्रभाव वाली कार्रवाइयों के लिए स्पष्ट मानव मंजूरी।
एआई का अगला चरण किस दिशा में है?
एआई के विकास को तीन पूरी तरह अलग युगों की तरह नहीं, बल्कि लगातार बढ़ती क्षमता वाली एक परतदार संरचना की तरह समझना बेहतर है। पारंपरिक सिस्टम भविष्यवाणी और वर्गीकरण करते हैं। जनरेटिव सिस्टम कंटेंट बनाते और बदलते हैं। एजेंटिक सिस्टम इनके ऊपर योजना, टूल्स का इस्तेमाल और कार्रवाई की क्षमता जोड़ते हैं।
गवर्नेंस को भी इसी गति से आगे बढ़ना होगा। सटीकता और निष्पक्षता के नियंत्रण जरूरी बने रहेंगे, लेकिन अब वे पर्याप्त नहीं हैं। जनरेटिव सिस्टम के लिए मजबूत सत्यापन, स्रोत-पारदर्शिता और कंटेंट सुरक्षा चाहिए। एजेंटों के लिए अनुमति की सीमाएं, कार्रवाई से पहले मंजूरी, सुरक्षा निगरानी और स्पष्ट जवाबदेही भी अनिवार्य हैं।
एआई जितना अधिक काम अपने आप कर सकता है, संगठनों को उतनी ही सावधानी से तय करना होगा कि उसे वास्तव में क्या करने की अनुमति दी जाए।
assets.publishing.service.gov.ukThe safe and effective use of AI in education