उत्तरप्रकाशित25 स्रोत
WITA-Omni का 85.21 स्कोर: ऑडियो, वीडियो और समय को साथ समझने का फायदा
AgiBot के अनुसार, WITA Omni Preview ने Daily Omni में 85.21% औसत सटीकता हासिल की और आठ में से छह मापदंडों में पहला या संयुक्त पहला स्थान पाया। [1][18] Daily Omni यह परखता है कि मॉडल आवाज़, दृश्य और घटनाओं के क्रम को समय के साथ जोड़कर सही उत्तर दे सकता है या नहीं। [17][27] Thinker–Talker–Actor ढांचा मल्टीमॉडल समझ, स्...
प्रकाशितकर्ताGPT-5.6 Terra से संपादितGPT Image 2 से चित्र बनाए गए
शोध उत्तर
मुख्य निष्कर्ष
- AgiBot के अनुसार, WITA Omni Preview ने Daily Omni में 85.21% औसत सटीकता हासिल की और आठ में से छह मापदंडों में पहला या संयुक्त पहला स्थान पाया। [1][18]
- Daily Omni यह परखता है कि मॉडल आवाज़, दृश्य और घटनाओं के क्रम को समय के साथ जोड़कर सही उत्तर दे सकता है या नहीं। [17][27]
- Thinker–Talker–Actor ढांचा मल्टीमॉडल समझ, स्ट्रीमिंग आवाज़ और हाव भाव/शारीरिक क्रिया को एक साझा टाइमलाइन पर समन्वित करने के लिए बनाया गया है। [5][12]
AI संकेत
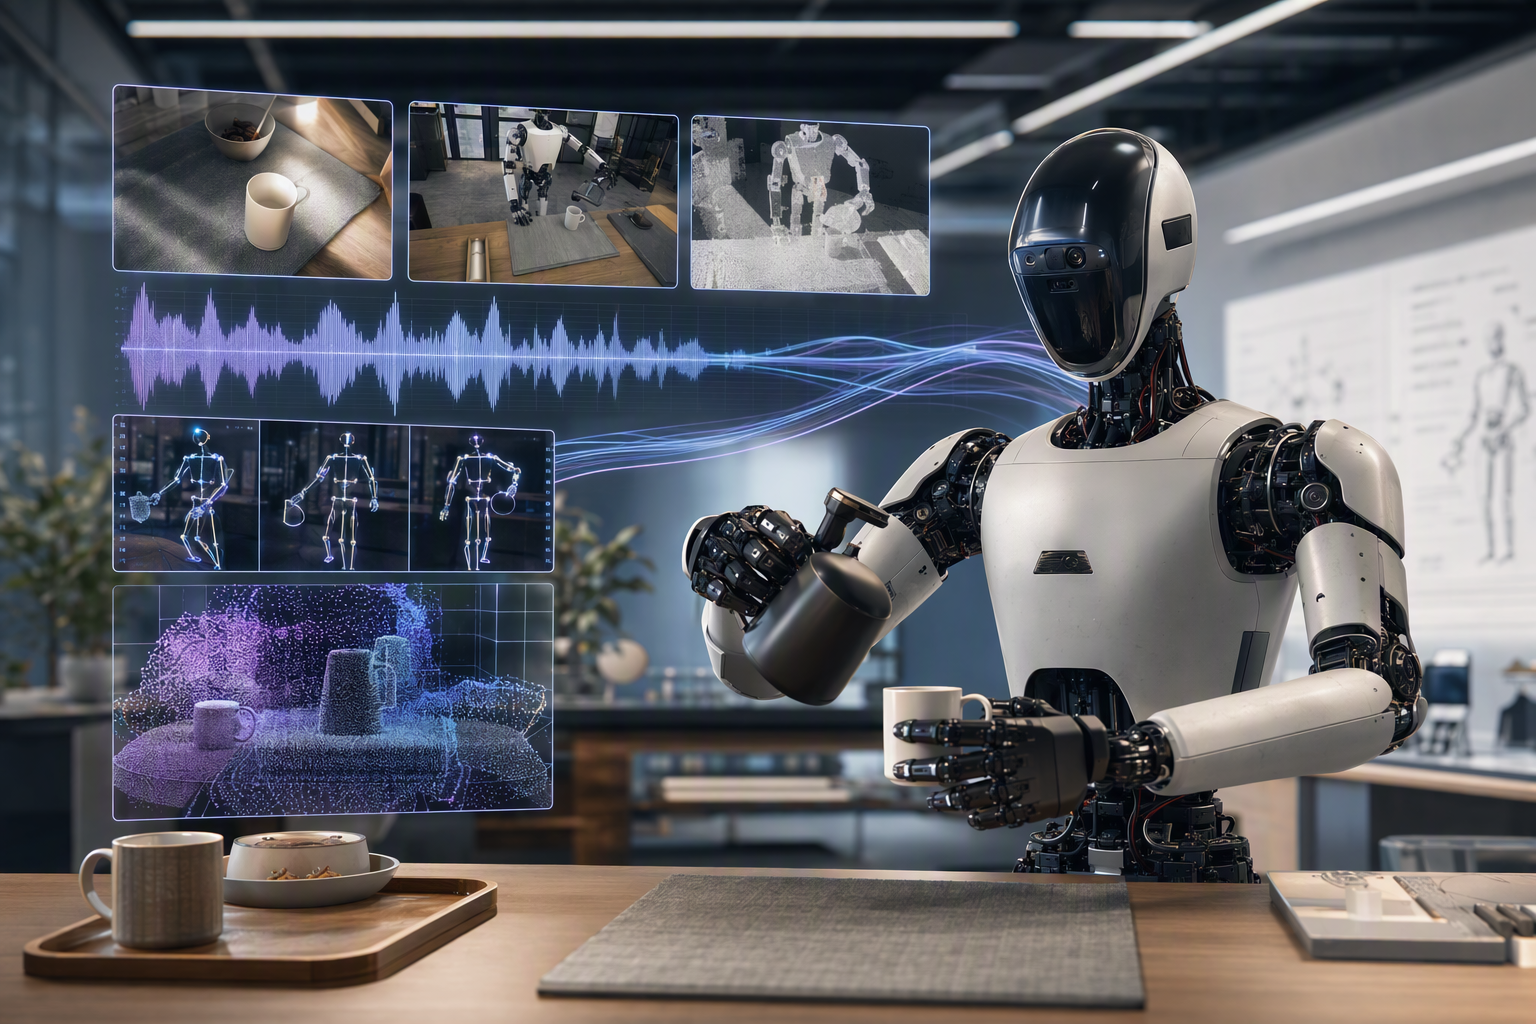
openai.comCreate a landscape editorial hero image for this Studio Global article: How did AgiBot’s WITA-Omni Preview full-modal model achieve a leading 85.21 score and six first-place results out of eight indicators on the. Article summary: AgiBot’s result is best understood as a strong benchmark outcome enabled by native audio-video temporal reasoning, not as independently proven evidence of superior real-world robot intelligence. Daily-Omni is designed to. Topic tags: general, general web, user generated, academic. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, char
AgiBot के WITA-Omni Preview ने Daily-Omni ऑडियो-विजुअल रीजनिंग बेंचमार्क पर कथित तौर पर 85.21% औसत स्कोर हासिल किया। कंपनी और संबंधित रिपोर्टों के मुताबिक, इसने Qwen, Gemini, Doubao और NVIDIA के मूल्यांकित मॉडलों को पीछे छोड़ा तथा आठ में से छह मापदंडों में पहला या संयुक्त पहला स्थान पाया। 1
18
23
इस नतीजे की सबसे तर्कसंगत व्याख्या केवल मॉडल का आकार नहीं, बल्कि यह है कि इसकी घोषित डिजाइन और प्रशिक्षण प्राथमिकताएं Daily-Omni की परीक्षा से सीधे मेल खाती हैं: क्या मॉडल दृश्य, आवाज़ और उनके समय-संबंध को एक साथ समझ सकता है?
यह मल्टीमॉडल एआई के लिए उल्लेखनीय प्रगति है, लेकिन इससे अपने-आप यह साबित नहीं होता कि इस मॉडल से संचालित कोई रोबोट खुले, अनिश्चित सामाजिक या भौतिक माहौल में व्यापक रूप से भरोसेमंद होगा।
Daily-Omni वास्तव में क्या जांचता है?
Daily-Omni समय के हिसाब से जुड़े हुए मल्टीमॉडल तर्क के लिए बनाया गया एक ऑडियो-विजुअल प्रश्न-उत्तर बेंचमार्क है। इसके डेटासेट में रोजमर्रा के जीवन के 684 वीडियो और छह कार्य-प्रकारों में 1,197 बहुविकल्पीय प्रश्न शामिल हैं। 17
27
चुनौती सिर्फ किसी फ्रेम में वस्तु पहचानने या बोली को लिखने की नहीं है। मॉडल को समझना होता है कि कौन-सी दृश्य और ध्वनि घटनाएं साथ हुईं, उनका क्रम क्या था और दोनों माध्यमों के साक्ष्य मिलाकर उत्तर क्या बनता है। सार्वजनिक स्कोर तालिका में ऑडियो-विजुअल अलाइनमेंट, तुलना, संदर्भ-समझ, घटना-क्रम, अनुमान, रीजनिंग तथा 30 और 60 सेकंड के वीडियो उपसमूह शामिल हैं। 20
23
मसलन, सही उत्तर के लिए मॉडल को दो मिलते-जुलते दृश्य कार्यों में फर्क करना पड़ सकता है क्योंकि उनकी आवाज़ अलग है; या यह पहचानना पड़ सकता है कि कोई आवाज़ दिखाई दे रही क्रिया से पहले, उसके दौरान या बाद में आई थी।
WITA-Omni की पद्धति इस बेंचमार्क के अनुकूल क्यों है?
AgiBot, WITA-Omni Preview को टेक्स्ट, चित्र, ऑडियो और वीडियो को संयुक्त रूप से समझने वाला, embodied-native और full-modal मॉडल बताता है। 5
9 यही जोर Daily-Omni की संरचना से मेल खाता है: यहां अच्छे नतीजे के लिए ऑडियो और वीडियो को अलग-अलग इनपुट मानने के बजाय, समय के साथ उनके रिश्ते बनाए रखना अहम है।
17
20
रिपोर्ट किया गया प्रदर्शन खासकर ऑडियो-विजुअल अलाइनमेंट, तुलना, घटना-क्रम तथा 30 और 60 सेकंड के वीडियो वर्गों में मजबूत था। 1
18 ये वही श्रेणियां हैं जहां एक साझा प्रतिनिधित्व—क्या हुआ, क्या सुनाई दिया और यह कब हुआ—मॉडल के काम आ सकता है।
AgiBot और मॉडल पर आई रिपोर्टों के अनुसार, प्रशिक्षण में करोड़ों घंटों के ओपन और स्वामित्व वाले मल्टीमॉडल डेटा का उपयोग हुआ। इसमें भाषण, दृश्य, गति और अभिव्यक्ति के प्राकृतिक समय-संबंध को बचाने वाले डेटा पर भी जोर दिया गया। 5
6
9 फिर भी, सार्वजनिक जानकारी में मॉडल का आकार, पूरा ट्रेनिंग मिश्रण, एब्लेशन अध्ययन, इन्फरेंस सेटिंग्स या स्वतंत्र रूप से दोहराया जा सकने वाला मूल्यांकन विवरण उपलब्ध नहीं है। इसलिए 85.21 के स्कोर को किसी एक तकनीकी फैसले का परिणाम कहना संभव नहीं; यह व्याख्या संभावित है, सिद्ध नहीं।
Thinker–Talker–Actor: embodied interaction के लिए समानांतर ढांचा
AgiBot, WITA-Omni को Thinker–Talker–Actor आर्किटेक्चर के रूप में प्रस्तुत करता है। यह परिचित reasoning-and-speech पैटर्न में शारीरिक और भावात्मक आउटपुट भी जोड़ता है। 5
12
- Thinker: टेक्स्ट, चित्र, ध्वनि और वीडियो के बीच मल्टीमॉडल तर्क करता है और दृश्य व बातचीत की व्याख्या बनाए रखता है।
15
- Talker: पूरे उत्तर के तैयार होने की प्रतीक्षा करने के बजाय भाषा को स्ट्रीमिंग आवाज़ के रूप में उत्पन्न करता है।
8
9
- Actor: इशारों, शारीरिक गतियों और चेहरे के भाव सहित भौतिक व अभिव्यक्तिपूर्ण आउटपुट संभालता है।
5
बताया गया लक्ष्य यह है कि बोलना, हरकत और भाव अलग-अलग चरणों में न निकलें, बल्कि एक ही टाइमलाइन पर समन्वित हों। 12
साझा टाइमलाइन से प्रतिक्रिया अधिक स्वाभाविक क्यों लग सकती है?
पारंपरिक रोबोटिक्स स्टैक अक्सर क्रमिक होता है: पहले perception से दृश्य की व्याख्या, फिर भाषा मॉडल का उत्तर, उसके बाद action planner का निर्णय और अंत में एनिमेशन या नियंत्रण परत का निष्पादन। हर हस्तांतरण प्रतीक्षा बढ़ा सकता है और रोबोट की बोली, इशारे व चाल को एक-दूसरे से कटा हुआ दिखा सकता है।
Thinker–Talker–Actor का समानांतर ढांचा इस रुक-रुक कर चलने वाली प्रक्रिया को घटाने का इरादा रखता है। मॉडल व्यक्ति की बातें, गतिविधि और आसपास के माहौल को समझता रहता है, वहीं वह शुरुआती मौखिक प्रतिक्रिया दे सकता है और उससे मेल खाती शारीरिक अभिव्यक्ति तय कर सकता है। सिद्धांततः इससे बातचीत में बारी लेने का अनुभव स्वाभाविक और रोबोट के शब्दों व गतियों का तालमेल बेहतर हो सकता है।
हालांकि, यह आर्किटेक्चरल तर्क है, स्वतंत्र रूप से मापा गया लाभ नहीं। उपलब्ध स्रोत समन्वित आउटपुट का वर्णन करते हैं, पर एंड-टू-एंड विलंब में कितनी कमी आई, इसका माप नहीं देते। 12
GE-Sim 2.0 और रोबोट हार्डवेयर के साथ संबंध
WITA-Omni, embodied AI के व्यापक प्रस्ताव की एक परत है। AgiBot का GE-Sim 2.0 (Genie Envisioner-Sim 2.0) रोबोटिक मैनिपुलेशन के लिए एक closed-loop वीडियो वर्ल्ड सिम्युलेटर है। बहु-दृश्य इतिहास फ्रेम और action trajectory दिए जाने पर यह निर्दिष्ट रोबोट व्यवहार के अनुरूप भविष्य के बहु-दृश्य परिणाम तैयार करता है। परियोजना के अनुसार, इसे टेलीऑपरेशन, संपर्क-समृद्ध इंटरैक्शन और रोबोट पर नीति-तैनाती वाले बड़े वास्तविक-रोबोट डेटा पर फिर से प्रशिक्षित किया गया है। 11
इस प्रस्तावित तीन-स्तरीय व्यवस्था में भूमिकाएं अलग हैं:
- विश्व सिमुलेशन: GE-Sim 2.0 संभावित क्रिया-परिणामों का मॉडल बना सकता है, जिससे मूल्यांकन और closed-loop नीति कार्य में मदद मिल सकती है।
11
- मल्टीमॉडल इंटरैक्शन: WITA-Omni ऑडियो-विजुअल संदर्भ को समझने, उस पर तर्क करने, बोलने और भावात्मक व्यवहार समन्वित करने का काम कर सकता है।
12
- भौतिक embodiment: रोबोट हार्डवेयर वास्तविक दुनिया को महसूस करने और उसमें कार्य करने के लिए सेंसर व एक्चुएटर्स प्रदान करता है।
AgiBot ने GE-Sim 2.0 के WorldArena बेंचमार्क में शीर्ष पर होने का दावा भी किया है, लेकिन उपलब्ध सामग्री में यह कंपनी का दावा है। इसे Daily-Omni के नतीजे से अलग आधार पर परखा जाना चाहिए। 4
36
85.21 स्कोर क्या साबित करता है—और क्या नहीं?
Daily-Omni का परिणाम इस बात का उपयोगी संकेत है कि WITA-Omni ऑडियो-वीडियो के समय-आधारित तर्क वाले एक परिभाषित कार्य-समूह में अच्छा प्रदर्शन करता है। मानव-रोबोट संवाद में बोली, पर्यावरण की ध्वनियां, दिखाई देने वाली क्रियाएं और उनकी टाइमिंग को जोड़ना जरूरी है, इसलिए ये क्षमताएं embodied AI के लिए प्रासंगिक हैं। 17
27
लेकिन एक बेंचमार्क स्कोर वास्तविक दुनिया में भरोसेमंद तैनाती स्थापित नहीं करता। यह सुरक्षित नियंत्रण, वस्तुओं को पकड़ने-चलाने की मजबूती, गलती से उबरने की क्षमता, लंबे समय की योजना, विभिन्न संस्कृतियों में सामाजिक उपयुक्तता या अपरिचित परिस्थितियों में विश्वसनीयता को अपने-आप नहीं मापता।
सबसे सटीक निष्कर्ष सीमित है: WITA-Omni की रिपोर्ट की गई बढ़त उस मॉडल से संगत है जिसे सिंक्रनाइज़्ड मल्टीमॉडल समझ और अभिव्यक्ति के लिए डिजाइन किया गया है। लेकिन इस लाभ को अनियंत्रित सामाजिक स्थानों में भरोसेमंद रोबोट में बदलने के लिए Daily-Omni से आगे के प्रमाण चाहिए।
Studio Global AI
अपना शोध जारी रखें
इस पृष्ठ में एक स्रोत-समर्थित उत्तर शामिल है जिसे आप Studio Global के अंदर जारी रख सकते हैं।
लोग पूछते भी हैं
"WITA-Omni का 85.21 स्कोर: ऑडियो, वीडियो और समय को साथ समझने का फायदा" का संक्षिप्त उत्तर क्या है?
AgiBot के अनुसार, WITA Omni Preview ने Daily Omni में 85.21% औसत सटीकता हासिल की और आठ में से छह मापदंडों में पहला या संयुक्त पहला स्थान पाया। [1][18]
सबसे पहले सत्यापित करने योग्य मुख्य बिंदु क्या हैं?
AgiBot के अनुसार, WITA Omni Preview ने Daily Omni में 85.21% औसत सटीकता हासिल की और आठ में से छह मापदंडों में पहला या संयुक्त पहला स्थान पाया। [1][18] Daily Omni यह परखता है कि मॉडल आवाज़, दृश्य और घटनाओं के क्रम को समय के साथ जोड़कर सही उत्तर दे सकता है या नहीं। [17][27]
मुझे अभ्यास में आगे क्या करना चाहिए?
Thinker–Talker–Actor ढांचा मल्टीमॉडल समझ, स्ट्रीमिंग आवाज़ और हाव भाव/शारीरिक क्रिया को एक साझा टाइमलाइन पर समन्वित करने के लिए बनाया गया है। [5][12]
सूत्र
roboticsandautomationnews.comAGIBOT's foundation model tops benchmark test for audio- ...
finance.yahoo.comAGIBOT's WITA-Omni Preview Tops Daily-Omni Audio ...
lliar-liar.github.ioDaily-Omni: Towards Audio-Visual Reasoning with Temporal ...
arxiv.orgDaily-Omni: Towards Audio-Visual Reasoning with Temporal ... - arXiv