Claude, GPT, Gemini, DeepSeek, Grok : quels modèles d’IA choisir pour écrire en marketing en 2026 ?
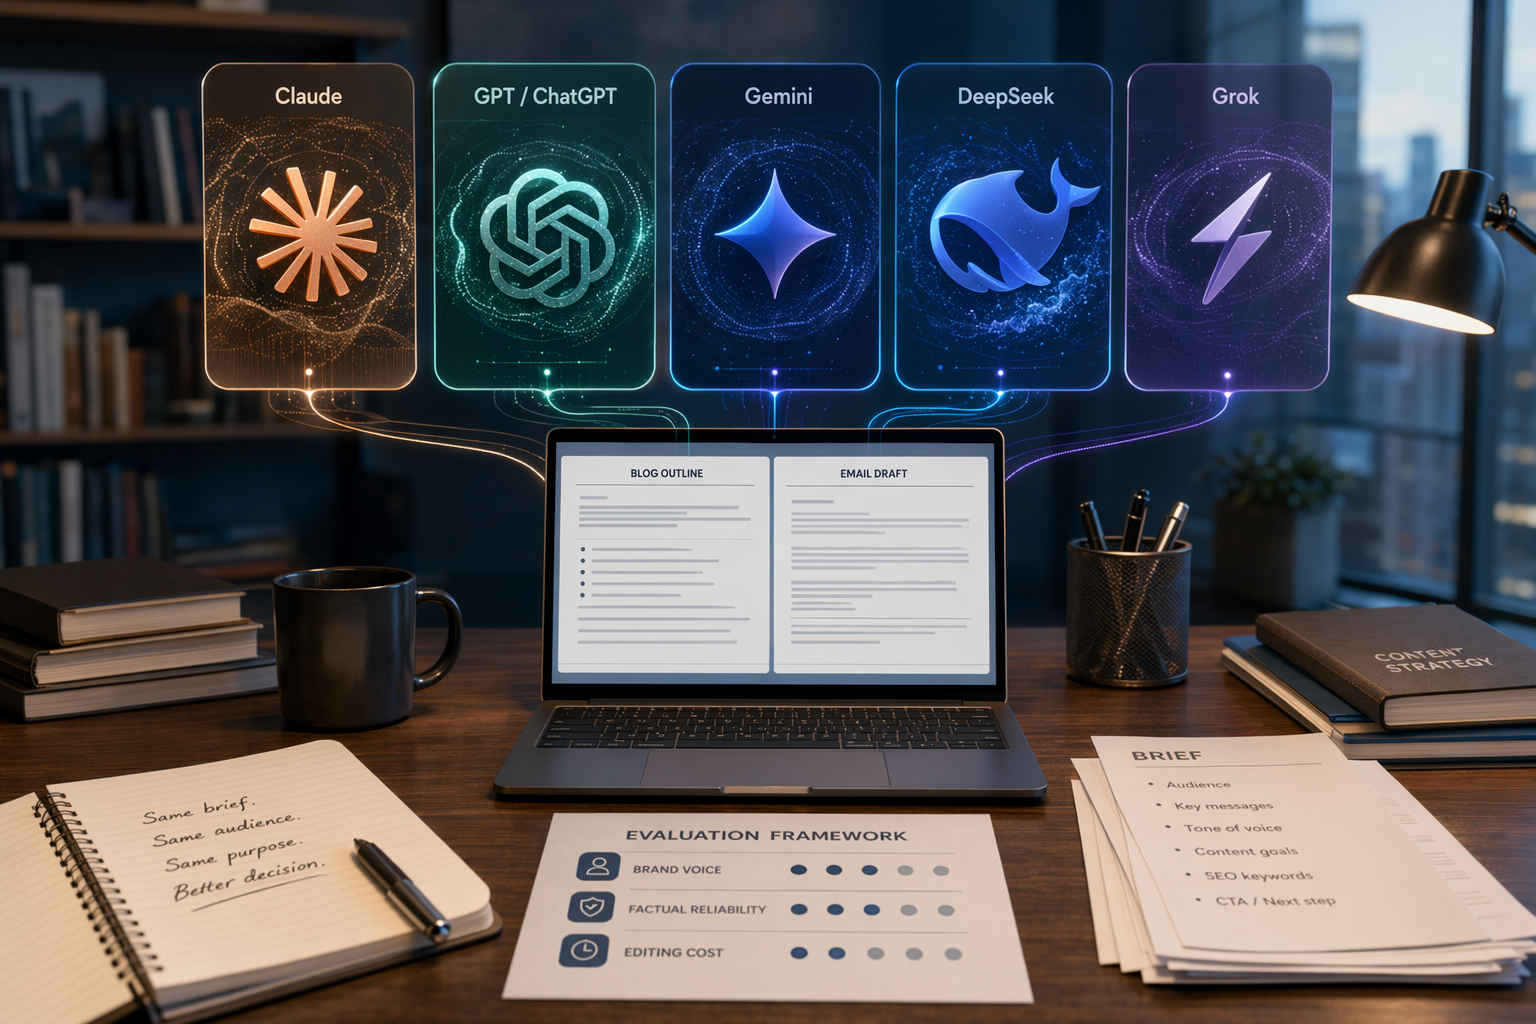
En 2026, aucun classement unique ne suffit à désigner les meilleurs modèles d’IA pour la rédaction marketing : les benchmarks mesurent souvent des critères différents. Pour démarrer vite, testez dans cet ordre Claude, GPT/ChatGPT, Gemini, DeepSeek puis Grok, en gardant en tête que ce n’est pas un podium définitif.
Publié parModifié avec GPT-5.5Images générées avec GPT Image 2
En 2026, aucun classement unique ne suffit à désigner les meilleurs modèles d’IA pour la rédaction marketing : les benchmarks mesurent souvent des critères différents.
Pour démarrer vite, testez dans cet ordre Claude, GPT/ChatGPT, Gemini, DeepSeek puis Grok, en gardant en tête que ce n’est pas un podium définitif.
Le meilleur choix dépendra surtout de votre brief, de votre voix de marque, de vos contraintes de vérification et du temps nécessaire pour transformer un brouillon en contenu publiable.
2026 行銷寫作 AI 模型前五名:部落格與 Email 先測這 5 個行銷寫作模型不該只看通用排行榜;用同一份 brief 實測,才能看出哪個模型最省編修時間。
Prompt IA
Create a landscape editorial hero image for this Studio Global article: 2026 行銷寫作 AI 模型前五名:部落格與 Email 先測這 5 個. Article summary: 2026 年沒有單一官方榜單能決定行銷寫作 AI 前五名;最實用的縮小範圍,是先測 Claude、GPT/ChatGPT、Gemini、DeepSeek、Grok,並用同一份 brief 比較品牌語氣、事實可靠度與編修成本。. Topic tags: ai, content marketing, email marketing, seo, copywriting. Reference image context from search candidates: Reference image 1: visual subject "《時代》雜誌公布2026年十大最具影響力人工智能公司榜單,字節跳動、智譜(02513.HK) -34.000 (-3.553%)) 沽空 $9.12千萬; 比率 6.295%) 及阿里-W(09988.HK) -0.700 (-0.532%)) 沽空 $15.97億; 比率 17.830%) 入選。. 《時代》雜誌指出,字節跳動旗下AI助理「豆包」已累積超過" source context "《時代》雜誌公布2026年十大最具影響力AI公司榜單字節跳動" Reference image 2: visual subject "《時代》雜誌公布2026年十大最具影響力人工智能公司榜單,字節跳動、智譜(02513.HK) -34.000 (-3.553%)) 沽空 $9.12千萬; 比率 6.295%) 及阿里-W(09988.HK) -0.700 (-0.532%)) 沽空 $15.97億; 比率 17.830%) 入選。. 《時代》雜誌指出,字節跳動旗下AI助理「豆包」已累積超過" source context "《時代》雜誌公布2026年十大最具影響力AI公司榜單字節跳動" Style: pre
openai.com
Le piège le plus courant, lorsqu’on veut utiliser l’IA pour écrire un article de blog, une newsletter ou une page de vente, consiste à prendre un classement général de LLM et à le lire comme un classement de copywriting. Or les comparatifs publics ne mesurent pas tous la même chose : certains évaluent la performance, la vitesse et le coût ; d’autres le raisonnement, l’écriture, le contexte long, le multimodal ou des tâches marketing réelles.
Studio Global AI
Continuez vos recherches
Cette page comprend une réponse basée sur la source que vous pouvez continuer dans Studio Global.
Quelle est la réponse courte à « Claude, GPT, Gemini, DeepSeek, Grok : quels modèles d’IA choisir pour écrire en marketing en 2026 ? » ?
En 2026, aucun classement unique ne suffit à désigner les meilleurs modèles d’IA pour la rédaction marketing : les benchmarks mesurent souvent des critères différents.
Quels sont les points clés à valider en premier ?
En 2026, aucun classement unique ne suffit à désigner les meilleurs modèles d’IA pour la rédaction marketing : les benchmarks mesurent souvent des critères différents. Pour démarrer vite, testez dans cet ordre Claude, GPT/ChatGPT, Gemini, DeepSeek puis Grok, en gardant en tête que ce n’est pas un podium définitif.
Que dois-je faire ensuite en pratique ?
Le meilleur choix dépendra surtout de votre brief, de votre voix de marque, de vos contraintes de vérification et du temps nécessaire pour transformer un brouillon en contenu publiable.
Claude, GPT, Gemini, DeepSeek, Grok : quels modèles d’IA choisir pour écrire en marketing en 2026 ?
En 2026, aucun classement unique ne suffit à désigner les meilleurs modèles d’IA pour la rédaction marketing : les benchmarks mesurent souvent des critères différents. Pour démarrer vite, testez dans cet ordre Claude, GPT/ChatGPT, Gemini, DeepSeek puis Grok, en gardant en tête que ce n’est pas un podium définitif.
Publié parModifié avec GPT-5.5Images générées avec GPT Image 2
En 2026, aucun classement unique ne suffit à désigner les meilleurs modèles d’IA pour la rédaction marketing : les benchmarks mesurent souvent des critères différents.
Pour démarrer vite, testez dans cet ordre Claude, GPT/ChatGPT, Gemini, DeepSeek puis Grok, en gardant en tête que ce n’est pas un podium définitif.
Le meilleur choix dépendra surtout de votre brief, de votre voix de marque, de vos contraintes de vérification et du temps nécessaire pour transformer un brouillon en contenu publiable.
2026 行銷寫作 AI 模型前五名:部落格與 Email 先測這 5 個行銷寫作模型不該只看通用排行榜;用同一份 brief 實測,才能看出哪個模型最省編修時間。
Prompt IA
Create a landscape editorial hero image for this Studio Global article: 2026 行銷寫作 AI 模型前五名:部落格與 Email 先測這 5 個. Article summary: 2026 年沒有單一官方榜單能決定行銷寫作 AI 前五名;最實用的縮小範圍,是先測 Claude、GPT/ChatGPT、Gemini、DeepSeek、Grok,並用同一份 brief 比較品牌語氣、事實可靠度與編修成本。. Topic tags: ai, content marketing, email marketing, seo, copywriting. Reference image context from search candidates: Reference image 1: visual subject "《時代》雜誌公布2026年十大最具影響力人工智能公司榜單,字節跳動、智譜(02513.HK) -34.000 (-3.553%)) 沽空 $9.12千萬; 比率 6.295%) 及阿里-W(09988.HK) -0.700 (-0.532%)) 沽空 $15.97億; 比率 17.830%) 入選。. 《時代》雜誌指出,字節跳動旗下AI助理「豆包」已累積超過" source context "《時代》雜誌公布2026年十大最具影響力AI公司榜單字節跳動" Reference image 2: visual subject "《時代》雜誌公布2026年十大最具影響力人工智能公司榜單,字節跳動、智譜(02513.HK) -34.000 (-3.553%)) 沽空 $9.12千萬; 比率 6.295%) 及阿里-W(09988.HK) -0.700 (-0.532%)) 沽空 $15.97億; 比率 17.830%) 入選。. 《時代》雜誌指出,字節跳動旗下AI助理「豆包」已累積超過" source context "《時代》雜誌公布2026年十大最具影響力AI公司榜單字節跳動" Style: pre
openai.com
Le piège le plus courant, lorsqu’on veut utiliser l’IA pour écrire un article de blog, une newsletter ou une page de vente, consiste à prendre un classement général de LLM et à le lire comme un classement de copywriting. Or les comparatifs publics ne mesurent pas tous la même chose : certains évaluent la performance, la vitesse et le coût ; d’autres le raisonnement, l’écriture, le contexte long, le multimodal ou des tâches marketing réelles.
Studio Global AI
Continuez vos recherches
Cette page comprend une réponse basée sur la source que vous pouvez continuer dans Studio Global.
Quelle est la réponse courte à « Claude, GPT, Gemini, DeepSeek, Grok : quels modèles d’IA choisir pour écrire en marketing en 2026 ? » ?
En 2026, aucun classement unique ne suffit à désigner les meilleurs modèles d’IA pour la rédaction marketing : les benchmarks mesurent souvent des critères différents.
Quels sont les points clés à valider en premier ?
En 2026, aucun classement unique ne suffit à désigner les meilleurs modèles d’IA pour la rédaction marketing : les benchmarks mesurent souvent des critères différents. Pour démarrer vite, testez dans cet ordre Claude, GPT/ChatGPT, Gemini, DeepSeek puis Grok, en gardant en tête que ce n’est pas un podium définitif.
Que dois-je faire ensuite en pratique ?
Le meilleur choix dépendra surtout de votre brief, de votre voix de marque, de vos contraintes de vérification et du temps nécessaire pour transformer un brouillon en contenu publiable.
La réponse la plus utile n’est donc pas : « voici le numéro 1 absolu ». Pour une équipe contenu ou marketing, il vaut mieux raisonner en familles de modèles à tester en priorité. Si vos cas d’usage incluent les articles de blog, les e-mails, les pages d’atterrissage, les posts sociaux, les publicités ou la réécriture dans une voix de marque, les cinq candidats à mettre dans votre banc d’essai sont : Claude, GPT/ChatGPT, Gemini, DeepSeek et Grok. Ces familles figurent dans des évaluations orientées marketing, et d’autres comparatifs 2026 placent régulièrement GPT, Claude et Gemini parmi les grands modèles à considérer.
Le classement pratique : quel modèle tester pour quel usage ?
Ordre de test conseillé
Famille de modèles
À tester d’abord pour…
Pourquoi l’inclure
1
Claude
Articles longs, e-mails professionnels, réécriture de voix de marque, édition approfondie
Des comparatifs associent Claude, et notamment Claude Opus 4.5, à l’écriture professionnelle et à la qualité de prose ; c’est un bon candidat si la finition éditoriale compte plus que la vitesse brute.
2
GPT / ChatGPT
Brief de campagne, plan, premier jet, objets d’e-mail, CTA, variantes publicitaires
GPT est décrit dans les comparatifs comme adapté au travail professionnel équilibré et comme un écosystème généraliste solide, ce qui en fait un bon modèle de référence pour une équipe marketing.
3
Gemini
Synthèse de documents longs, transformation de présentations en articles, workflows multimodaux
Gemini revient souvent dans les comparatifs pour le contexte long, les workflows multimodaux, l’efficacité coût et les tâches temps réel/multimodales.
4
DeepSeek
Variantes de titres en volume, brouillons de recherche, tri d’informations, tests sensibles au coût
DeepSeek apparaît dans une évaluation marketing aux côtés de ChatGPT, Gemini, Claude et GrokAI ; un autre comparatif présente aussi DeepSeek V3 sous l’angle du rapport valeur/prix pour les développeurs.
5
Grok
Idées de posts sociaux, contexte de tendances, brouillons rapides liés à l’actualité de X
GrokAI figure dans une comparaison de modèles pour le marketing, tandis qu’un autre comparatif associe Grok à la vitesse et aux données X en temps réel.
Cet ordre ne signifie pas que Claude sera toujours « meilleur » ni que Grok devra toujours arriver en dernier. Il donne surtout une manière efficace de commencer : d’abord les modèles susceptibles d’améliorer la qualité du texte final, puis ceux qui peuvent apporter un avantage sur le coût, la vitesse, le volume ou le contexte social.
Pourquoi il ne faut pas chercher seulement « le meilleur modèle »
La rédaction marketing n’est pas une épreuve unique. Un article de blog doit répondre à une intention de recherche, structurer l’information et rester lisible. Un e-mail doit convaincre dès l’objet, créer une raison de cliquer et mener à un appel à l’action. Une page d’atterrissage doit hiérarchiser les bénéfices et soutenir la conversion. Un contenu de marque, lui, doit rester cohérent dans le ton et éviter les promesses impossibles à vérifier.
C’est exactement pour cela qu’un benchmark généraliste ne suffit pas. Un leaderboard LLM peut comparer des scores de performance, de vitesse ou de coût ; un comparatif marketing peut intégrer des tâches réelles ; un autre test général peut mélanger raisonnement, code, écriture, contexte long, multimodal et prix d’API. La vraie question devient donc : quel modèle réduit le plus votre temps d’édition tout en respectant votre produit, votre public et votre objectif de conversion ?
Comment choisir entre Claude, GPT, Gemini, DeepSeek et Grok
1. Claude : à tester en priorité pour les textes longs et la voix de marque
Claude mérite d’être essayé en premier si vos contenus sont longs, experts ou sensibles au ton : articles B2B, livres blancs, e-mails de fondateur, séquences d’éducation client, contenus pour produits à cycle de décision long. Des sources publiques relient Claude Opus 4.5 à l’écriture professionnelle, et un autre comparatif résume Claude comme fort en qualité de code et de prose.
Le bon test ne consiste pas seulement à lui demander un premier jet. Essayez plutôt des tâches d’édition : transformer un brouillon plat en texte plus élégant, rendre un paragraphe moins lourd, adapter un e-mail à une voix plus experte, plus chaleureuse ou plus directe. C’est là que l’on voit si le modèle fait réellement gagner du temps à l’équipe éditoriale.
2. GPT / ChatGPT : le modèle de référence pour un flux marketing complet
GPT/ChatGPT est souvent le meilleur point de départ pour construire un workflow complet : idéation de campagne, angles de message, plan d’article, objets d’e-mail, variantes de publicités, CTA et reformulations. Les comparatifs le présentent comme un choix équilibré pour le travail professionnel et comme un écosystème généraliste solide.
Si vous ne voulez tester qu’un seul flux au départ, faites tourner toute la chaîne avec GPT/ChatGPT, puis comparez les autres modèles sur ses points faibles : style plus fin, meilleure gestion de longs documents, coût, rapidité ou contexte temps réel.
3. Gemini : intéressant quand il faut absorber beaucoup de matière avant d’écrire
L’intérêt de Gemini ne se limite pas à la rédaction. Son enjeu est plutôt la capacité à partir de nombreux éléments — documents, notes, présentations, transcriptions, visuels ou supports produit — pour produire ensuite un contenu exploitable. Des comparatifs l’associent au contexte long, aux workflows multimodaux, à l’efficacité coût, ainsi qu’aux tâches temps réel et multimodales.
Il vaut donc la peine de le tester si votre équipe transforme souvent des présentations commerciales en articles, des recherches en newsletters, des comptes rendus en posts LinkedIn ou plusieurs documents produit en séquences d’e-mails.
4. DeepSeek : utile pour le volume, les variantes et les brouillons de travail
DeepSeek n’est pas forcément le premier choix pour une version finale très travaillée dans une voix de marque. En revanche, il peut être pertinent pour les tâches de volume : générer beaucoup de titres, classer des informations, produire des FAQ de départ, préparer des brouillons de recherche ou tester rapidement plusieurs angles. Une évaluation marketing l’a comparé à ChatGPT, Gemini, Claude et GrokAI, et un autre comparatif présente DeepSeek V3 comme un bon choix de valeur pour les développeurs.
Pour une équipe marketing, l’approche la plus prudente consiste à l’utiliser comme moteur d’exploration ou de préproduction, puis à faire relire, vérifier et resserrer le contenu avant publication.
5. Grok : à considérer pour les sujets sociaux et les tendances rapides
Grok n’est pas indispensable à toutes les équipes contenu. Il devient plus intéressant si votre marque travaille beaucoup avec les tendances sociales, les conversations sur X ou des réactions rapides à l’actualité. GrokAI apparaît dans une comparaison de modèles marketing, et un autre comparatif associe Grok à la vitesse et aux données X en temps réel.
Les bons cas de test : angles de posts sociaux, reformulations courtes, brouillons de réponses, synthèses de tendances ou variations rapides de messages. Plus un contenu dépend d’un contexte en temps réel, plus la vérification humaine devient importante.
Ne confondez pas modèle d’IA et système de production de contenu
Pour un indépendant, utiliser directement un modèle peut suffire. Pour une équipe, le modèle n’est souvent qu’une partie de la réponse. Des outils comme Jasper, AI Writer ou Writesonic s’appuient sur des grands modèles connus — ChatGPT, Claude, Gemini — puis ajoutent une couche produit : paramètres de voix de marque, modèles de contenus, intégrations SEO et fonctions de workflow.
C’est un point essentiel. Les outils de rédaction IA sont régulièrement positionnés sur des cas d’usage marketing comme les titres de pages d’atterrissage, les séquences d’e-mails, les posts sociaux ou les variantes publicitaires. Autrement dit : le modèle fixe une partie du plafond de qualité, mais l’outil détermine souvent la facilité à reproduire cette qualité dans une vraie organisation.
Avant de choisir, posez donc aussi ces questions :
Peut-on enregistrer une voix de marque, des termes interdits et des formulations produit validées ?
Existe-t-il des modèles pour blog, e-mail, réseaux sociaux, publicité et pages d’atterrissage ?
L’outil aide-t-il à préparer un brief SEO, des mots-clés ou une structure d’article ?
Les validations, commentaires, versions et droits d’accès sont-ils pratiques pour une équipe ?
Peut-il s’intégrer à votre CMS, votre plateforme e-mail ou vos outils d’automatisation marketing ?
La méthode la plus fiable : un même brief, cinq modèles, une grille commune
Pour comparer correctement, évitez le prompt vague du type : « écris-moi un article de blog ». Préparez plutôt un brief marketing identique, puis demandez à Claude, GPT/ChatGPT, Gemini, DeepSeek et Grok de réaliser les mêmes tâches.
Un brief utile devrait contenir au minimum :
La description du produit ou du service
La cible et son contexte d’achat
Le format attendu : article, e-mail, post social, page d’atterrissage ou publicité
La voix de marque : experte, chaleureuse, directe, premium, pédagogique, etc.
Les bénéfices à inclure, les sources à respecter et les formulations à éviter
L’appel à l’action et l’objectif de conversion
La longueur, la langue, la zone géographique et les contraintes de conformité
Demandez ensuite à chaque modèle de produire le même lot :
un plan ;
un premier jet complet ;
trois titres ou objets d’e-mail ;
trois variantes de CTA ;
une version réécrite dans la voix de marque ;
une liste des risques, approximations et faits à vérifier.
Puis notez les résultats avec une grille simple :
Critère
Ce qu’il faut observer
Voix de marque
Le texte ressemble-t-il vraiment à votre marque ou à une copie IA générique ?
Lisibilité
Le texte est-il clair, naturel, rythmé ?
Intention de recherche
L’article répond-il à la vraie question du lecteur ?
Capacité de conversion e-mail
L’objet, l’accroche et le CTA donnent-ils une direction nette ?
Fiabilité factuelle
Le modèle invente-t-il, exagère-t-il ou demande-t-il trop de corrections ?
Coût d’édition
Combien de temps faut-il pour passer du brouillon à une version publiable ?
Intégration au workflow
Le modèle ou l’outil s’insère-t-il dans vos processus SEO, e-mail, CMS et validation ?
Le gagnant n’est pas celui qui produit le texte le plus impressionnant à la première lecture. C’est celui qui livre, de façon régulière, un brouillon que votre équipe peut publier avec le moins de reprises possible.
Verdict
Si vous voulez commencer sans passer des semaines à comparer, testez dans cet ordre : Claude → GPT/ChatGPT → Gemini → DeepSeek → Grok.
La logique est simple : Claude pour la qualité des textes longs et l’édition de la voix de marque ; GPT/ChatGPT pour le workflow marketing généraliste ; Gemini pour les documents longs et les matériaux multimodaux ; DeepSeek et Grok pour les tests de coût, de volume, de vitesse ou de contexte social en temps réel.
Mais le vrai « meilleur modèle » n’existe pas en dehors de votre cas d’usage. Pour la rédaction marketing, le bon choix est celui qui comprend vos informations produit, respecte votre ton, parle à votre audience et réduit réellement le temps nécessaire pour produire un contenu fiable et publiable.
La réponse la plus utile n’est donc pas : « voici le numéro 1 absolu ». Pour une équipe contenu ou marketing, il vaut mieux raisonner en familles de modèles à tester en priorité. Si vos cas d’usage incluent les articles de blog, les e-mails, les pages d’atterrissage, les posts sociaux, les publicités ou la réécriture dans une voix de marque, les cinq candidats à mettre dans votre banc d’essai sont : Claude, GPT/ChatGPT, Gemini, DeepSeek et Grok. Ces familles figurent dans des évaluations orientées marketing, et d’autres comparatifs 2026 placent régulièrement GPT, Claude et Gemini parmi les grands modèles à considérer.
Le classement pratique : quel modèle tester pour quel usage ?
Ordre de test conseillé
Famille de modèles
À tester d’abord pour…
Pourquoi l’inclure
1
Claude
Articles longs, e-mails professionnels, réécriture de voix de marque, édition approfondie
Des comparatifs associent Claude, et notamment Claude Opus 4.5, à l’écriture professionnelle et à la qualité de prose ; c’est un bon candidat si la finition éditoriale compte plus que la vitesse brute.
2
GPT / ChatGPT
Brief de campagne, plan, premier jet, objets d’e-mail, CTA, variantes publicitaires
GPT est décrit dans les comparatifs comme adapté au travail professionnel équilibré et comme un écosystème généraliste solide, ce qui en fait un bon modèle de référence pour une équipe marketing.
3
Gemini
Synthèse de documents longs, transformation de présentations en articles, workflows multimodaux
Gemini revient souvent dans les comparatifs pour le contexte long, les workflows multimodaux, l’efficacité coût et les tâches temps réel/multimodales.
4
DeepSeek
Variantes de titres en volume, brouillons de recherche, tri d’informations, tests sensibles au coût
DeepSeek apparaît dans une évaluation marketing aux côtés de ChatGPT, Gemini, Claude et GrokAI ; un autre comparatif présente aussi DeepSeek V3 sous l’angle du rapport valeur/prix pour les développeurs.
5
Grok
Idées de posts sociaux, contexte de tendances, brouillons rapides liés à l’actualité de X
GrokAI figure dans une comparaison de modèles pour le marketing, tandis qu’un autre comparatif associe Grok à la vitesse et aux données X en temps réel.
Cet ordre ne signifie pas que Claude sera toujours « meilleur » ni que Grok devra toujours arriver en dernier. Il donne surtout une manière efficace de commencer : d’abord les modèles susceptibles d’améliorer la qualité du texte final, puis ceux qui peuvent apporter un avantage sur le coût, la vitesse, le volume ou le contexte social.
Pourquoi il ne faut pas chercher seulement « le meilleur modèle »
La rédaction marketing n’est pas une épreuve unique. Un article de blog doit répondre à une intention de recherche, structurer l’information et rester lisible. Un e-mail doit convaincre dès l’objet, créer une raison de cliquer et mener à un appel à l’action. Une page d’atterrissage doit hiérarchiser les bénéfices et soutenir la conversion. Un contenu de marque, lui, doit rester cohérent dans le ton et éviter les promesses impossibles à vérifier.
C’est exactement pour cela qu’un benchmark généraliste ne suffit pas. Un leaderboard LLM peut comparer des scores de performance, de vitesse ou de coût ; un comparatif marketing peut intégrer des tâches réelles ; un autre test général peut mélanger raisonnement, code, écriture, contexte long, multimodal et prix d’API. La vraie question devient donc : quel modèle réduit le plus votre temps d’édition tout en respectant votre produit, votre public et votre objectif de conversion ?
Comment choisir entre Claude, GPT, Gemini, DeepSeek et Grok
1. Claude : à tester en priorité pour les textes longs et la voix de marque
Claude mérite d’être essayé en premier si vos contenus sont longs, experts ou sensibles au ton : articles B2B, livres blancs, e-mails de fondateur, séquences d’éducation client, contenus pour produits à cycle de décision long. Des sources publiques relient Claude Opus 4.5 à l’écriture professionnelle, et un autre comparatif résume Claude comme fort en qualité de code et de prose.
Le bon test ne consiste pas seulement à lui demander un premier jet. Essayez plutôt des tâches d’édition : transformer un brouillon plat en texte plus élégant, rendre un paragraphe moins lourd, adapter un e-mail à une voix plus experte, plus chaleureuse ou plus directe. C’est là que l’on voit si le modèle fait réellement gagner du temps à l’équipe éditoriale.
2. GPT / ChatGPT : le modèle de référence pour un flux marketing complet
GPT/ChatGPT est souvent le meilleur point de départ pour construire un workflow complet : idéation de campagne, angles de message, plan d’article, objets d’e-mail, variantes de publicités, CTA et reformulations. Les comparatifs le présentent comme un choix équilibré pour le travail professionnel et comme un écosystème généraliste solide.
Si vous ne voulez tester qu’un seul flux au départ, faites tourner toute la chaîne avec GPT/ChatGPT, puis comparez les autres modèles sur ses points faibles : style plus fin, meilleure gestion de longs documents, coût, rapidité ou contexte temps réel.
3. Gemini : intéressant quand il faut absorber beaucoup de matière avant d’écrire
L’intérêt de Gemini ne se limite pas à la rédaction. Son enjeu est plutôt la capacité à partir de nombreux éléments — documents, notes, présentations, transcriptions, visuels ou supports produit — pour produire ensuite un contenu exploitable. Des comparatifs l’associent au contexte long, aux workflows multimodaux, à l’efficacité coût, ainsi qu’aux tâches temps réel et multimodales.
Il vaut donc la peine de le tester si votre équipe transforme souvent des présentations commerciales en articles, des recherches en newsletters, des comptes rendus en posts LinkedIn ou plusieurs documents produit en séquences d’e-mails.
4. DeepSeek : utile pour le volume, les variantes et les brouillons de travail
DeepSeek n’est pas forcément le premier choix pour une version finale très travaillée dans une voix de marque. En revanche, il peut être pertinent pour les tâches de volume : générer beaucoup de titres, classer des informations, produire des FAQ de départ, préparer des brouillons de recherche ou tester rapidement plusieurs angles. Une évaluation marketing l’a comparé à ChatGPT, Gemini, Claude et GrokAI, et un autre comparatif présente DeepSeek V3 comme un bon choix de valeur pour les développeurs.
Pour une équipe marketing, l’approche la plus prudente consiste à l’utiliser comme moteur d’exploration ou de préproduction, puis à faire relire, vérifier et resserrer le contenu avant publication.
5. Grok : à considérer pour les sujets sociaux et les tendances rapides
Grok n’est pas indispensable à toutes les équipes contenu. Il devient plus intéressant si votre marque travaille beaucoup avec les tendances sociales, les conversations sur X ou des réactions rapides à l’actualité. GrokAI apparaît dans une comparaison de modèles marketing, et un autre comparatif associe Grok à la vitesse et aux données X en temps réel.
Les bons cas de test : angles de posts sociaux, reformulations courtes, brouillons de réponses, synthèses de tendances ou variations rapides de messages. Plus un contenu dépend d’un contexte en temps réel, plus la vérification humaine devient importante.
Ne confondez pas modèle d’IA et système de production de contenu
Pour un indépendant, utiliser directement un modèle peut suffire. Pour une équipe, le modèle n’est souvent qu’une partie de la réponse. Des outils comme Jasper, AI Writer ou Writesonic s’appuient sur des grands modèles connus — ChatGPT, Claude, Gemini — puis ajoutent une couche produit : paramètres de voix de marque, modèles de contenus, intégrations SEO et fonctions de workflow.
C’est un point essentiel. Les outils de rédaction IA sont régulièrement positionnés sur des cas d’usage marketing comme les titres de pages d’atterrissage, les séquences d’e-mails, les posts sociaux ou les variantes publicitaires. Autrement dit : le modèle fixe une partie du plafond de qualité, mais l’outil détermine souvent la facilité à reproduire cette qualité dans une vraie organisation.
Avant de choisir, posez donc aussi ces questions :
Peut-on enregistrer une voix de marque, des termes interdits et des formulations produit validées ?
Existe-t-il des modèles pour blog, e-mail, réseaux sociaux, publicité et pages d’atterrissage ?
L’outil aide-t-il à préparer un brief SEO, des mots-clés ou une structure d’article ?
Les validations, commentaires, versions et droits d’accès sont-ils pratiques pour une équipe ?
Peut-il s’intégrer à votre CMS, votre plateforme e-mail ou vos outils d’automatisation marketing ?
La méthode la plus fiable : un même brief, cinq modèles, une grille commune
Pour comparer correctement, évitez le prompt vague du type : « écris-moi un article de blog ». Préparez plutôt un brief marketing identique, puis demandez à Claude, GPT/ChatGPT, Gemini, DeepSeek et Grok de réaliser les mêmes tâches.
Un brief utile devrait contenir au minimum :
La description du produit ou du service
La cible et son contexte d’achat
Le format attendu : article, e-mail, post social, page d’atterrissage ou publicité
La voix de marque : experte, chaleureuse, directe, premium, pédagogique, etc.
Les bénéfices à inclure, les sources à respecter et les formulations à éviter
L’appel à l’action et l’objectif de conversion
La longueur, la langue, la zone géographique et les contraintes de conformité
Demandez ensuite à chaque modèle de produire le même lot :
un plan ;
un premier jet complet ;
trois titres ou objets d’e-mail ;
trois variantes de CTA ;
une version réécrite dans la voix de marque ;
une liste des risques, approximations et faits à vérifier.
Puis notez les résultats avec une grille simple :
Critère
Ce qu’il faut observer
Voix de marque
Le texte ressemble-t-il vraiment à votre marque ou à une copie IA générique ?
Lisibilité
Le texte est-il clair, naturel, rythmé ?
Intention de recherche
L’article répond-il à la vraie question du lecteur ?
Capacité de conversion e-mail
L’objet, l’accroche et le CTA donnent-ils une direction nette ?
Fiabilité factuelle
Le modèle invente-t-il, exagère-t-il ou demande-t-il trop de corrections ?
Coût d’édition
Combien de temps faut-il pour passer du brouillon à une version publiable ?
Intégration au workflow
Le modèle ou l’outil s’insère-t-il dans vos processus SEO, e-mail, CMS et validation ?
Le gagnant n’est pas celui qui produit le texte le plus impressionnant à la première lecture. C’est celui qui livre, de façon régulière, un brouillon que votre équipe peut publier avec le moins de reprises possible.
Verdict
Si vous voulez commencer sans passer des semaines à comparer, testez dans cet ordre : Claude → GPT/ChatGPT → Gemini → DeepSeek → Grok.
La logique est simple : Claude pour la qualité des textes longs et l’édition de la voix de marque ; GPT/ChatGPT pour le workflow marketing généraliste ; Gemini pour les documents longs et les matériaux multimodaux ; DeepSeek et Grok pour les tests de coût, de volume, de vitesse ou de contexte social en temps réel.
Mais le vrai « meilleur modèle » n’existe pas en dehors de votre cas d’usage. Pour la rédaction marketing, le bon choix est celui qui comprend vos informations produit, respecte votre ton, parle à votre audience et réduit réellement le temps nécessaire pour produire un contenu fiable et publiable.
yourgpt.aiLLM Leaderboard 2026 | Compare GPT-5, Claude, Gemini & More
chapters-eg.comAI Models Ranking: Which AI Should You Use for Marketing in 2026
chatsmith.ioBest AI Models in 2026: Compare the Top 8 AI Tools Head- ...
appscribed.comBest AI Models 2026: Claude Vs GPT Vs Gemini Compared | Appscribed
whatllm.orgBest AI Model January 2026 | Top 3 LLMs Ranked (Expert Picks)