OpenAI, Claude, DeepSeek, Gemini, Grok : quel modèle IA pour vos contenus marketing ?
Les sources citées comparent surtout prix, fenêtres de contexte, caching et outils : elles ne suffisent pas à désigner un champion universel du contenu marketing. Le coût API dépend séparément des tokens d’entrée et de sortie : les briefs longs, transcriptions et dossiers concurrents ne se budgètent pas comme des va...
Publié parModifié avec GPT-5.5Images générées avec GPT Image 2
Les sources citées comparent surtout prix, fenêtres de contexte, caching et outils : elles ne suffisent pas à désigner un champion universel du contenu marketing.
Le coût API dépend séparément des tokens d’entrée et de sortie : les briefs longs, transcriptions et dossiers concurrents ne se budgètent pas comme des variantes d’annonces ou fiches produits.
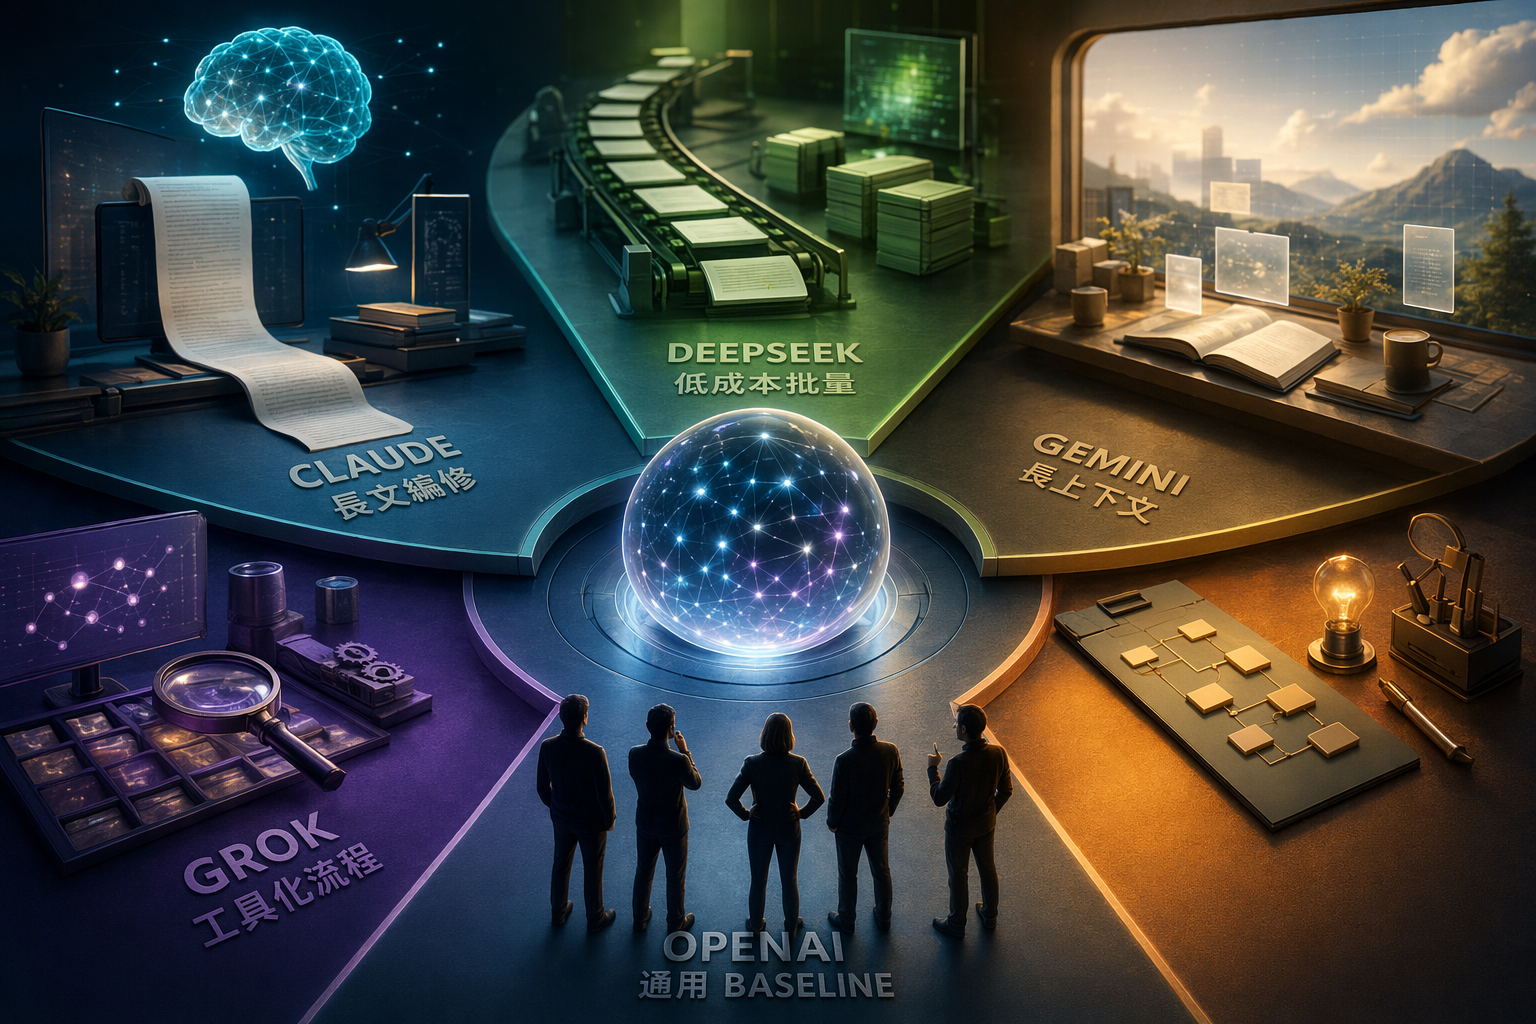
Une approche pragmatique consiste à tester OpenAI comme référence généraliste, Claude pour l’édition longue et la voix de marque, DeepSeek pour le volume, Gemini pour les grands contextes et Grok pour les workflows ou...
OpenAI、Claude、DeepSeek、Gemini、Grok 怎麼選?內容創作與行銷團隊指南AI 生成示意圖:內容團隊在研究、SEO、長文編修與自動化流程中比較不同 AI 模型。
Prompt IA
Create a landscape editorial hero image for this Studio Global article: OpenAI、Claude、DeepSeek、Gemini、Grok 怎麼選?內容創作與行銷團隊指南. Article summary: 截至 2026 年可引用的公開資料,沒有證據支持五者中有單一內容行銷冠軍;更務實的分工是 OpenAI 當通用 baseline、Claude 測長文編修、DeepSeek 跑低成本批量、Gemini 處理長上下文、Grok 評估工具化流程。最後仍要用自家 KPI 實測。. Topic tags: ai, content marketing, seo, openai, claude. Reference image context from search candidates: Reference image 1: visual subject "# 2026 最新五大主流 AI 語言模型 (LLM) 全解析,付費、應用與安全性一次看懂. 2026 最新五大主流 AI 語言模型 (LLM) 全解析,付費、應用與安全性一次看懂 全解析,付費、應用與安全性一次看懂"). 近幾年有多款大型語言模型 (LLM) 接連問世,對一般用戶來說,到底哪一款最適合日常需求。本次整理 5 款主流 LLM,分別為 GPT‑" source context "2026 最新五大主流 AI 語言模型 (LLM) 全解析,付費、應用與安全性一次看懂 | 鏈新聞 ABMedia" Reference image 2: visual subject "## Loading. ## Loading. # 生命不息,折腾不止. ## 要有最朴素的生活,与最遥远的梦想。即使明日天寒地冻、路远马亡。. # 【译】Grok 3 vs ChatGPT vs DeepSeek vs Claude vs Gemini:2025年2月哪款AI最好?. 人工智能(AI)的进步速度前所未有,几乎每周都有新的模型和技术问世。20" source c
openai.com
Le mauvais réflexe, quand une équipe contenu choisit un modèle d’IA, consiste à chercher le classement qui désigne un vainqueur. Pour un usage marketing, c’est rarement la bonne question. Les données publiques permettent de comparer des tarifs API, des fenêtres de contexte, le prompt caching ou les outils server-side ; elles ne prouvent pas, à elles seules, qu’un modèle fera mieux monter vos pages SEO, améliorera vos conversions publicitaires ou gardera toujours la voix de marque la plus cohérente.
Studio Global AI
Continuez vos recherches
Cette page comprend une réponse basée sur la source que vous pouvez continuer dans Studio Global.
Quelle est la réponse courte à « OpenAI, Claude, DeepSeek, Gemini, Grok : quel modèle IA pour vos contenus marketing ? » ?
Les sources citées comparent surtout prix, fenêtres de contexte, caching et outils : elles ne suffisent pas à désigner un champion universel du contenu marketing.
Quels sont les points clés à valider en premier ?
Les sources citées comparent surtout prix, fenêtres de contexte, caching et outils : elles ne suffisent pas à désigner un champion universel du contenu marketing. Le coût API dépend séparément des tokens d’entrée et de sortie : les briefs longs, transcriptions et dossiers concurrents ne se budgètent pas comme des variantes d’annonces ou fiches produits.
Que dois-je faire ensuite en pratique ?
Une approche pragmatique consiste à tester OpenAI comme référence généraliste, Claude pour l’édition longue et la voix de marque, DeepSeek pour le volume, Gemini pour les grands contextes et Grok pour les workflows ou...
La bonne question est plus opérationnelle : quel modèle placer à quel endroit du flux de production ?
La réponse courte : répartir les tâches avant de choisir un champion
Besoin de l’équipe
À tester en priorité
Pourquoi
Point de vigilance
Recherche, briefs, synthèse de campagne, premier jet puis finalisation
OpenAI
Des comparateurs tiers listent plusieurs niveaux de modèles OpenAI, avec des prix d’entrée et de sortie différents ainsi que des options de contexte ; TLDL décrit la famille GPT-4.1 comme offrant 1 M de tokens de contexte à un prix intermédiaire.
Bon point de départ, mais pas une preuve qu’OpenAI gagne tous les cas d’usage contenu.
Articles longs, réécriture, ton de marque, règles éditoriales fixes
Claude
La documentation tarifaire officielle de Claude distingue Base Input Tokens, Cache Writes, Cache Hits et Output Tokens, ce qui aide à intégrer des consignes de marque ou des gabarits réutilisés dans le calcul de coût.
Mesurer le taux de textes publiables, le temps de retouche et la cohérence de marque, pas seulement la fluidité du premier jet.
Gros volume de brouillons SEO, fiches produits, FAQ, variantes publicitaires
DeepSeek
DeepSeek publie une page officielle Models & Pricing ; un guide tiers DecodesFuture décrit un tarif unifié chat/reasoning d’environ 0,28 $ par million de tokens d’entrée et 0,42 $ par million de tokens de sortie, avec une baisse de coût annoncée de 94 à 96 % par rapport à OpenAI o3 ou GPT-4.1.
Le coût bas est utile pour produire en volume, mais ne remplace pas la vérification factuelle ni la relecture de marque.
Très longs briefs, dossiers concurrents, transcriptions, lots de mots-clés
Gemini
MorphLLM indique que Gemini 2.5 Flash dispose d’un contexte de 1 M de tokens, d’un prix de 2,50 $ par million de tokens de sortie et d’un niveau gratuit ; TLDL classe Gemini 2.5 Pro parmi les modèles à 2 M de tokens de contexte.
Les caractéristiques Gemini citées ici viennent surtout de comparatifs tiers : à valider dans vos propres documents fournisseur avant achat.
Appels d’outils, automatisation, pipeline de contenu connecté à des données
Grok
La documentation officielle de xAI présente Models and Pricing et sépare la tarification des server-side tools dans Tools Pricing ; TLDL indique aussi que xAI propose deux modèles à 2 M de tokens de contexte.
À tester pour les workflows outillés ; les sources citées ne suffisent pas à prouver une supériorité stable sur la qualité de rédaction marketing générale.
Avant les modèles, regardez votre structure de coût
Les API de génération de texte facturent généralement l’usage en tokens. Chaque fournisseur fixe ses propres niveaux de prix, souvent par million de tokens. Les tokens d’entrée correspondent au prompt et au contexte que vous envoyez au modèle ; les tokens de sortie correspondent au texte généré par le modèle.
Pour une équipe marketing, cette distinction change tout. Deux tâches qui semblent proches peuvent avoir des coûts très différents :
Tâches riches en entrée : analyse de pages concurrentes, synthèse de transcriptions d’entretiens, audit de mots-clés SEO, digestion de documentation produit, préparation d’un brief stratégique. La pression budgétaire vient surtout du volume de contexte que vous injectez dans le modèle.
Tâches riches en sortie : titres publicitaires, fiches produits, FAQ, posts sociaux, adaptations multilingues, variantes A/B. Ici, le prix des tokens de sortie et le volume de générations deviennent déterminants.
Si vous réutilisez à chaque appel un guide de ton, des contraintes juridiques, une structure SEO ou un modèle d’article, examinez aussi le prompt caching, c’est-à-dire la mise en cache des consignes répétées. La documentation officielle de Claude sépare les coûts de cache writes et de cache hits, ce qui montre que le contexte répété n’est pas seulement une question de prompt : c’est aussi un sujet de workflow et de budget.
OpenAI : le bon étalon de départ
OpenAI est souvent le meilleur point de départ pour construire un benchmark interne. Non pas parce que les sources publiques prouvent qu’il domine tous les usages marketing, mais parce que des comparateurs tiers listent plusieurs niveaux de modèles OpenAI. Cela permet de tester une logique à deux vitesses : un modèle plus robuste pour la stratégie, la recherche et la finalisation ; un modèle moins coûteux pour les résumés, reformulations et variantes en volume.
TLDL décrit la famille GPT-4.1 comme offrant 1 M de tokens de contexte à un prix intermédiaire, ce qui en fait un candidat naturel pour les briefs longs, la synthèse de recherche et la consolidation de campagnes. Prudence toutefois : les informations de prix et de contexte OpenAI utilisées ici proviennent surtout de sources tierces, et non d’une citation directe de documentation officielle.
À tester en priorité : plans de pages piliers SEO, messages de campagne, synthèses de recherche, premiers jets d’articles, variantes de titres, sections d’e-mailing et recyclage de contenus longs en formats courts. Dans votre grille d’évaluation, séparez toujours la qualité éditoriale du coût : un même fournisseur peut proposer des modèles avec des fenêtres de contexte et des prix par million de tokens très différents.
Claude : à privilégier pour l’édition longue et la cohérence de marque
Claude mérite une place prioritaire dès que le sujet est la longue forme : réécriture d’articles, notes de synthèse, livres blancs, correction de structure ou application stricte d’une charte éditoriale. La documentation officielle de Claude API détaille les catégories Base Input Tokens, Cache Writes, Cache Hits et Output Tokens, un découpage utile pour les équipes qui réutilisent souvent les mêmes règles de marque, modèles de page ou contraintes de validation.
Il serait toutefois réducteur de dire que Claude est simplement le modèle qui écrit le mieux. Le vrai test consiste à l’intégrer dans des tâches d’édition : harmonisation du ton, vérification du respect d’un guide éditorial, restructuration d’un contenu existant, résumé de documents longs, amélioration d’un brouillon sans altérer les faits. La métrique qui compte n’est pas seulement la première impression de lecture ; c’est le temps de retouche humaine, la stabilité du format, le taux d’erreurs et la part de textes réellement publiables.
DeepSeek : intéressant pour produire beaucoup, à bas coût
L’argument principal de DeepSeek est économique. DeepSeek met à disposition une documentation officielle Models & Pricing ; le guide DecodesFuture 2026 décrit de son côté un tarif unifié pour chat et reasoning d’environ 0,28 $ par million de tokens d’entrée et 0,42 $ par million de tokens de sortie, avec une baisse de coût annoncée de 94 à 96 % par rapport à OpenAI o3 ou GPT-4.1.
Dans une équipe contenu, cela place DeepSeek plutôt en amont de la chaîne : premiers brouillons SEO longue traîne, fiches produits, FAQ, variantes de textes publicitaires, premières adaptations multilingues, posts sociaux à retravailler. Le risque est de confondre coût de production et qualité finale. Plus vous générez en volume, plus il faut un processus clair de vérification factuelle, de relecture de marque, de contrôle des formats et de validation avant publication.
Gemini : un candidat solide quand le contexte devient très long
Gemini se distingue surtout par les usages à grand contexte. MorphLLM indique que Gemini 2.5 Flash offre 1 M de tokens de contexte, un prix de 2,50 $ par million de tokens de sortie et un niveau gratuit ; TLDL place Gemini 2.5 Pro parmi les modèles à 2 M de tokens de contexte.
Pour une équipe marketing, c’est utile lorsque le problème n’est pas seulement d’écrire, mais de faire absorber beaucoup de matière au modèle : pages concurrentes, transcriptions d’appels commerciaux, listes de mots-clés, documents produit, entretiens clients, anciens contenus de marque. Beaucoup de productions médiocres viennent d’un manque de contexte plutôt que d’un manque de style. Gemini mérite donc une place dans les tests lorsque vos briefs sont volumineux ou lorsque vous devez croiser plusieurs sources internes.
À garder en tête : les spécifications Gemini citées ici proviennent principalement de comparatifs tiers. Avant de budgéter une mise en production, vérifiez les limites, tarifs et conditions dans la documentation du fournisseur ou de votre plateforme d’accès.
Grok : à tester pour les workflows outillés, pas seulement pour une page de texte
Grok, le modèle de xAI, ne devrait pas être évalué uniquement sur une consigne de rédaction isolée. La documentation officielle de xAI présente ses modèles et prix, et distingue la tarification des server-side tools, c’est-à-dire des outils exécutés côté serveur. C’est particulièrement pertinent si vous envisagez un pipeline où le modèle récupère des données, appelle des outils ou enchaîne automatiquement plusieurs étapes de production.
TLDL indique aussi que xAI propose deux modèles avec une fenêtre de contexte de 2 M de tokens, et mentionne des positionnements différents pour Grok 4 et Grok 4.1 Fast. En revanche, avec les sources disponibles ici, il serait trop fort d’affirmer que Grok surpasse de façon stable OpenAI ou Claude en rédaction marketing généraliste. Le positionnement le plus prudent est donc le suivant : mettez Grok dans la short-list si votre priorité est l’automatisation, la connexion à des outils ou l’orchestration de tâches.
Comment organiser un test équitable
Les prix publics et les fenêtres de contexte servent à réduire la liste des candidats. Ils ne remplacent pas un test sur vos contenus, votre langue, votre ton et vos contraintes de validation. Pour comparer proprement, utilisez le même dossier de marque, les mêmes règles et les mêmes exemples pour chaque modèle.
Un protocole simple peut couvrir cinq cas d’usage :
Brief SEO : donnez un mot-clé, l’intention de recherche, un résumé de concurrents et vos informations produit. Demandez un plan, les angles de section et les points à vérifier.
Réécriture longue : fournissez un brouillon et un guide de ton. Demandez une version réécrite, la conservation stricte des faits et une liste des modifications principales.
Variantes publicitaires : générez plusieurs headlines, textes principaux et CTA. Vérifiez la conformité au ton de marque et aux contraintes de plateforme.
Recyclage de contenu : transformez un article long en posts LinkedIn, X, Threads, newsletter et script court pour vidéo.
Contrôle de l’incertitude : demandez au modèle de signaler les affirmations à vérifier au lieu de compléter avec assurance ce qu’il ne sait pas.
Ne notez pas seulement le texte qui sonne le mieux. Suivez le taux de contenus publiables, le temps de correction humaine, la cohérence de marque, le taux d’erreurs factuelles, la stabilité du format, le coût par tâche et le coût total à grande échelle. Comme les coûts API dépendent séparément des tokens d’entrée et de sortie, estimez séparément les tâches à très grand contexte et les tâches de génération massive.
Le point de départ le plus réaliste
Pour démarrer rapidement, une répartition pragmatique ressemble à ceci : OpenAI comme baseline généraliste, Claude pour les textes longs et l’édition de marque, DeepSeek pour les volumes à coût réduit, Gemini pour les dossiers à très long contexte, Grok pour les pipelines automatisés et les outils serveur.
Ce n’est pas un classement absolu des modèles. C’est une matrice de test. Le meilleur choix dépendra de votre langue, de votre marché, de votre niveau d’exigence éditoriale, de votre processus de relecture et de vos KPI : trafic organique, conversions, vitesse de production, cohérence de marque ou coût par contenu publié.
platform.claude.comPricing - Claude API Docs
pecollective.comCross-Provider LLM API Pricing Comparison (April 2026)
tldl.ioLLM API Pricing 2026 — Compare GPT-5, Claude 4, Gemini 2.5 ...
docs.x.aiModels and Pricing - xAI Docs
aipricingcomparison.comCompare OpenAI & Top LLM API Pricing Instantly - AI Pricing Comparison