Claude Opus 4.7, GPT-5.4, Gemini 3.1 Pro, Grok 4 : le bon choix dépend surtout de la tâche
Pour le code complexe et les workflows d’agents, Claude Opus 4.7 mérite d’être testé en priorité : Anthropic affirme qu’il améliore de 10 à 15 % le taux de réussite sur Factory Droids par rapport à Opus 4.6, avec moin... GPT 5.4 ressort surtout pour le raisonnement structuré et le « computer use » ; Gemini 3.1 Pro p...
Publié parModifié avec GPT-5.5Images générées avec GPT Image 2
Pour le code complexe et les workflows d’agents, Claude Opus 4.7 mérite d’être testé en priorité : Anthropic affirme qu’il améliore de 10 à 15 % le taux de réussite sur Factory Droids par rapport à Opus 4.6, avec moin...
GPT 5.4 ressort surtout pour le raisonnement structuré et le « computer use » ; Gemini 3.1 Pro pour le multimodal, le raisonnement abstrait et les benchmarks scientifiques ; Grok 4 pour certains indicateurs de raisonn...
Avant un achat ou une standardisation en équipe, mieux vaut comparer 3 à 5 modèles sur 5 à 10 tâches réelles : taux de réussite du premier coup, erreurs d’outils, reprises humaines, latence et coût.
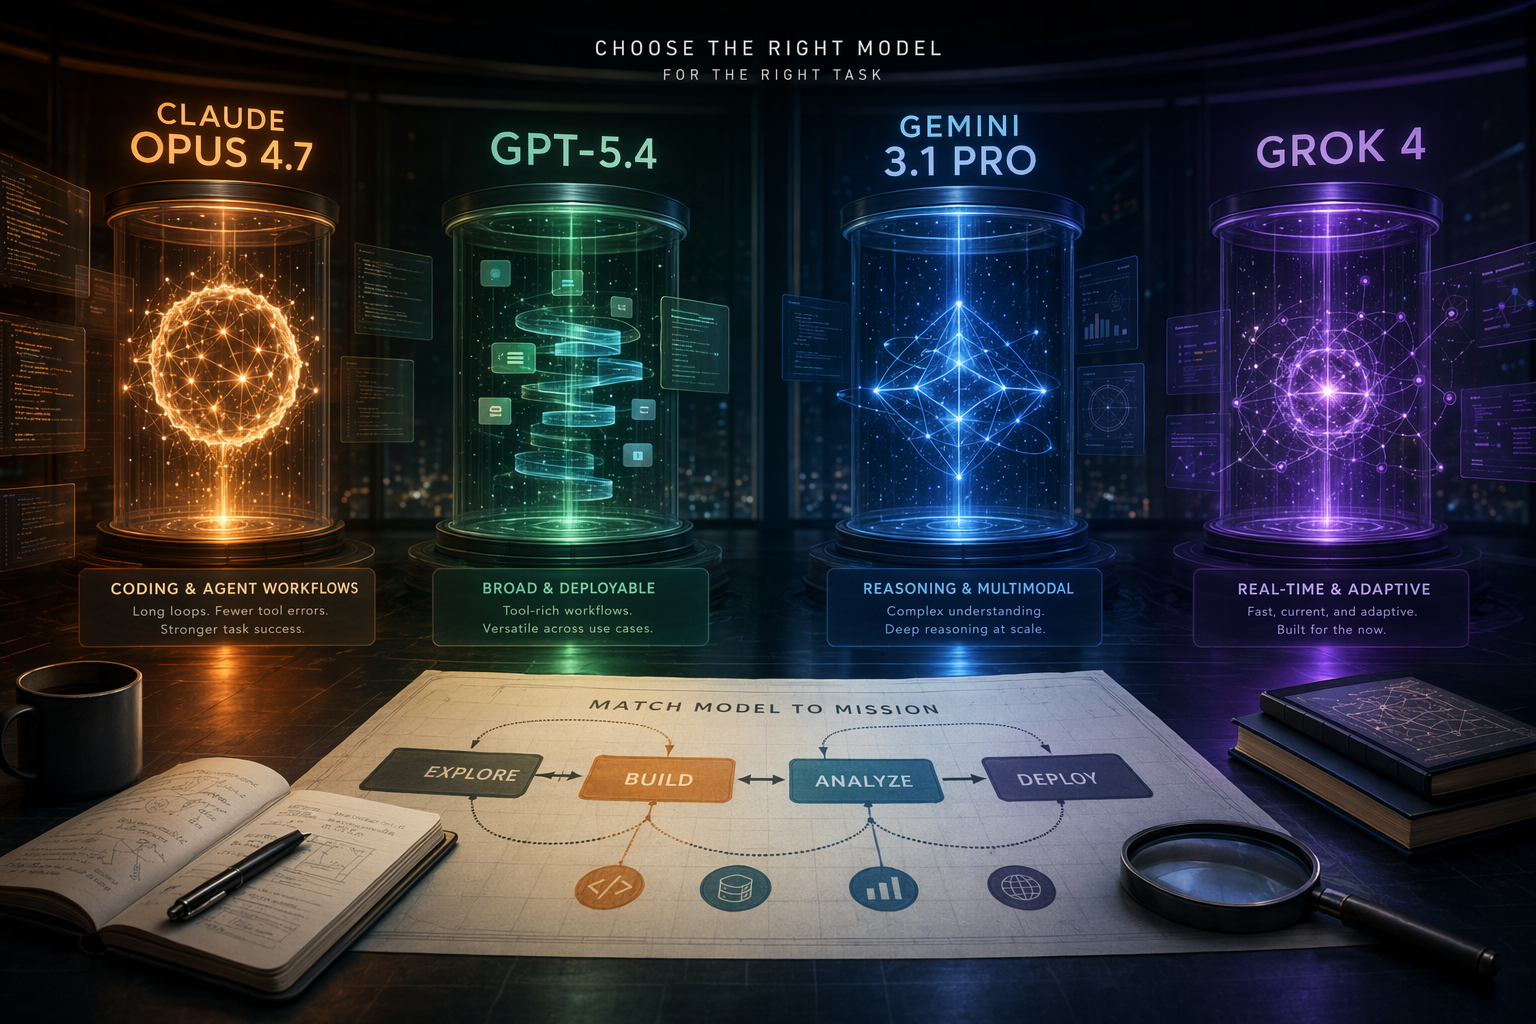
Claude Opus 4.7 vs GPT-5.4、Gemini 3.1 Pro、Grok 4:按任務選模型AI 生成的編輯用示意圖,呈現多個頂尖 AI 模型的任務型比較。
Prompt IA
Create a landscape editorial hero image for this Studio Global article: Claude Opus 4.7 vs GPT-5.4、Gemini 3.1 Pro、Grok 4:按任務選模型. Article summary: Claude Opus 4.7 應先用在 coding 與 agent workflow:Anthropic 稱它相較 Opus 4.6 在 Factory Droids 任務成功率提升 10% 至 15%、工具錯誤更少;但這不是對 GPT 5.4、Gemini 3.1 Pro、Grok 4 的同條件頭對頭證明。[11][5]. Topic tags: ai, llm, claude, chatgpt, gemini. Reference image context from search candidates: Reference image 1: visual subject "Start with Claude Opus 4.7 for premium coding and long agent loops, GPT-5.4 for the broadest deployable tool-rich workflows, and Gemini 3.1" source context "Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 Pro: Which Model Should You Test First? | LaoZhang AI Blog" Reference image 2: visual subject "Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 Pro Benchmarks" source context "Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 — I Tested Them for 48 Hours (Here’s What Actually W
openai.com
La question utile n’est pas : « quel modèle est le meilleur ? » Elle est plutôt : « où mon usage a-t-il le plus de chances de casser ? » Code qui modifie les mauvais fichiers, agent qui appelle mal un outil, analyse d’image imprécise, raisonnement scientifique fragile, coût trop élevé pour itérer… Selon le point de rupture, le bon modèle ne sera pas forcément le même.
Les sources disponibles vont dans ce sens : un guide tiers de sélection de LLM conclut qu’aucun modèle ne domine toutes les tâches. Il attribue des points forts différents à Claude, GPT, Gemini, Grok et à plusieurs nouveaux modèles concurrents.
Anthropic affirme qu’Opus 4.7 améliore de 10 à 15 % le taux de réussite sur Factory Droids par rapport à Opus 4.6, avec moins d’erreurs d’outils ; Axios le décrit aussi comme une mise à niveau du modèle phare, avec de meilleurs résultats en code et en vision.
Studio Global AI
Continuez vos recherches
Cette page comprend une réponse basée sur la source que vous pouvez continuer dans Studio Global.
Quelle est la réponse courte à « Claude Opus 4.7, GPT-5.4, Gemini 3.1 Pro, Grok 4 : le bon choix dépend surtout de la tâche » ?
Pour le code complexe et les workflows d’agents, Claude Opus 4.7 mérite d’être testé en priorité : Anthropic affirme qu’il améliore de 10 à 15 % le taux de réussite sur Factory Droids par rapport à Opus 4.6, avec moin...
Quels sont les points clés à valider en premier ?
Pour le code complexe et les workflows d’agents, Claude Opus 4.7 mérite d’être testé en priorité : Anthropic affirme qu’il améliore de 10 à 15 % le taux de réussite sur Factory Droids par rapport à Opus 4.6, avec moin... GPT 5.4 ressort surtout pour le raisonnement structuré et le « computer use » ; Gemini 3.1 Pro pour le multimodal, le raisonnement abstrait et les benchmarks scientifiques ; Grok 4 pour certains indicateurs de raisonn...
Que dois-je faire ensuite en pratique ?
Avant un achat ou une standardisation en équipe, mieux vaut comparer 3 à 5 modèles sur 5 à 10 tâches réelles : taux de réussite du premier coup, erreurs d’outils, reprises humaines, latence et coût.
Claude Opus 4.7, GPT-5.4, Gemini 3.1 Pro, Grok 4 : le bon choix dépend surtout de la tâche
Pour le code complexe et les workflows d’agents, Claude Opus 4.7 mérite d’être testé en priorité : Anthropic affirme qu’il améliore de 10 à 15 % le taux de réussite sur Factory Droids par rapport à Opus 4.6, avec moin... GPT 5.4 ressort surtout pour le raisonnement structuré et le « computer use » ; Gemini 3.1 Pro p...
Publié parModifié avec GPT-5.5Images générées avec GPT Image 2
Pour le code complexe et les workflows d’agents, Claude Opus 4.7 mérite d’être testé en priorité : Anthropic affirme qu’il améliore de 10 à 15 % le taux de réussite sur Factory Droids par rapport à Opus 4.6, avec moin...
GPT 5.4 ressort surtout pour le raisonnement structuré et le « computer use » ; Gemini 3.1 Pro pour le multimodal, le raisonnement abstrait et les benchmarks scientifiques ; Grok 4 pour certains indicateurs de raisonn...
Avant un achat ou une standardisation en équipe, mieux vaut comparer 3 à 5 modèles sur 5 à 10 tâches réelles : taux de réussite du premier coup, erreurs d’outils, reprises humaines, latence et coût.
Claude Opus 4.7 vs GPT-5.4、Gemini 3.1 Pro、Grok 4:按任務選模型AI 生成的編輯用示意圖,呈現多個頂尖 AI 模型的任務型比較。
Prompt IA
Create a landscape editorial hero image for this Studio Global article: Claude Opus 4.7 vs GPT-5.4、Gemini 3.1 Pro、Grok 4:按任務選模型. Article summary: Claude Opus 4.7 應先用在 coding 與 agent workflow:Anthropic 稱它相較 Opus 4.6 在 Factory Droids 任務成功率提升 10% 至 15%、工具錯誤更少;但這不是對 GPT 5.4、Gemini 3.1 Pro、Grok 4 的同條件頭對頭證明。[11][5]. Topic tags: ai, llm, claude, chatgpt, gemini. Reference image context from search candidates: Reference image 1: visual subject "Start with Claude Opus 4.7 for premium coding and long agent loops, GPT-5.4 for the broadest deployable tool-rich workflows, and Gemini 3.1" source context "Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 Pro: Which Model Should You Test First? | LaoZhang AI Blog" Reference image 2: visual subject "Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 Pro Benchmarks" source context "Claude Opus 4.7 vs GPT-5.4 vs Gemini 3.1 — I Tested Them for 48 Hours (Here’s What Actually W
openai.com
La question utile n’est pas : « quel modèle est le meilleur ? » Elle est plutôt : « où mon usage a-t-il le plus de chances de casser ? » Code qui modifie les mauvais fichiers, agent qui appelle mal un outil, analyse d’image imprécise, raisonnement scientifique fragile, coût trop élevé pour itérer… Selon le point de rupture, le bon modèle ne sera pas forcément le même.
Les sources disponibles vont dans ce sens : un guide tiers de sélection de LLM conclut qu’aucun modèle ne domine toutes les tâches. Il attribue des points forts différents à Claude, GPT, Gemini, Grok et à plusieurs nouveaux modèles concurrents.
Anthropic affirme qu’Opus 4.7 améliore de 10 à 15 % le taux de réussite sur Factory Droids par rapport à Opus 4.6, avec moins d’erreurs d’outils ; Axios le décrit aussi comme une mise à niveau du modèle phare, avec de meilleurs résultats en code et en vision.
Studio Global AI
Continuez vos recherches
Cette page comprend une réponse basée sur la source que vous pouvez continuer dans Studio Global.
Quelle est la réponse courte à « Claude Opus 4.7, GPT-5.4, Gemini 3.1 Pro, Grok 4 : le bon choix dépend surtout de la tâche » ?
Pour le code complexe et les workflows d’agents, Claude Opus 4.7 mérite d’être testé en priorité : Anthropic affirme qu’il améliore de 10 à 15 % le taux de réussite sur Factory Droids par rapport à Opus 4.6, avec moin...
Quels sont les points clés à valider en premier ?
Pour le code complexe et les workflows d’agents, Claude Opus 4.7 mérite d’être testé en priorité : Anthropic affirme qu’il améliore de 10 à 15 % le taux de réussite sur Factory Droids par rapport à Opus 4.6, avec moin... GPT 5.4 ressort surtout pour le raisonnement structuré et le « computer use » ; Gemini 3.1 Pro pour le multimodal, le raisonnement abstrait et les benchmarks scientifiques ; Grok 4 pour certains indicateurs de raisonn...
Que dois-je faire ensuite en pratique ?
Avant un achat ou une standardisation en équipe, mieux vaut comparer 3 à 5 modèles sur 5 à 10 tâches réelles : taux de réussite du premier coup, erreurs d’outils, reprises humaines, latence et coût.
Le même guide place Gemini 3.1 Pro en tête sur le raisonnement abstrait, les entrées multimodales et des benchmarks scientifiques, avec 94,3 % sur GPQA.
Un bon score scientifique ou multimodal ne garantit pas la meilleure performance sur un agent de code long et outillé.
Raisonnement très difficile sur benchmark
Grok 4
Le guide indique que Grok 4 mène sur HLE, avec 50,7 %.
Un score HLE ne suffit pas à conclure à une supériorité générale en entreprise, en code ou en usage d’outils.
Coût, diversification fournisseurs, alternatives ouvertes ou émergentes
MiniMax, GLM, Kimi et autres modèles à surveiller
Le guide estime que MiniMax M2.5/M2.7, GLM-5/5.1 et Kimi K2.5 se rapprochent des modèles propriétaires de pointe sur des tâches de type SWE-bench.
Être proche sur SWE-bench ne dit pas tout sur la stabilité API, le multimodal, la sécurité, l’écriture ou l’intégration produit.
Claude Opus 4.7 : l’argument principal est la fiabilité en code et en agent
Le signal le plus concret autour de Claude Opus 4.7 vient d’Anthropic lui-même. La page officielle indique qu’Opus 4.7 dépasse Opus 4.6 avec une hausse de 10 à 15 % du taux de réussite sur Factory Droids, moins d’erreurs d’outils et un comportement plus fiable.
C’est précisément le genre de métrique qui intéresse les équipes techniques. Dans un workflow d’agent, l’échec ne ressemble pas toujours à une mauvaise réponse finale. Il peut venir d’un appel d’outil raté, d’un mauvais fichier modifié, d’une mauvaise interprétation du contexte ou d’un besoin de correction humaine à chaque étape. Axios présente également Opus 4.7 comme une mise à niveau significative du modèle phare d’Anthropic, avec des progrès en code et en vision.
La lecture prudente reste toutefois la suivante : les éléments disponibles soutiennent clairement l’idée qu’Opus 4.7 progresse par rapport à Opus 4.6. Ils ne suffisent pas, à eux seuls, à affirmer qu’il bat systématiquement GPT-5.4, Gemini 3.1 Pro ou Grok 4 dans les mêmes conditions.
GPT-5.4 : à privilégier si votre problème est le respect d’un processus
Si votre cas d’usage ressemble à un enchaînement de règles strictes, d’opérations sur interface, de tableaux, d’outils ou de décisions étape par étape, GPT-5.4 doit faire partie du premier lot de tests. Le guide tiers le présente comme performant en raisonnement structuré et en « computer use », avec 75 % sur OSWorld.
Cela ne signifie pas que GPT-5.4 sera meilleur partout. Cela veut dire que, si vos échecs les plus coûteux viennent d’un mauvais suivi de procédure, d’une étape oubliée ou d’une action mal exécutée, il serait imprudent de ne tester que Claude Opus 4.7.
Gemini 3.1 Pro : le candidat naturel pour le multimodal et les contenus scientifiques
Quand les données ne sont pas seulement du texte — images, graphiques, captures d’écran, documents visuels, questions scientifiques — Gemini 3.1 Pro mérite une place élevée dans la short list. Le guide tiers le cite pour le raisonnement abstrait, les entrées multimodales et les benchmarks scientifiques, avec 94,3 % sur GPQA.
Le point important est le type de tâche. Si votre produit doit comprendre des visuels, croiser du texte avec des schémas ou aider à traiter des contenus de recherche, choisir uniquement sur la base de benchmarks de code risque de passer à côté de la force principale de Gemini 3.1 Pro.
Grok 4 : intéressant pour le raisonnement difficile, mais attention à l’extrapolation
Grok 4 ressort dans les sources disponibles pour certains benchmarks de raisonnement exigeant. Le guide tiers indique qu’il mène sur HLE, avec 50,7 %.
Mais un benchmark de raisonnement très difficile ne se transforme pas automatiquement en avantage global. Il ne dit pas, à lui seul, comment le modèle se comporte dans un workflow métier, un outil de développement, une interface produit ou une chaîne d’agents. Un autre article de classement de modèles rappelle d’ailleurs que les benchmarks sont utiles, mais que l’expérience quotidienne dépend aussi de la fiabilité, des capacités d’interface et du coût.
Pourquoi les classements ne suffisent pas
D’abord, les tableaux agrègent souvent des sources et des dates différentes. Le comparatif de modèles de code de Failing Fast indique par exemple des données issues de SWE-bench, Aider et Arena Code, avec des dates qui ne coïncident pas toutes : SWE-bench en février 2026, Aider en octobre 2025, Arena Code en février 2026. C’est utile pour se repérer, mais ce n’est pas nécessairement un duel synchronisé, le même jour, dans les mêmes conditions.
Ensuite, une comparaison officielle interne et un guide tiers ne prouvent pas la même chose. Les informations d’Anthropic sur Opus 4.7 documentent surtout une amélioration par rapport à Opus 4.6. Un guide tiers peut donner une vue transversale entre fournisseurs, mais il ne remplace pas une évaluation officielle commune d’OpenAI, Google, xAI et Anthropic.
Enfin, le meilleur score ne donne pas toujours le meilleur usage. En production, une équipe regarde aussi la stabilité, les coûts d’itération, l’intégration avec ses outils, la latence, la facilité de contrôle et les erreurs rares mais graves. C’est exactement la réserve formulée par l’article de classement : les benchmarks aident, mais l’expérience de construction au quotidien est fortement influencée par la fiabilité, l’interface et le coût.
Une méthode simple avant de choisir
Pour un achat, un déploiement ou une standardisation d’équipe, évitez de trancher sur un seul classement. Une méthode plus robuste consiste à comparer les modèles sur vos propres tâches :
Sélectionnez 5 à 10 tâches réellement exécutées chaque semaine : corriger un bug, ajouter une fonctionnalité, refactorer du code, lire un long document, analyser une capture d’écran, produire une spécification ou appeler un outil interne.
Donnez à tous les modèles le même prompt, les mêmes fichiers, le même contexte et les mêmes critères de réussite.
Mesurez le taux de réussite du premier coup, le nombre de reprises, les erreurs d’outils, les hallucinations, la latence, le coût et le temps de correction humaine.
Regardez les pires réponses autant que les meilleures. En production, les modes d’échec comptent souvent plus que les démonstrations impressionnantes.
Si des données sensibles sont concernées, vérifiez séparément la conservation des données, les options de déploiement et les contrôles d’entreprise.
Verdict pratique
Claude Opus 4.7 est un excellent candidat de premier tour pour le code, les workflows d’agents et les tâches où la fiabilité des outils compte beaucoup. Les éléments officiels d’Anthropic indiquent une amélioration nette par rapport à Opus 4.6 sur Factory Droids, et Axios décrit aussi une mise à niveau axée notamment sur le code et la vision.
Mais si la question est « quel modèle est le numéro un absolu ? », les preuves disponibles ne permettent pas de répondre proprement. Le constat le plus solide reste plus pragmatique : aucun modèle ne domine toutes les tâches ; GPT-5.4, Gemini 3.1 Pro, Grok 4 et plusieurs nouveaux entrants ont chacun des points forts identifiables.
Le meilleur choix consiste donc à partir de votre risque principal. Pour le code et les agents, testez Claude Opus 4.7 en priorité. Pour les processus structurés, ajoutez GPT-5.4. Pour le multimodal et les questions scientifiques, incluez Gemini 3.1 Pro. Pour le raisonnement très difficile, regardez Grok 4. Puis laissez vos propres tâches départager les modèles.
Le même guide place Gemini 3.1 Pro en tête sur le raisonnement abstrait, les entrées multimodales et des benchmarks scientifiques, avec 94,3 % sur GPQA.
Un bon score scientifique ou multimodal ne garantit pas la meilleure performance sur un agent de code long et outillé.
Raisonnement très difficile sur benchmark
Grok 4
Le guide indique que Grok 4 mène sur HLE, avec 50,7 %.
Un score HLE ne suffit pas à conclure à une supériorité générale en entreprise, en code ou en usage d’outils.
Coût, diversification fournisseurs, alternatives ouvertes ou émergentes
MiniMax, GLM, Kimi et autres modèles à surveiller
Le guide estime que MiniMax M2.5/M2.7, GLM-5/5.1 et Kimi K2.5 se rapprochent des modèles propriétaires de pointe sur des tâches de type SWE-bench.
Être proche sur SWE-bench ne dit pas tout sur la stabilité API, le multimodal, la sécurité, l’écriture ou l’intégration produit.
Claude Opus 4.7 : l’argument principal est la fiabilité en code et en agent
Le signal le plus concret autour de Claude Opus 4.7 vient d’Anthropic lui-même. La page officielle indique qu’Opus 4.7 dépasse Opus 4.6 avec une hausse de 10 à 15 % du taux de réussite sur Factory Droids, moins d’erreurs d’outils et un comportement plus fiable.
C’est précisément le genre de métrique qui intéresse les équipes techniques. Dans un workflow d’agent, l’échec ne ressemble pas toujours à une mauvaise réponse finale. Il peut venir d’un appel d’outil raté, d’un mauvais fichier modifié, d’une mauvaise interprétation du contexte ou d’un besoin de correction humaine à chaque étape. Axios présente également Opus 4.7 comme une mise à niveau significative du modèle phare d’Anthropic, avec des progrès en code et en vision.
La lecture prudente reste toutefois la suivante : les éléments disponibles soutiennent clairement l’idée qu’Opus 4.7 progresse par rapport à Opus 4.6. Ils ne suffisent pas, à eux seuls, à affirmer qu’il bat systématiquement GPT-5.4, Gemini 3.1 Pro ou Grok 4 dans les mêmes conditions.
GPT-5.4 : à privilégier si votre problème est le respect d’un processus
Si votre cas d’usage ressemble à un enchaînement de règles strictes, d’opérations sur interface, de tableaux, d’outils ou de décisions étape par étape, GPT-5.4 doit faire partie du premier lot de tests. Le guide tiers le présente comme performant en raisonnement structuré et en « computer use », avec 75 % sur OSWorld.
Cela ne signifie pas que GPT-5.4 sera meilleur partout. Cela veut dire que, si vos échecs les plus coûteux viennent d’un mauvais suivi de procédure, d’une étape oubliée ou d’une action mal exécutée, il serait imprudent de ne tester que Claude Opus 4.7.
Gemini 3.1 Pro : le candidat naturel pour le multimodal et les contenus scientifiques
Quand les données ne sont pas seulement du texte — images, graphiques, captures d’écran, documents visuels, questions scientifiques — Gemini 3.1 Pro mérite une place élevée dans la short list. Le guide tiers le cite pour le raisonnement abstrait, les entrées multimodales et les benchmarks scientifiques, avec 94,3 % sur GPQA.
Le point important est le type de tâche. Si votre produit doit comprendre des visuels, croiser du texte avec des schémas ou aider à traiter des contenus de recherche, choisir uniquement sur la base de benchmarks de code risque de passer à côté de la force principale de Gemini 3.1 Pro.
Grok 4 : intéressant pour le raisonnement difficile, mais attention à l’extrapolation
Grok 4 ressort dans les sources disponibles pour certains benchmarks de raisonnement exigeant. Le guide tiers indique qu’il mène sur HLE, avec 50,7 %.
Mais un benchmark de raisonnement très difficile ne se transforme pas automatiquement en avantage global. Il ne dit pas, à lui seul, comment le modèle se comporte dans un workflow métier, un outil de développement, une interface produit ou une chaîne d’agents. Un autre article de classement de modèles rappelle d’ailleurs que les benchmarks sont utiles, mais que l’expérience quotidienne dépend aussi de la fiabilité, des capacités d’interface et du coût.
Pourquoi les classements ne suffisent pas
D’abord, les tableaux agrègent souvent des sources et des dates différentes. Le comparatif de modèles de code de Failing Fast indique par exemple des données issues de SWE-bench, Aider et Arena Code, avec des dates qui ne coïncident pas toutes : SWE-bench en février 2026, Aider en octobre 2025, Arena Code en février 2026. C’est utile pour se repérer, mais ce n’est pas nécessairement un duel synchronisé, le même jour, dans les mêmes conditions.
Ensuite, une comparaison officielle interne et un guide tiers ne prouvent pas la même chose. Les informations d’Anthropic sur Opus 4.7 documentent surtout une amélioration par rapport à Opus 4.6. Un guide tiers peut donner une vue transversale entre fournisseurs, mais il ne remplace pas une évaluation officielle commune d’OpenAI, Google, xAI et Anthropic.
Enfin, le meilleur score ne donne pas toujours le meilleur usage. En production, une équipe regarde aussi la stabilité, les coûts d’itération, l’intégration avec ses outils, la latence, la facilité de contrôle et les erreurs rares mais graves. C’est exactement la réserve formulée par l’article de classement : les benchmarks aident, mais l’expérience de construction au quotidien est fortement influencée par la fiabilité, l’interface et le coût.
Une méthode simple avant de choisir
Pour un achat, un déploiement ou une standardisation d’équipe, évitez de trancher sur un seul classement. Une méthode plus robuste consiste à comparer les modèles sur vos propres tâches :
Sélectionnez 5 à 10 tâches réellement exécutées chaque semaine : corriger un bug, ajouter une fonctionnalité, refactorer du code, lire un long document, analyser une capture d’écran, produire une spécification ou appeler un outil interne.
Donnez à tous les modèles le même prompt, les mêmes fichiers, le même contexte et les mêmes critères de réussite.
Mesurez le taux de réussite du premier coup, le nombre de reprises, les erreurs d’outils, les hallucinations, la latence, le coût et le temps de correction humaine.
Regardez les pires réponses autant que les meilleures. En production, les modes d’échec comptent souvent plus que les démonstrations impressionnantes.
Si des données sensibles sont concernées, vérifiez séparément la conservation des données, les options de déploiement et les contrôles d’entreprise.
Verdict pratique
Claude Opus 4.7 est un excellent candidat de premier tour pour le code, les workflows d’agents et les tâches où la fiabilité des outils compte beaucoup. Les éléments officiels d’Anthropic indiquent une amélioration nette par rapport à Opus 4.6 sur Factory Droids, et Axios décrit aussi une mise à niveau axée notamment sur le code et la vision.
Mais si la question est « quel modèle est le numéro un absolu ? », les preuves disponibles ne permettent pas de répondre proprement. Le constat le plus solide reste plus pragmatique : aucun modèle ne domine toutes les tâches ; GPT-5.4, Gemini 3.1 Pro, Grok 4 et plusieurs nouveaux entrants ont chacun des points forts identifiables.
Le meilleur choix consiste donc à partir de votre risque principal. Pour le code et les agents, testez Claude Opus 4.7 en priorité. Pour les processus structurés, ajoutez GPT-5.4. Pour le multimodal et les questions scientifiques, incluez Gemini 3.1 Pro. Pour le raisonnement très difficile, regardez Grok 4. Puis laissez vos propres tâches départager les modèles.
iternal.aiThe Definitive LLM Selection & Benchmarks Guide
anthropic.comClaude Opus 4.7 - Anthropic
axios.comAnthropic releases Claude Opus 4.7, concedes it trails ... - Axios
adam.holter.comAI Labs LLM Rankings 2026: Claude vs GPT-5 vs Gemini 3 vs Grok
failingfast.ioAI coding model comparison - Failing Fast