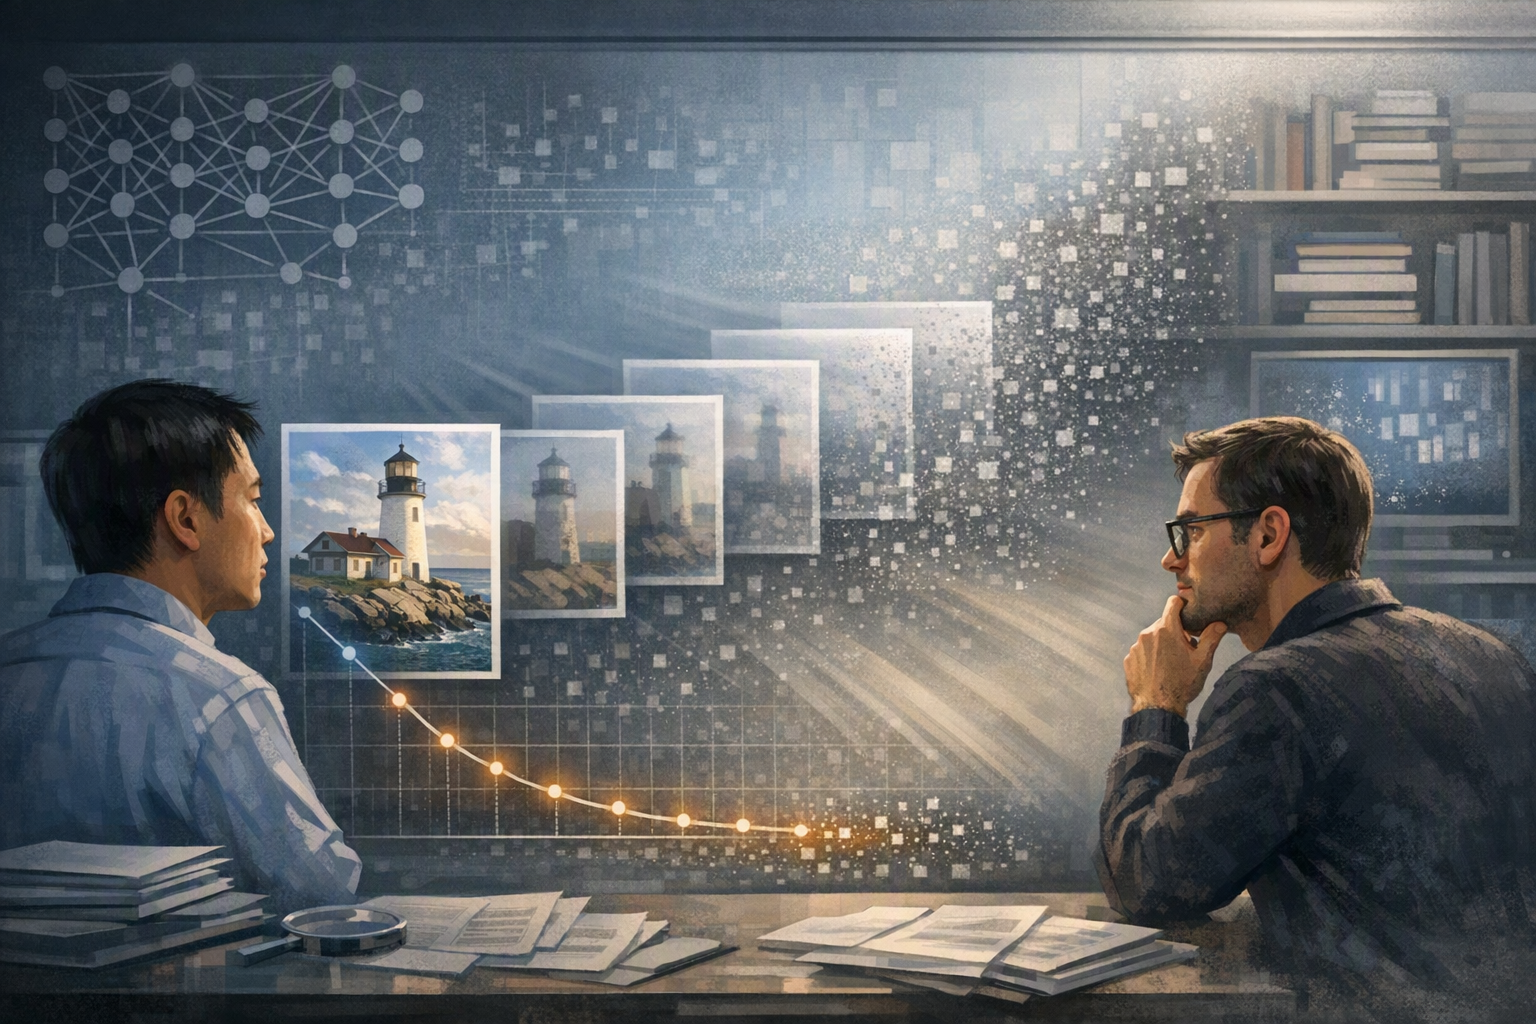
Le phénomène d’« attribution decay » brouille la piste des images utilisées pour entraîner l’IA
Dans une étude menée sur 24 ensembles de modèles de diffusion et sept collections publiques, avec des jeux de données allant de 256 à plus de 160 000 images, Zheng Dai et David Gifford ont observé que l’influence caus... Les chercheurs ont conçu une architecture en ensemble de modèles (« diffusion ensemble ») permet...
Publié parModifié avec GPT-5.6 LunaImages générées avec GPT Image 1.5
Dans une étude menée sur 24 ensembles de modèles de diffusion et sept collections publiques, avec des jeux de données allant de 256 à plus de 160 000 images, Zheng Dai et David Gifford ont observé que l’influence caus...
Les chercheurs ont conçu une architecture en ensemble de modèles (« diffusion ensemble ») permettant de retirer l’influence d’images choisies sans réentraîner un modèle complet, puis de comparer le résultat obtenu ave...
À grande échelle, supprimer toutes les images d’un artiste — ou toutes les photographies représentant une personne donnée — pouvait également laisser le résultat généré pratiquement inchangé dans le cadre du test.
What did Zheng Dai and David Gifford’s MIT CSAIL study, published in Nature Communications, discover about “attribution decay” in diffusion-Attribution decay describes how a diffusion model’s output becomes harder to link to any single training image as the dataset grows.
Prompt IA
Create a landscape editorial hero image for this Studio Global article: What did Zheng Dai and David Gifford’s MIT CSAIL study, published in Nature Communications, discover about “attribution decay” in diffusion-. Article summary: Dai and Gifford found “attribution decay”: as a diffusion image generator is trained on more data, the causal effect of any one training item on a particular generated image can shrink until it is too small to detect. Th. Topic tags: general, education, general web, user generated, government. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, wat
openai.com
Une étude menée par le laboratoire d’informatique et d’intelligence artificielle du MIT (CSAIL) met en lumière un problème pour quiconque cherche à relier une image générée par IA à une source précise : l’« attribution decay », ou déclin de l’attribution. Plus un modèle de diffusion est entraîné sur un grand nombre d’images, plus l’influence causale mesurable d’un exemple d’entraînement donné sur un résultat particulier peut devenir faible, au point que sa suppression ne produise presque aucune différence apparente.
Ce résultat ne signifie pas que le modèle n’a jamais rencontré l’image, qu’il est incapable de la reproduire ou qu’il ne présente aucun risque au regard du droit d’auteur. Il décrit un phénomène technique plus précis : dans un test contrôlé consistant à retirer l’influence d’une donnée, un exemple particulier peut ne plus être nécessaire à la production d’un résultat donné.
Une expérience fondée sur des scénarios contrefactuels
Les méthodes classiques d’analyse d’influence cherchent généralement à estimer l’effet d’un exemple d’entraînement sur le comportement d’un modèle. Zheng Dai et David Gifford ont choisi une autre approche en concevant un ensemble de modèles de diffusion. Celui-ci réunit plusieurs composants entraînés indépendamment, chacun ayant accès à une portion soigneusement organisée des données d’entraînement.
Studio Global AI
Continuez vos recherches
Cette page comprend une réponse basée sur la source que vous pouvez continuer dans Studio Global.
Quelle est la réponse courte à « Le phénomène d’« attribution decay » brouille la piste des images utilisées pour entraîner l’IA » ?
Dans une étude menée sur 24 ensembles de modèles de diffusion et sept collections publiques, avec des jeux de données allant de 256 à plus de 160 000 images, Zheng Dai et David Gifford ont observé que l’influence caus...
Quels sont les points clés à valider en premier ?
Dans une étude menée sur 24 ensembles de modèles de diffusion et sept collections publiques, avec des jeux de données allant de 256 à plus de 160 000 images, Zheng Dai et David Gifford ont observé que l’influence caus... Les chercheurs ont conçu une architecture en ensemble de modèles (« diffusion ensemble ») permettant de retirer l’influence d’images choisies sans réentraîner un modèle complet, puis de comparer le résultat obtenu ave...
Que dois-je faire ensuite en pratique ?
À grande échelle, supprimer toutes les images d’un artiste — ou toutes les photographies représentant une personne donnée — pouvait également laisser le résultat généré pratiquement inchangé dans le cadre du test.
Cette architecture permet de poser une question très concrète : qu’aurait produit le modèle si cette image n’avait pas influencé son entraînement ? Au lieu de réentraîner entièrement un modèle de grande taille, les chercheurs peuvent désactiver les composants qui ont vu l’image sélectionnée, puis générer un résultat de comparaison. Il s’agit d’une ablation de l’influence de l’image, et non d’une simple estimation approximative.
L’équipe a étudié 24 ensembles de modèles de diffusion à partir de sept collections publiques d’images. Les jeux de données comprenaient entre 256 images et plus de 160 000 images, ce qui a permis d’observer l’évolution de l’attribution lorsque le volume de données augmente. Les chercheurs ont comparé une génération originale à des versions contrefactuelles produites après l’omission de différentes unités d’entraînement.
La plus grande différence mesurée entre le résultat original et ces versions contrefactuelles a été appelée « counterfactual radius », ou rayon contrefactuel. Cette mesure sert à évaluer l’ampleur du changement qu’une unité d’entraînement supprimée peut provoquer dans le résultat.
Que signifie exactement le déclin de l’attribution ?
Le rayon contrefactuel diminuait à mesure que les jeux de données s’agrandissaient. En pratique, supprimer une seule image produisait de plus en plus souvent un résultat difficile à distinguer de l’original selon la mesure utilisée par l’étude.
L’idée est contre-intuitive : ajouter davantage de données peut rendre une image générée moins attribuable à un exemple unique, même si cet exemple faisait bien partie des données d’entraînement. Le modèle apprend alors des motifs généraux et largement recouvrants à partir de nombreuses sources, plutôt que de dépendre d’une image identifiable pour produire un résultat particulier.
À une échelle suffisamment importante, le phénomène ne concernait plus seulement des images isolées. Selon l’étude, retirer toutes les images d’un artiste donné, ou toutes les photographies représentant une personne précise, pouvait également laisser un échantillon généré pratiquement inchangé dans le cadre du test contrefactuel.
Les chercheurs parlent donc de « déclin » plutôt que d’un simple échec des outils de traçage. Le problème ne vient pas nécessairement d’un manque de puissance des méthodes d’analyse : le lien causal entre une source et un résultat peut lui-même devenir trop diffus pour être isolé.
Des conséquences possibles pour les litiges sur le droit d’auteur
L’attribution decay pourrait compliquer une théorie précise dans certains contentieux : celle selon laquelle une image contestée aurait été directement causée par les œuvres d’un artiste identifié, ou par des copies de ces œuvres présentes dans les données d’entraînement. Si la suppression de l’ensemble du corpus d’un artiste ne modifie pas sensiblement le résultat, il devient plus difficile de soutenir que ce corpus était individuellement nécessaire à la production de cette image selon ce test causal.
Cela pourrait peser dans les affaires opposant des artistes aux entreprises de génération d’images et dans les accusations selon lesquelles les modèles reproduiraient le style de créateurs. L’entraînement à très grande échelle fragilise en effet un récit simple dans lequel un résultat reconnaissable serait directement issu d’une œuvre ou d’un artiste précis. L’étude pourrait ainsi compliquer certains dossiers de propriété intellectuelle liés aux systèmes d’image générative.
Mais la recherche ne détermine pas si une entreprise a enfreint le droit d’auteur et ne constitue pas, à elle seule, une défense juridique. Un litige peut soulever plusieurs questions : des œuvres protégées ont-elles été copiées pendant l’entraînement ? Le résultat est-il substantiellement similaire à une œuvre protégée ? Le système peut-il la reproduire dans certaines conditions ? Quel préjudice ou quelles obligations contractuelles sont en jeu ?
Le sens technique de « non attribuable » ne doit donc pas être confondu avec le sens juridique de « non copié ».
Pourquoi l’étude ne prouve pas l’absence de mémorisation
L’expérience mesure la sensibilité du modèle au retrait d’unités d’entraînement. Elle ne teste pas toutes les formes possibles de conservation ou de reproduction d’une information.
Un modèle peut dépendre faiblement d’une image individuelle dans le test de suppression utilisé par l’ensemble de modèles, tout en étant capable de reproduire une œuvre dans certaines conditions de requête ou d’échantillonnage. Un résultat peut aussi ressembler à une œuvre protégée sans qu’une image unique soit identifiée comme causalement indispensable à sa production.
Il faut distinguer trois affirmations :
« Cette image a influencé ce résultat » : le test de suppression met en évidence une modification mesurable lorsque l’influence de l’image est retirée.
« Le modèle a vu ou conservé cette image » : le modèle y a été exposé et peut en avoir mémorisé certains aspects.
« Le résultat copie une œuvre protégée » : il s’agit d’une conclusion juridique et technique qui exige d’autres éléments de preuve.
L’attribution decay concerne directement la première question. Il ne tranche ni la deuxième ni la troisième.
Un résultat qui ne s’applique pas encore aux grands modèles de langage
L’étude porte sur des modèles génératifs fondés sur la diffusion, utilisés pour les images et des contenus audiovisuels apparentés. Son architecture en ensemble et la tendance observée lorsque les données augmentent ne peuvent pas être automatiquement extrapolées aux grands modèles de langage — les LLM — fondés sur des transformeurs.
Les modèles de langage ont une architecture, des procédures d’entraînement, des représentations en tokens et un comportement de sortie différents. L’étude peut ouvrir une piste expérimentale pour de futurs travaux sur l’attribution, mais elle ne démontre pas qu’un phénomène identique existe dans les LLM.
Les éléments qu’il faudra encore examiner
Lorsqu’il s’agit de déterminer si un système d’IA a copié une œuvre, l’attribution decay ne constitue qu’un élément parmi d’autres. Les tribunaux et les experts techniques devront toujours pouvoir examiner notamment :
la capacité du système à reproduire une œuvre précise à partir de requêtes contrôlées ;
la similarité visuelle entre le résultat et l’œuvre prétendument copiée ;
la provenance des données, les conditions d’accès et les documents relatifs à l’entraînement ;
les audits du modèle et la documentation du système ;
la question de savoir si le résultat renvoie à un style général ou à une expression protégée identifiable ;
les règles juridiques applicables au litige concerné.
La leçon centrale de l’étude est donc plus nuancée — et plus utile — que l’idée selon laquelle l’IA « oublierait » ses sources. À mesure que les jeux de données de diffusion grandissent, la contribution causale de chaque exemple individuel peut devenir trop diffuse pour être détectée dans un résultat particulier. Cela rend l’attribution des sources plus difficile, sans rendre impossibles l’analyse de la mémorisation, de la reproduction ou d’une éventuelle atteinte au droit d’auteur.
semafor.comGenerative AI outputs are unattributable, study finds - Semafor