RéponsesPublié22 sources
Kirin 9050 Pro : comment fonctionne la technologie LogicFolding de Huawei
Les démontages montrent deux dies d’environ 120,65 mm² chacun, assemblés face à face : l’un concentre le calcul, l’autre la SRAM et le cache. Huawei annonce une baisse de consommation de 41 % pour le CPU, 58 % pour le GPU et 66 % pour le NPU à performances comparables.
Publié parModifié avec GPT-6 LunaImages générées avec GPT Image 2
Réponse de recherche
Points clés à retenir
- Les démontages montrent deux dies d’environ 120,65 mm² chacun, assemblés face à face : l’un concentre le calcul, l’autre la SRAM et le cache.
- Huawei annonce une baisse de consommation de 41 % pour le CPU, 58 % pour le GPU et 66 % pour le NPU à performances comparables.
Prompt IA
openai.comCreate a landscape editorial hero image for this Studio Global article: What did teardowns by Geekerwan and Kurnal Insights reveal about the Kirin 9050 Pro’s two-die “LogicFolding” design—including its hybrid bon. Article summary: The teardowns depict LogicFolding as a way to gain chip-level density and efficiency by stacking two dies, rather than relying solely on smaller transistors. That is a meaningful response to restricted access to advanced. Topic tags: general, general web, user generated. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts with fa
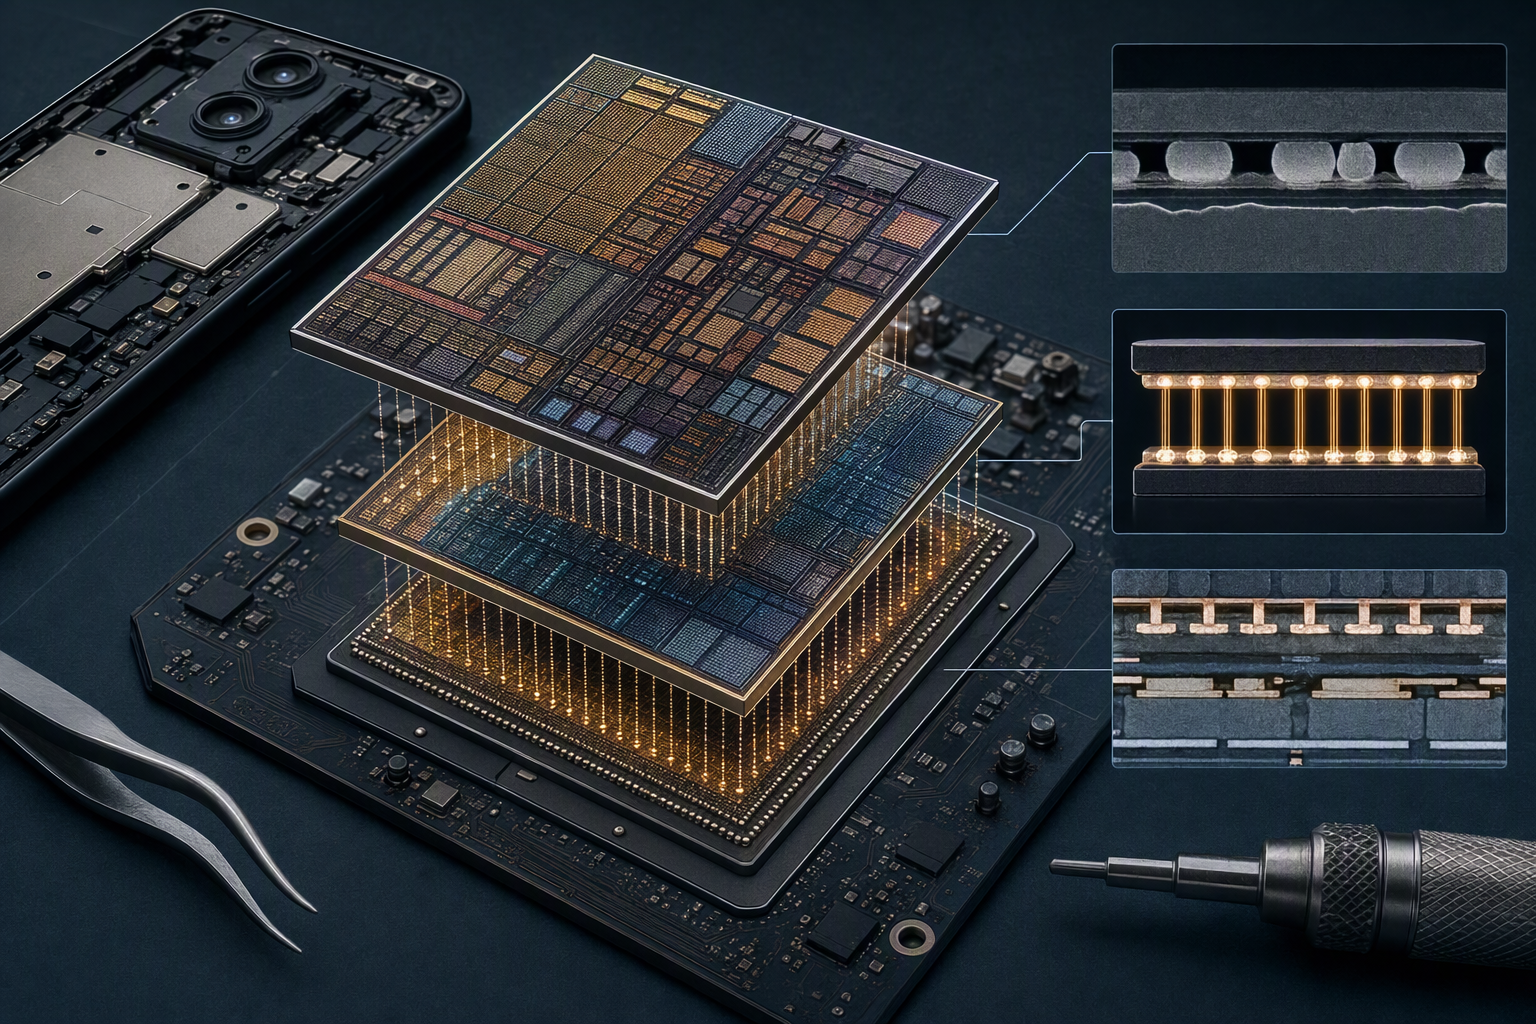
Le Kirin 9050 Pro ne mise pas uniquement sur des transistors plus petits : il superpose deux couches de silicium actives. Les images de puce attribuées à Kurnal Insights et le démontage de Geekerwan montrent une couche consacrée principalement au calcul et une autre au cache et à la mémoire SRAM. Cette architecture, baptisée LogicFolding, peut augmenter la densité effective du circuit et raccourcir certaines connexions. En revanche, les chiffres disponibles ne démontrent pas que le processeur repose sur une gravure parmi les plus avancées.3
11
13
Deux couches, deux rôles
Les deux dies — les morceaux de silicium qui composent la puce — semblent avoir des dimensions similaires : environ 11,13 × 10,84 mm, soit 120,65 mm² chacun. L’un est centré sur les unités de calcul ; l’autre accueille la SRAM et le cache, ainsi que des fonctions comme les entrées-sorties et l’horloge.11
13
15
Ils sont assemblés face à face par une liaison hybride cuivre-cuivre. Le pas de connexion rapporté est d’environ 1,5 micromètre, ce qui permet de multiplier les liaisons verticales rapprochées entre les couches.1
3
15
Les sources mentionnent aussi environ 50 millions d’interconnexions verticales et quelque 80 000 TSV (vias traversant le silicium, utilisés pour acheminer alimentation et signaux). Il s’agit de catégories différentes : ces nombres ne doivent ni être additionnés ni être considérés comme équivalents. Les descriptions disponibles divergent également sur le trajet des TSV. Il vaut donc mieux comprendre ces chiffres comme des décomptes rapportés séparément, et non comme une cartographie complète et vérifiée de toutes les connexions.1
3
5
15
Densité annoncée et procédés de fabrication estimés
Les articles consacrés au démontage estiment que le die de calcul est fabriqué avec le procédé N+3 de SMIC, et celui orienté vers la SRAM avec le procédé N+2. Ce sont des déductions rapportées, pas une confirmation définitive du procédé utilisé pour chacune des couches.11
15
Huawei annonce une densité effective d’environ 238 millions de transistors par millimètre carré, contre quelque 155 millions pour la référence de comparaison retenue par l’entreprise, soit une hausse d’environ 54 %. Ce chiffre décrit le gain de densité attribué à l’empilement ; il ne signifie pas que chaque die a gagné autant en densité grâce à une gravure plus fine.1
2
11
Baisse de consommation : des chiffres annoncés par Huawei
À performances comparables, Huawei affirme que la consommation baisse de 41 % pour le CPU, 58 % pour le GPU et 66 % pour le NPU. Ce sont des chiffres de l’entreprise, et non des mesures établies par le démontage. Lors du lancement, des médias ont également relevé qu’ils n’avaient pas fait l’objet d’une vérification indépendante.1
2
48
Les résultats de benchmark appellent eux aussi à la prudence. Selon des informations attribuées au cabinet Bernstein, le Kirin 9050 Pro devancerait l’A17 Pro d’Apple sur certains tests multicœurs de Geekbench 6, tout en restant derrière l’A20 Pro plus récent dans la comparaison rapportée. Cela indique des progrès sur certaines tâches, pas une victoire générale sur les puces concurrentes ou sur l’ensemble des tests.49
Le processeur serait intégré aux modèles haut de gamme de la série Mate 90 : LogicFolding est donc présenté comme une architecture commercialisée, et pas seulement comme un concept.6
Un levier utile, mais pas une équivalence avec les puces de pointe
L’empilement offre à Huawei un moyen d’augmenter la densité effective sans dépendre uniquement de la miniaturisation classique des procédés. Répartir calcul et mémoire sur deux couches permet aussi d’utiliser des procédés différents selon les fonctions et de rapprocher certaines voies de données.7
11
Cette conception rend toutefois l’intégration plus complexe : il faut fabriquer deux dies actifs, puis les aligner et les assembler avec une liaison très fine. Les informations disponibles ne permettent pas de conclure sur les rendements de fabrication, les coûts ou le comportement thermique du produit. Et empiler des couches ne transforme pas un transistor produit avec un procédé plus ancien en transistor de dernière génération.
Dans le contexte des contrôles américains à l’exportation, LogicFolding se comprend surtout comme une manière de contourner certaines contraintes de miniaturisation — pas comme la preuve d’une parité avec les procédés de pointe ni d’une chaîne d’approvisionnement entièrement indépendante. Les informations publiées sur la puce indiquent que cette chaîne reste non divulguée.1
9
Studio Global AI
Continuez vos recherches
Cette page comprend une réponse basée sur la source que vous pouvez continuer dans Studio Global.
Les gens demandent aussi
Quelle est la réponse courte à « Kirin 9050 Pro : comment fonctionne la technologie LogicFolding de Huawei » ?
Les démontages montrent deux dies d’environ 120,65 mm² chacun, assemblés face à face : l’un concentre le calcul, l’autre la SRAM et le cache.
Quels sont les points clés à valider en premier ?
Les démontages montrent deux dies d’environ 120,65 mm² chacun, assemblés face à face : l’un concentre le calcul, l’autre la SRAM et le cache. Huawei annonce une baisse de consommation de 41 % pour le CPU, 58 % pour le GPU et 66 % pour le NPU à performances comparables.
Sources
vocal.mediaHuawei’s New Chip Shouldn’t Be This Efficient. The Teardown Explains Why It Is.
wccftech.comDie Shots For Huawei's Latest Kirin 9050 Pro Chip Show A Much Smaller Footprint, Encompassing A Logic Die On SMIC's N+3 Process Bonded To An SRAM Die On The N+2 Process
huaweicentral.comHuawei Kirin 9050 Pro chip's core design spotted in microscopic image