RéponsesPublié26 sources
Samsung zHBM : la mémoire HBM directement au-dessus des accélérateurs d’IA
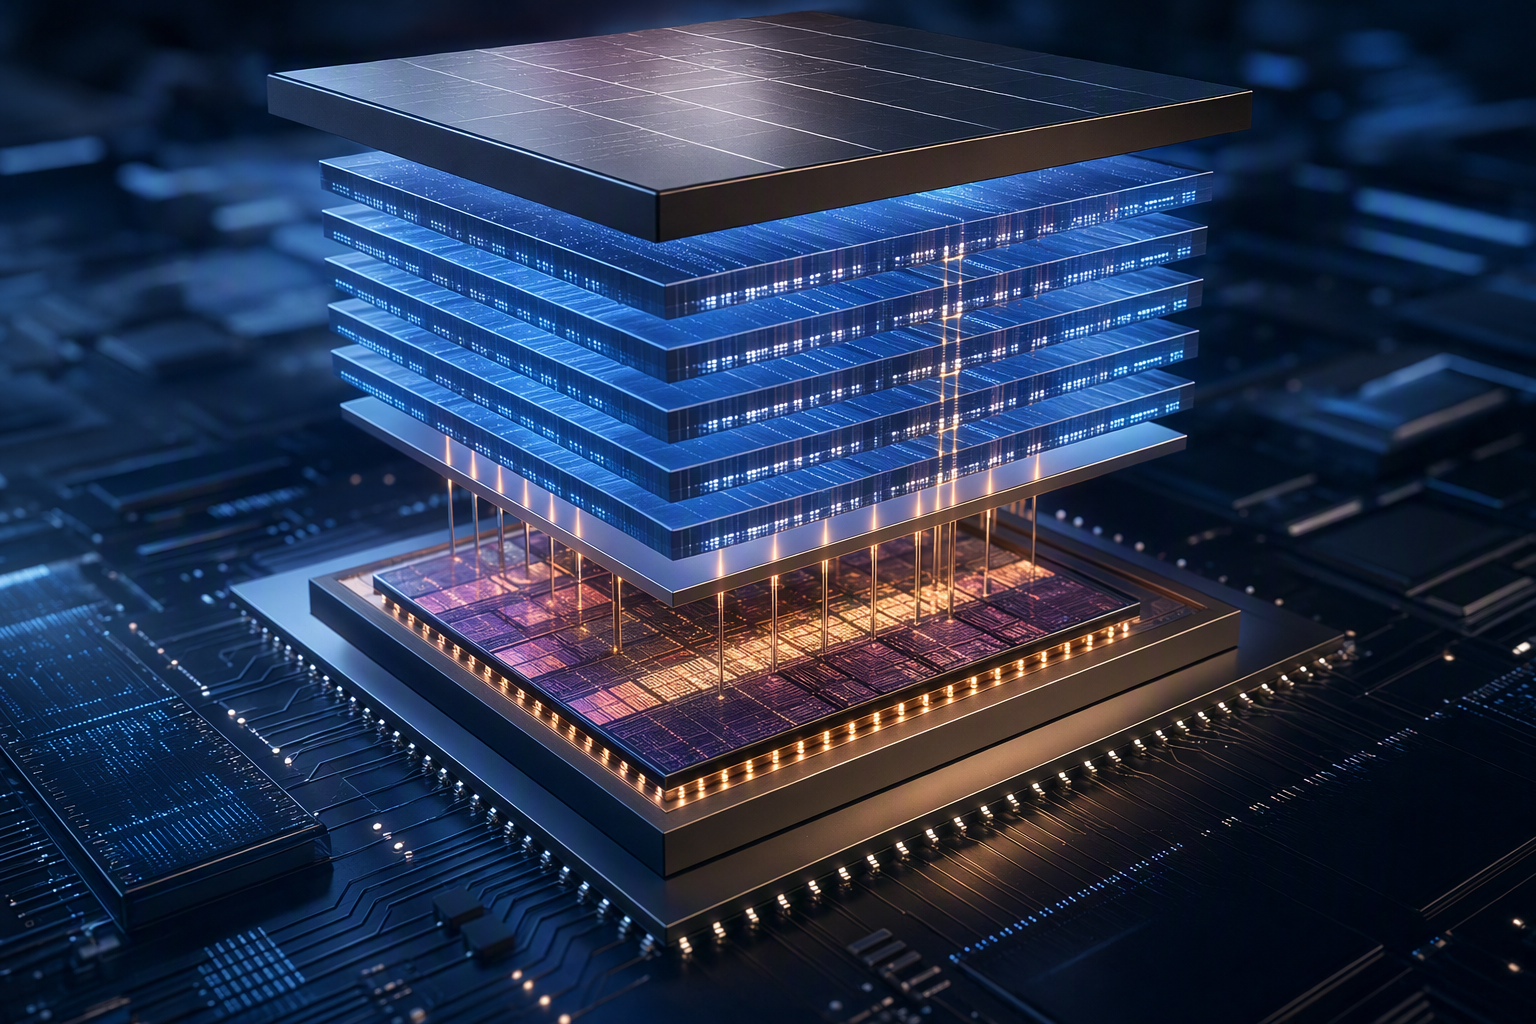
Samsung veut empiler la mémoire HBM directement au dessus d’un accélérateur d’IA, plutôt que de la placer à côté comme dans les boîtiers actuels. Le groupe évoque plus de 10× de réactivité pour les systèmes d’IA et, pour une future interface zHBM, jusqu’à 8× les performances de la HBM5 selon ses propres projections.
Publié parModifié avec GPT-5.6 TerraImages générées avec GPT Image 2
Réponse de recherche
Points clés à retenir
- Samsung veut empiler la mémoire HBM directement au dessus d’un accélérateur d’IA, plutôt que de la placer à côté comme dans les boîtiers actuels.
- Le groupe évoque plus de 10× de réactivité pour les systèmes d’IA et, pour une future interface zHBM, jusqu’à 8× les performances de la HBM5 selon ses propres projections.
- Pour OpenAI et Intel, le CXL peut compléter la capacité mémoire, mais ne semble pas appelé à remplacer la HBM pour l’exécution active des modèles d’IA.
Prompt IA
openai.comCreate a landscape editorial hero image for this Studio Global article: What did Samsung Electronics reveal at the September 16, 2026, AI Infrastructure Summit about its next-generation zHBM 3D memory architectur. Article summary: Samsung presented zHBM as a longer-term “zero-distance” HBM architecture: rather than placing HBM beside an AI accelerator on a silicon interposer, as in current 2.5D packages, it would bond HBM directly above the accele. Topic tags: general, general web, user generated, news. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts w
Samsung veut réduire au minimum la distance qui sépare les processeurs d’IA de leur mémoire la plus rapide. Avec zHBM, le groupe sud-coréen envisage de placer la mémoire à haute bande passante — la HBM — directement au-dessus d’un GPU ou d’un autre accélérateur, dans un boîtier 3D vertical. Présentée le 16 septembre au salon AI Infrastructure Summit de Santa Clara, cette piste est conçue pour rendre les systèmes d’IA agentique plus réactifs. 1
9
Ce que zHBM change par rapport aux boîtiers HBM actuels
Dans les architectures HBM classiques, les piles de mémoire sont généralement disposées à côté du GPU ou de l’accélérateur, sur le même plan, puis reliées via un packaging avancé. On parle couramment d’intégration 2,5D. zHBM inverse cette logique : la mémoire HBM serait empilée verticalement, juste au-dessus de la puce de calcul. 12
13
L’intérêt est intuitif : des trajets de données plus courts peuvent augmenter la bande passante et réduire l’énergie nécessaire aux transferts, tout en concentrant davantage de mémoire dans une même surface. Samsung indique s’appuyer pour cela sur des techniques de collage de wafers de nouvelle génération, dont le collage hybride cuivre. 7
48
Il ne s’agit pas encore d’un produit destiné à remplacer tous les boîtiers HBM existants. Samsung a dévoilé zHBM sous la forme d’un modèle conceptuel et n’a annoncé aucun calendrier de commercialisation. 13
14
Des objectifs très ambitieux, à prendre comme des projections
Pour une interface de nouvelle génération intégrant zHBM, Samsung avance les cibles suivantes :
- environ 8× les performances de la HBM5 ;
- plus de 10× la densité mémoire d’une HBM5 conventionnelle ;
- environ 3× l’efficacité énergétique ;
- plus de 50 % de résistance thermique en moins.
13
48
Lors de l’AI Infrastructure Summit, Samsung a aussi affirmé que zHBM pourrait améliorer de plus de dix fois la vitesse de réponse d’un système d’IA, avec l’objectif annoncé d’atteindre 1 000 tokens par seconde. 1
9
Ces chiffres sont des objectifs communiqués par l’entreprise pour une architecture future, non des mesures indépendantes effectuées sur un accélérateur commercial. La difficulté industrielle est considérable : il faudra assurer les rendements de fabrication, évacuer la chaleur produite par la logique placée sous la mémoire, démontrer la fiabilité du tout et qualifier l’intégration avec les partenaires fabricants d’accélérateurs.
Pourquoi l’enjeu est important pour l’IA agentique
Samsung a présenté zHBM dans le contexte des agents d’IA : ces systèmes enchaînent les accès au contexte, l’inférence, l’utilisation d’outils et la génération de réponses. Dans ce type de charge de travail, ajouter de la puissance de calcul ne suffit pas si l’accélérateur passe son temps à attendre les données.
L’ambition de zHBM est donc de traiter ce goulet d’étranglement lié à la mémoire et aux transferts. Rapprocher physiquement la HBM de l’accélérateur pourrait rendre ces boucles plus rapides et réduire le coût énergétique des mouvements de données. 1
7 Mais le gain final dépendra de l’ensemble de la plateforme — accélérateur, logiciels, modèle utilisé et packaging — et pas uniquement de l’emplacement de la mémoire.
zNAND-O, une couche plus dense aux côtés de la DRAM
Samsung a présenté zHBM avec zNAND-O, une architecture NAND hautes performances destinée aux environnements riches en données et à l’IA en périphérie, ou edge AI. zNAND-O se positionne entre la DRAM et le stockage NAND classique : Samsung vise une densité supérieure à celle de la DRAM, avec de meilleures performances d’entrée-sortie, une latence réduite et une meilleure efficacité énergétique que la NAND conventionnelle. 49
51
Les deux technologies ne remplissent pas le même rôle dans la hiérarchie mémoire :
- zHBM vise l’échelon le plus rapide, au plus près de l’accélérateur ;
- zNAND-O doit offrir une capacité plus dense pour les données et modèles qu’il serait coûteux de conserver entièrement en DRAM.
49
53
Samsung cite un essai avec un modèle GPT de 120 milliards de paramètres : zNAND-O y aurait atteint le même débit de tokens par seconde qu’un serveur DRAM traditionnel, pour un coût d’exploitation représentant un sixième de celui-ci. Il s’agit d’un résultat de test rapporté par Samsung, et non d’une garantie de coût applicable à tous les déploiements de grands modèles. 54
55
Le groupe relie aussi zNAND-O au défi de l’exécution de modèles locaux de très grande taille, estimant que l’IA embarquée à l’échelle du billion de paramètres pourrait devenir pertinente à l’horizon 2030. 53
Le CXL ne semble pas en mesure de détrôner la HBM pour les calculs actifs
Le sommet a également mis en lumière une distinction importante : davantage de capacité mémoire ne rend pas toutes les mémoires équivalentes.
Daniel Morris, chercheur chez OpenAI sur les accélérateurs d’IA, a déclaré ne pas avoir identifié de cas d’usage du CXL (Compute Express Link, un standard d’interconnexion permettant notamment d’étendre ou mutualiser de la mémoire) pour faire réellement tourner des modèles d’IA. Il lui voit en revanche un intérêt possible pour les données rarement sollicitées dans les grands modèles. Vidia Thiagarajan, responsable de l’architecture des SoC d’IA chez Intel, a elle aussi présenté le regroupement de mémoire via CXL comme un complément au stockage secondaire, plutôt qu’un substitut à la HBM, en raison de l’écart de bande passante. 18
22
Cela ne signifie pas que le CXL est inutile. L’architecture qui se dessine est plutôt organisée en niveaux : de la HBM très proche de l’accélérateur pour les calculs actifs sensibles à la bande passante, puis du CXL et d’autres couches mémoire ou de stockage pour répondre à des besoins de capacité.
Ce que cela implique pour Samsung, SK hynix et le marché
À court terme, la concurrence dans la HBM se joue toujours sur la capacité à fabriquer, qualifier et livrer une mémoire compatible avec des plateformes d’accélérateurs précises. zHBM donne à Samsung une architecture différenciante à long terme, mais ne le dispense pas de démontrer les rendements, le comportement thermique, la fiabilité et l’intégration chez les clients.
Le scepticisme exprimé envers le CXL comme remplaçant de la HBM renforce, lui, l’importance de la mémoire à très haute bande passante placée au voisinage immédiat des accélérateurs. Pour Samsung comme pour SK hynix, la question n’est donc pas seulement de proposer le concept 3D le plus audacieux : il faut le transformer en produit qualifié, fabriqué en volume et livré à temps. 18
33
36
À retenir
Le message de Samsung est clair : les limites de l’IA ne tiennent plus seulement au nombre d’opérations de calcul, mais aussi aux transferts de données, à la capacité mémoire, à la consommation électrique et à la chaleur. zHBM propose de s’attaquer à ces contraintes avec une mémoire 3D directement intégrée à l’accélérateur, tandis que zNAND-O viserait une couche plus dense pour les grands jeux de données et les modèles plus volumineux.
Les gains annoncés sont spectaculaires, mais concernent une technologie encore conceptuelle. Pour les acheteurs d’infrastructures et les planificateurs de capacités IA, le signal immédiat est surtout stratégique : les futurs systèmes devraient multiplier les niveaux de mémoire spécialisés et intégrés verticalement, avec la HBM appelée à rester centrale sur le chemin de calcul le plus exigeant. 13
14
18
Studio Global AI
Continuez vos recherches
Cette page comprend une réponse basée sur la source que vous pouvez continuer dans Studio Global.
Les gens demandent aussi
Quelle est la réponse courte à « Samsung zHBM : la mémoire HBM directement au-dessus des accélérateurs d’IA » ?
Samsung veut empiler la mémoire HBM directement au dessus d’un accélérateur d’IA, plutôt que de la placer à côté comme dans les boîtiers actuels.
Quels sont les points clés à valider en premier ?
Samsung veut empiler la mémoire HBM directement au dessus d’un accélérateur d’IA, plutôt que de la placer à côté comme dans les boîtiers actuels. Le groupe évoque plus de 10× de réactivité pour les systèmes d’IA et, pour une future interface zHBM, jusqu’à 8× les performances de la HBM5 selon ses propres projections.
Que dois-je faire ensuite en pratique ?
Pour OpenAI et Intel, le CXL peut compléter la capacité mémoire, mais ne semble pas appelé à remplacer la HBM pour l’exécution active des modèles d’IA.
Sources
asiae.co.kr"Opening the Era of 1,000 Tokens per Second"…Samsung Electronics Drives AI Semiconductor Innovation with zHBM
en.sedaily.comSamsung Touts 10-Fold AI Speed Gain With Stacked zHBM Memory
koreaherald.comSamsung stacks HBM atop AI chips in 3D memory push