Benchmark de GPT-5.5 : ce que signifie vraiment 84,9 % sur GDPval
Le repère le plus fiable pour une réponse courte est 84,9 % sur GDPval : OpenAI présente ce test comme une mesure du travail intellectuel bien spécifié dans 44 métiers.[1] Les autres scores cités publiquement, comme 73,1 % sur Expert SWE ou 80,5 % sur BixBench, portent sur d’autres types de tâches et ne doivent pas...
Publié parModifié avec GPT-5.5Images générées avec GPT Image 2
Le repère le plus fiable pour une réponse courte est 84,9 % sur GDPval : OpenAI présente ce test comme une mesure du travail intellectuel bien spécifié dans 44 métiers.[1]
Les autres scores cités publiquement, comme 73,1 % sur Expert SWE ou 80,5 % sur BixBench, portent sur d’autres types de tâches et ne doivent pas être comparés directement à GDPval.[8][10]
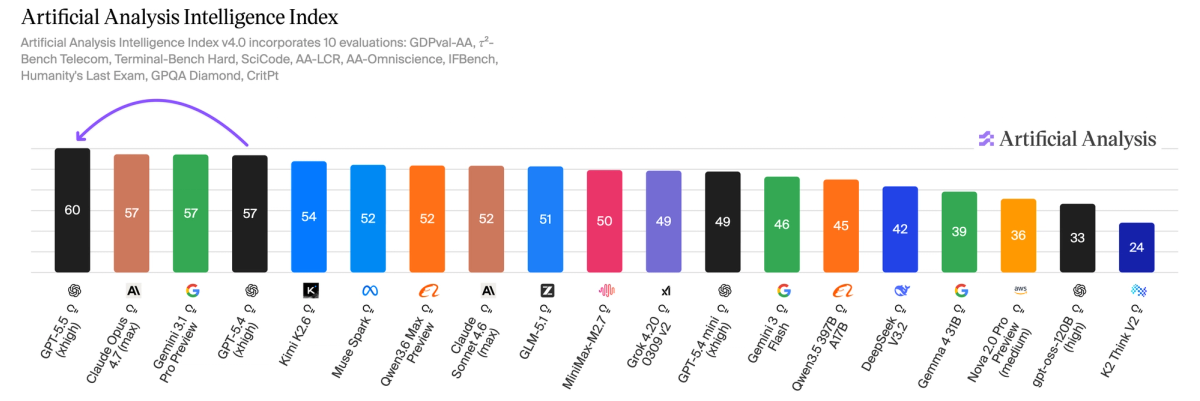
Pour une comparaison externe entre modèles, Artificial Analysis place GPT 5.5 en tête de son Intelligence Index avec trois points d’avance, tout en précisant qu’il ne gagne pas toutes les évaluations individuelles.[3]
GPT-5.5-Benchmark erklärt: Was 84,9 % auf GDPval wirklich bedeutenKI-generierte Illustration zum Vergleich von GPT-5.5-Benchmarks.
Prompt IA
Create a landscape editorial hero image for this Studio Global article: GPT-5.5-Benchmark erklärt: Was 84,9 % auf GDPval wirklich bedeuten. Article summary: Für eine knappe, belastbare Einordnung ist 84,9 % auf GDPval der beste GPT 5.5 Wert: OpenAI nennt ihn selbst und beschreibt GDPval als Test für klar spezifizierte Wissensarbeit über 44 Berufe.. Topic tags: ai, openai, chatgpt, gpt 5, benchmarks. Reference image context from search candidates: Reference image 1: visual subject " GPT-5.5 tops the Artificial Analysis Intelligen" source context "OpenAI's GPT-5.5 is the new leading AI model - Artificial Analysis" Reference image 2: visual subject " GPT-5.5 tops the Artificial Analysis Intelligen" source context "OpenAI's GPT-5.5 is the new leading AI model - Artificial Analysis" Reference image 2: visual subject "![Image 1](https://cdn.sanity.io/images/6vfeftx9/articles/9052d745e6337cd4369bde9219bcf511bebec944-4644x1551.png?
openai.com
Quand on demande « quel est le benchmark de GPT-5.5 ? », la réponse honnête commence par une précision : il n’existe pas un seul score qui résume tout le modèle.
Pour une réponse courte et solide, le meilleur chiffre à citer est toutefois 84,9 % sur GDPval. OpenAI donne ce score et décrit GDPval comme un benchmark destiné à tester la capacité d’agents à produire un travail intellectuel bien spécifié dans 44 métiers.
La nuance est importante : 84,9 % n’est pas une note générale d’intelligence. Ce score dit surtout quelque chose de la capacité du modèle à comprendre des consignes professionnelles, structurer une tâche et produire un livrable défini.
Le chiffre à retenir : 84,9 % sur GDPval
La formulation la plus précise est la suivante :
Selon OpenAI, GPT-5.5 atteint 84,9 % sur GDPval, un benchmark qui évalue la production de travail intellectuel bien spécifié dans 44 métiers.
Studio Global AI
Continuez vos recherches
Cette page comprend une réponse basée sur la source que vous pouvez continuer dans Studio Global.
Quelle est la réponse courte à « Benchmark de GPT-5.5 : ce que signifie vraiment 84,9 % sur GDPval » ?
Le repère le plus fiable pour une réponse courte est 84,9 % sur GDPval : OpenAI présente ce test comme une mesure du travail intellectuel bien spécifié dans 44 métiers.[1]
Quels sont les points clés à valider en premier ?
Le repère le plus fiable pour une réponse courte est 84,9 % sur GDPval : OpenAI présente ce test comme une mesure du travail intellectuel bien spécifié dans 44 métiers.[1] Les autres scores cités publiquement, comme 73,1 % sur Expert SWE ou 80,5 % sur BixBench, portent sur d’autres types de tâches et ne doivent pas être comparés directement à GDPval.[8][10]
Que dois-je faire ensuite en pratique ?
Pour une comparaison externe entre modèles, Artificial Analysis place GPT 5.5 en tête de son Intelligence Index avec trois points d’avance, tout en précisant qu’il ne gagne pas toutes les évaluations individuelles.[3]
C’est le bon repère si l’on veut situer GPT-5.5 comme modèle de travail généraliste : rédaction structurée, analyse, synthèse, préparation de livrables ou tâches de connaissance proches d’un contexte professionnel.
Mais GDPval ne remplace pas un test de programmation, un benchmark scientifique ou un classement externe de modèles. Mettre côte à côte plusieurs pourcentages sans expliquer ce qu’ils mesurent peut donc donner une impression trompeuse.
Les principaux scores cités publiquement
Benchmark ou comparaison
Valeur rapportée
Ce que le score mesure
Comment l’interpréter
GDPval
84,9 %
Travail intellectuel bien spécifié dans 44 métiers
Le chiffre le plus naturel à citer pour une réponse générale, car il est donné directement dans l’annonce d’OpenAI.
Expert-SWE
73,1 %
Tâches de programmation ; l’article cité le présente comme une évaluation interne portant sur des tâches estimées à 20 heures
Plus pertinent pour le développement logiciel que GDPval, mais non comparable directement.
BixBench
80,5 %
Benchmark de bioinformatique en conditions réelles
Pertinent pour la bioinformatique, mais à manier avec plus de prudence dans les sources disponibles que le score GDPval communiqué par OpenAI.
Artificial Analysis Intelligence Index
1re place, avec 3 points d’avance
Indice externe de comparaison entre modèles
Utile pour une vue d’ensemble, mais ce n’est pas un benchmark officiel unique d’OpenAI.
Pourquoi ces pourcentages ne se comparent pas directement
À première vue, 84,9 %, 73,1 % et 80,5 % semblent appartenir à la même échelle. Ce n’est pas le cas.
84,9 % sur GDPval concerne du travail intellectuel spécifié à travers 44 métiers.
73,1 % sur Expert-SWE concerne des tâches de programmation dans une évaluation interne rapportée par la source citée.
80,5 % sur BixBench concerne des tâches de bioinformatique.
La bonne question n’est donc pas : « quel pourcentage est le plus élevé ? » Elle est plutôt : « quel benchmark correspond à l’usage visé ? »
Pour de la production de documents, de l’analyse ou de la connaissance métier, GDPval est le meilleur point de départ. Pour du développement logiciel, Expert-SWE est plus proche du problème. Pour la bioinformatique, BixBench est thématiquement plus adapté.
Ce que dit le classement d’Artificial Analysis
Artificial Analysis indique que GPT-5.5 prend la tête de son Intelligence Index avec trois points d’avance. Le même compte rendu précise aussi qu’OpenAI mène cinq de ses évaluations principales et arrive deuxième derrière Gemini 3.1 Pro Preview dans trois autres.
Autrement dit, une première place dans un indice externe ne signifie pas que le modèle gagne tous les tests. Cela signifie que, selon la méthode de calcul d’Artificial Analysis, GPT-5.5 obtient le meilleur résultat global.
Attention aux chiffres isolés
D’autres articles mentionnent encore d’autres valeurs, par exemple 91,7 % dans un contexte de capacités juridiques ou 82,7 % pour du codage agentique.
Ces chiffres peuvent être intéressants pour des usages spécialisés. En revanche, ils sont moins adaptés comme réponse générale tant que le protocole, le périmètre du test et le groupe de comparaison ne sont pas aussi clairement posés que pour le score GDPval communiqué par OpenAI.
Quel benchmark citer selon le contexte ?
Pour la plupart des comparaisons générales, la formule la plus propre est :
GPT-5.5 obtient 84,9 % sur GDPval selon OpenAI ; GDPval teste la capacité d’agents à produire du travail intellectuel bien spécifié dans 44 métiers.
Si le contexte est plus précis, il vaut mieux changer de référence :
Travail intellectuel généraliste : 84,9 % sur GDPval.
Développement logiciel : 73,1 % sur Expert-SWE.
Bioinformatique : 80,5 % sur BixBench, avec réserve sur la solidité relative de la source disponible.
Comparaison globale entre modèles : première place dans l’Artificial Analysis Intelligence Index, avec trois points d’avance.
En bref
Le meilleur chiffre court pour situer GPT-5.5 est 84,9 % sur GDPval. Il est directement attribué à OpenAI et son périmètre est clair : du travail intellectuel bien spécifié dans 44 métiers.
Les autres scores ne sont pas à ignorer, mais ils doivent toujours être cités avec leur benchmark. Sinon, on compare des tests qui ne mesurent pas la même chose.
mexc.com
OpenAI’s GPT-5.5 Launches With 91.7% Benchmark Score | MEXC News
C’est le bon repère si l’on veut situer GPT-5.5 comme modèle de travail généraliste : rédaction structurée, analyse, synthèse, préparation de livrables ou tâches de connaissance proches d’un contexte professionnel.
Mais GDPval ne remplace pas un test de programmation, un benchmark scientifique ou un classement externe de modèles. Mettre côte à côte plusieurs pourcentages sans expliquer ce qu’ils mesurent peut donc donner une impression trompeuse.
Les principaux scores cités publiquement
Benchmark ou comparaison
Valeur rapportée
Ce que le score mesure
Comment l’interpréter
GDPval
84,9 %
Travail intellectuel bien spécifié dans 44 métiers
Le chiffre le plus naturel à citer pour une réponse générale, car il est donné directement dans l’annonce d’OpenAI.
Expert-SWE
73,1 %
Tâches de programmation ; l’article cité le présente comme une évaluation interne portant sur des tâches estimées à 20 heures
Plus pertinent pour le développement logiciel que GDPval, mais non comparable directement.
BixBench
80,5 %
Benchmark de bioinformatique en conditions réelles
Pertinent pour la bioinformatique, mais à manier avec plus de prudence dans les sources disponibles que le score GDPval communiqué par OpenAI.
Artificial Analysis Intelligence Index
1re place, avec 3 points d’avance
Indice externe de comparaison entre modèles
Utile pour une vue d’ensemble, mais ce n’est pas un benchmark officiel unique d’OpenAI.
Pourquoi ces pourcentages ne se comparent pas directement
À première vue, 84,9 %, 73,1 % et 80,5 % semblent appartenir à la même échelle. Ce n’est pas le cas.
84,9 % sur GDPval concerne du travail intellectuel spécifié à travers 44 métiers.
73,1 % sur Expert-SWE concerne des tâches de programmation dans une évaluation interne rapportée par la source citée.
80,5 % sur BixBench concerne des tâches de bioinformatique.
La bonne question n’est donc pas : « quel pourcentage est le plus élevé ? » Elle est plutôt : « quel benchmark correspond à l’usage visé ? »
Pour de la production de documents, de l’analyse ou de la connaissance métier, GDPval est le meilleur point de départ. Pour du développement logiciel, Expert-SWE est plus proche du problème. Pour la bioinformatique, BixBench est thématiquement plus adapté.
Ce que dit le classement d’Artificial Analysis
Artificial Analysis indique que GPT-5.5 prend la tête de son Intelligence Index avec trois points d’avance. Le même compte rendu précise aussi qu’OpenAI mène cinq de ses évaluations principales et arrive deuxième derrière Gemini 3.1 Pro Preview dans trois autres.
Autrement dit, une première place dans un indice externe ne signifie pas que le modèle gagne tous les tests. Cela signifie que, selon la méthode de calcul d’Artificial Analysis, GPT-5.5 obtient le meilleur résultat global.
Attention aux chiffres isolés
D’autres articles mentionnent encore d’autres valeurs, par exemple 91,7 % dans un contexte de capacités juridiques ou 82,7 % pour du codage agentique.
Ces chiffres peuvent être intéressants pour des usages spécialisés. En revanche, ils sont moins adaptés comme réponse générale tant que le protocole, le périmètre du test et le groupe de comparaison ne sont pas aussi clairement posés que pour le score GDPval communiqué par OpenAI.
Quel benchmark citer selon le contexte ?
Pour la plupart des comparaisons générales, la formule la plus propre est :
GPT-5.5 obtient 84,9 % sur GDPval selon OpenAI ; GDPval teste la capacité d’agents à produire du travail intellectuel bien spécifié dans 44 métiers.
Si le contexte est plus précis, il vaut mieux changer de référence :
Travail intellectuel généraliste : 84,9 % sur GDPval.
Développement logiciel : 73,1 % sur Expert-SWE.
Bioinformatique : 80,5 % sur BixBench, avec réserve sur la solidité relative de la source disponible.
Comparaison globale entre modèles : première place dans l’Artificial Analysis Intelligence Index, avec trois points d’avance.
En bref
Le meilleur chiffre court pour situer GPT-5.5 est 84,9 % sur GDPval. Il est directement attribué à OpenAI et son périmètre est clair : du travail intellectuel bien spécifié dans 44 métiers.
Les autres scores ne sont pas à ignorer, mais ils doivent toujours être cités avec leur benchmark. Sinon, on compare des tests qui ne mesurent pas la même chose.
mexc.com
OpenAI’s GPT-5.5 Launches With 91.7% Benchmark Score | MEXC News