RéponsesPublié17 sources
Adreno Neural Fusion : comment Qualcomm intègre l’IA directement dans le GPU
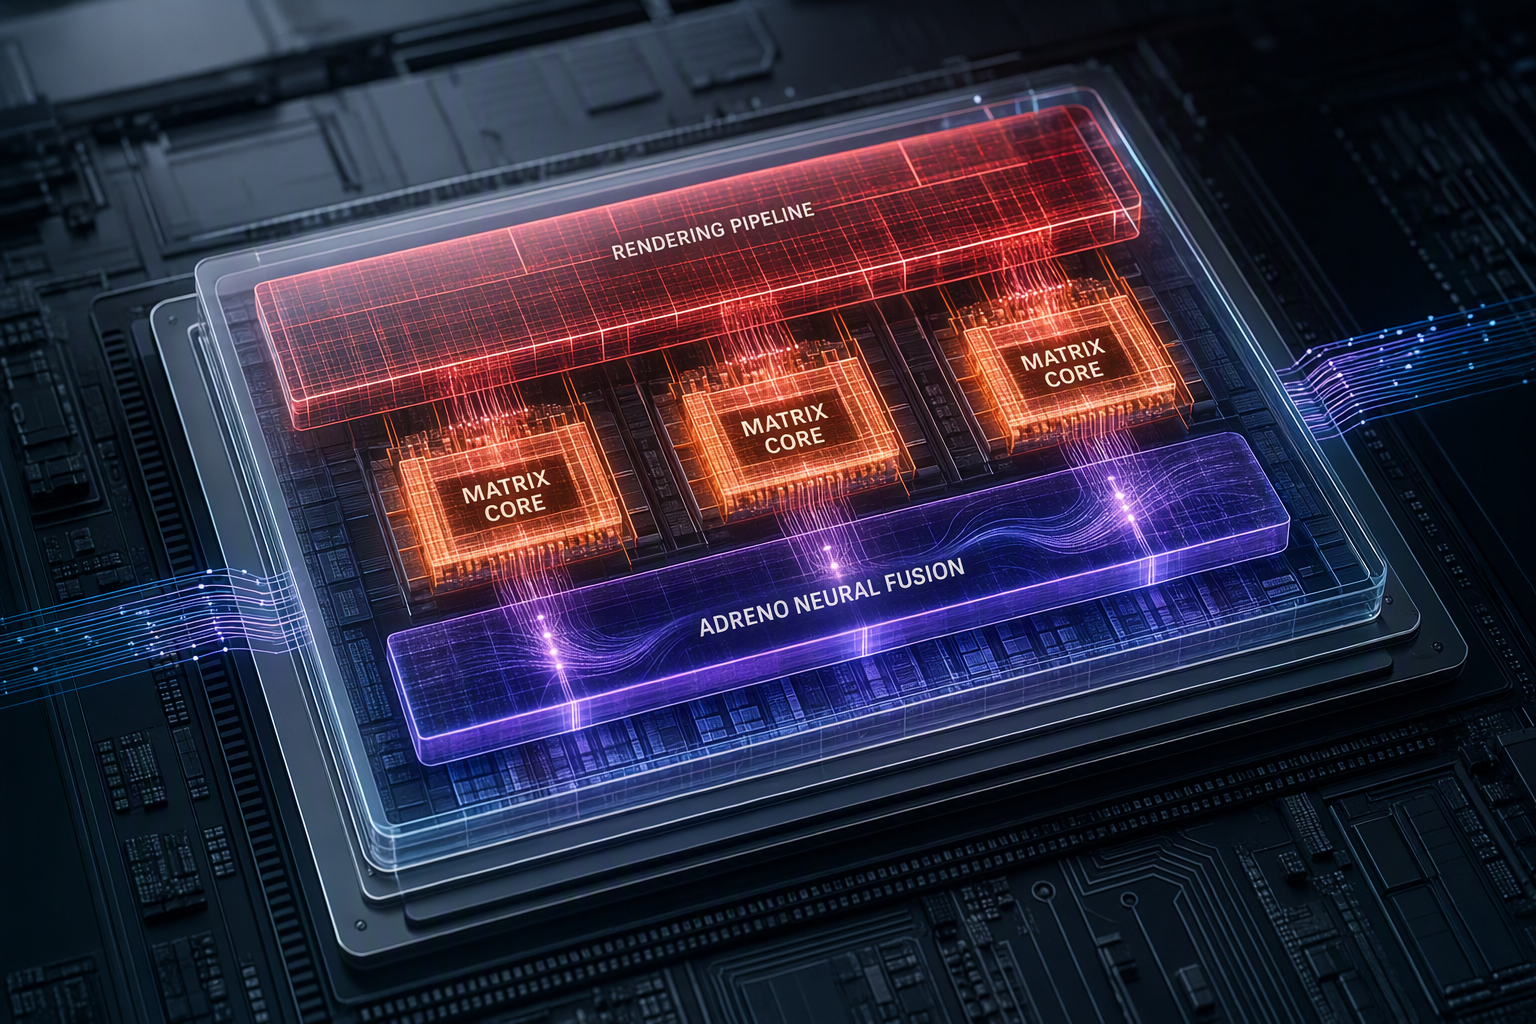
Le prochain GPU Adreno associe un Matrix Core dédié à chacune de ses trois tranches graphiques afin d’exécuter l’upscaling par IA et la génération d’images au sein même du pipeline de rendu. L’architecture annoncée atteint 1,45 GHz, embarque 18 Mo de mémoire Adreno High Performance Memory (HPM) et est associée à un...
Publié parModifié avec GPT-5.6 TerraImages générées avec GPT Image 2
Réponse de recherche
Points clés à retenir
- Le prochain GPU Adreno associe un Matrix Core dédié à chacune de ses trois tranches graphiques afin d’exécuter l’upscaling par IA et la génération d’images au sein même du pipeline de rendu.
- L’architecture annoncée atteint 1,45 GHz, embarque 18 Mo de mémoire Adreno High Performance Memory (HPM) et est associée à un gain d’efficacité énergétique d’environ 12 % selon les informations publiées.
- Qualcomm annonce une prise en charge dans Unity et Unreal Engine, tandis que cette présentation s’inscrit dans la préparation de sa prochaine plateforme Snapdragon, avec CPU Oryon à 5 GHz et FlexCache.
Prompt IA
openai.comCreate a landscape editorial hero image for this Studio Global article: How does Qualcomm’s next-generation flagship Snapdragon Adreno GPU integrate three dedicated Matrix Cores and Adreno Neural Fusion directly. Article summary: Qualcomm is moving AI graphics from a separate NPU round trip into the GPU itself: each of the new Adreno GPU’s three rendering slices contains a dedicated Matrix Core, and Neural Fusion coordinates those cores with rend. Topic tags: general, general web, documentation. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts with fake
Qualcomm veut éviter que les traitements d’IA liés à l’image ne fassent des allers-retours entre plusieurs blocs de la puce. Avec Adreno Neural Fusion, le groupe place des accélérateurs IA dédiés directement dans le GPU : une approche destinée aux jeux mobiles qui misent sur la super-résolution et la génération d’images. 1
4
Trois tranches GPU, trois Matrix Cores
La nouvelle architecture Adreno repose sur trois tranches (« slices ») GPU. Chacune reçoit son propre Adreno Matrix Core, un bloc de calcul spécialement consacré à l’IA. Ces cœurs doivent exécuter des modèles graphiques avancés localement, au sein du pipeline de rendu. 2
4
C’est important parce que la super-résolution et la génération d’images exploitent des données très proches du rendu : images successives, informations de mouvement, tuiles de rendu et résultats intermédiaires. En gardant l’accélération IA dans l’architecture graphique, Qualcomm entend limiter les transferts de données et les phases de synchronisation avec des unités séparées. L’entreprise affirme que cette organisation réduit la latence et le surcoût énergétique. 1
3
À quoi sert Adreno Neural Fusion ?
Adreno Neural Fusion désigne le flux de rendu unifié de Qualcomm, qui réunit :
- le traitement neuronal ;
- la super-résolution par IA ;
- la génération d’images.
1
Concrètement, un jeu peut calculer son image à une définition interne plus faible, puis utiliser un modèle d’IA pour reconstruire une image finale plus détaillée. Il peut aussi générer des images supplémentaires à partir des données d’images déjà rendues. L’objectif est d’améliorer la finesse perçue et la fluidité sans devoir produire traditionnellement chaque pixel ou chaque image.
Qualcomm promet des détails plus nets, une image plus stable et moins d’artefacts, tels que le scintillement, le clignotement ou les effets de rémanence (« ghosting »). Ces résultats restent toutefois des affirmations du constructeur : la qualité d’image et la latence dépendront de l’intégration dans chaque jeu, et aucun test indépendant n’a encore mesuré les performances finales. 1
13
Les 18 Mo de mémoire Adreno HPM, un élément central
Le GPU intègre aussi 18 Mo d’Adreno High Performance Memory (HPM), une mémoire à faible latence placée près du GPU. Elle est conçue pour conserver localement des données graphiques — données de rendu par tuiles, tampons d’images et charges de calcul — plutôt que de solliciter à répétition la mémoire système. 1
4
Réduire les accès à la mémoire principale peut alléger la pression sur la bande passante, diminuer la latence et limiter la consommation, notamment pour les traitements qui réutilisent de nombreuses données d’image intermédiaires. Des comptes rendus de l’annonce indiquent une fréquence maximale de 1,45 GHz pour le GPU à trois tranches, contre 1,2 GHz pour la conception précédente, ainsi qu’un gain d’efficacité énergétique d’environ 12 %. 2
5
La promesse de 40 % de consommation en moins doit être nuancée
Qualcomm avance jusqu’à 40 % de consommation GPU en moins que sa solution précédente dans des scénarios de rendu IA concernés. 13 Ce chiffre ne doit pas être interprété comme un gain d’autonomie garanti dans tous les jeux, sur tous les smartphones, à toutes les définitions ou dans toutes les conditions thermiques.
Le résultat réel dépendra notamment de l’intégration par le jeu, du modèle IA employé, de la fréquence de rafraîchissement de l’écran, du refroidissement du téléphone et du fait que le jeu soit limité par le GPU, le CPU ou la mémoire. Avant les essais indépendants sur des appareils commercialisés et des jeux compatibles, il faut donc considérer ces chiffres comme des objectifs architecturaux et des mesures communiquées par Qualcomm.
Unity et Unreal Engine sont annoncés comme compatibles
Qualcomm indique que Neural Fusion est pris en charge dans Unity et Unreal Engine. 1
4 Une telle intégration au niveau des moteurs de jeu pourrait réduire le travail spécifique nécessaire aux studios. Elle ne signifie pas pour autant que tous les jeux activeront la fonction, ni qu’ils obtiendront les mêmes gains visuels ou de performances.
Une pièce du prochain écosystème Snapdragon
Cette présentation du GPU accompagne l’aperçu de la prochaine génération de CPU Oryon. Qualcomm annonce une fréquence pouvant atteindre 5 GHz et une nouvelle architecture de cache, FlexCache. Celle-ci permet à des cœurs CPU hétérogènes d’accéder à un pool de cache partagé, alloué dynamiquement, afin de conserver plus longtemps les grands ensembles de données dans le cache plutôt que de les renvoyer vers la mémoire.
L’ensemble dessine une stratégie de calcul hétérogène : le GPU et ses Matrix Cores traiteraient l’IA directement liée au rendu, tandis que le CPU et son système de cache viseraient la réactivité générale et les charges variables. Qualcomm avait prévu son Snapdragon Summit du 22 au 24 septembre, à Maui, avec davantage de détails attendus sur le NPU Hexagon. 11
Les inconnues qui restent à éclaircir
L’annonce décrit l’architecture, mais plusieurs points ne sont pas encore connus :
- les produits Snapdragon définitifs qui adopteront ce GPU Adreno ;
- les jeux qui sortiront avec Neural Fusion activé ;
- les performances réelles de la super-résolution et de la génération d’images selon les titres ;
- la tenue des gains énergétiques sous les limites thermiques d’un smartphone en usage prolongé ;
- la répartition exacte entre les tâches des Matrix Cores, centrées sur le rendu, et les autres travaux d’IA exécutés ailleurs dans le SoC.
Le message de Qualcomm est simple : l’IA de rendu doit devenir une fonction native du GPU, et non plus un ajout externe. La véritable épreuve viendra avec les jeux disponibles dans le commerce : ils devront démontrer une meilleure qualité d’image, une fluidité accrue et des économies de batterie mesurables.
Studio Global AI
Continuez vos recherches
Cette page comprend une réponse basée sur la source que vous pouvez continuer dans Studio Global.
Les gens demandent aussi
Quelle est la réponse courte à « Adreno Neural Fusion : comment Qualcomm intègre l’IA directement dans le GPU » ?
Le prochain GPU Adreno associe un Matrix Core dédié à chacune de ses trois tranches graphiques afin d’exécuter l’upscaling par IA et la génération d’images au sein même du pipeline de rendu.
Quels sont les points clés à valider en premier ?
Le prochain GPU Adreno associe un Matrix Core dédié à chacune de ses trois tranches graphiques afin d’exécuter l’upscaling par IA et la génération d’images au sein même du pipeline de rendu. L’architecture annoncée atteint 1,45 GHz, embarque 18 Mo de mémoire Adreno High Performance Memory (HPM) et est associée à un gain d’efficacité énergétique d’environ 12 % selon les informations publiées.
Que dois-je faire ensuite en pratique ?
Qualcomm annonce une prise en charge dans Unity et Unreal Engine, tandis que cette présentation s’inscrit dans la préparation de sa prochaine plateforme Snapdragon, avec CPU Oryon à 5 GHz et FlexCache.
Sources
9to5google.comQualcomm's next premium chip has an Adreno Neural ...
xenospectrum.comQualcomm Debuts Adreno Neural Fusion: AI Cores Built ...
hothardware.comQualcomm Unveils Adreno Neural Fusion To Supercharge Mobile Gaming