Le risque de « model collapse » : quand l’IA se dégrade en apprenant de ses propres données
Des recherches montrent que l’entraînement répété de modèles d’IA sur des données synthétiques peut provoquer un « model collapse », où les modèles perdent progressivement les motifs rares présents dans les données ré... Le phénomène vient d’un biais statistique : les données générées par l’IA reproduisent surtout l...
Publié parModifié avec GPT-5.5Images générées avec GPT Image 2
Des recherches montrent que l’entraînement répété de modèles d’IA sur des données synthétiques peut provoquer un « model collapse », où les modèles perdent progressivement les motifs rares présents dans les données ré...
Le phénomène vient d’un biais statistique : les données générées par l’IA reproduisent surtout les motifs fréquents, ce qui fait disparaître les événements rares au fil des générations de modèles.
Même une très petite quantité de données réelles — voire un seul point de données dans certains modèles théoriques — peut stabiliser l’apprentissage et empêcher cette dérive.
What does the new study on AI model collapse find about preventing degradation when models are trained on synthetic data, why does recursiveRecursive training on AI‑generated data can gradually erase rare patterns from a model’s learned distribution, a phenomenon researchers call model collapse.
Prompt IA
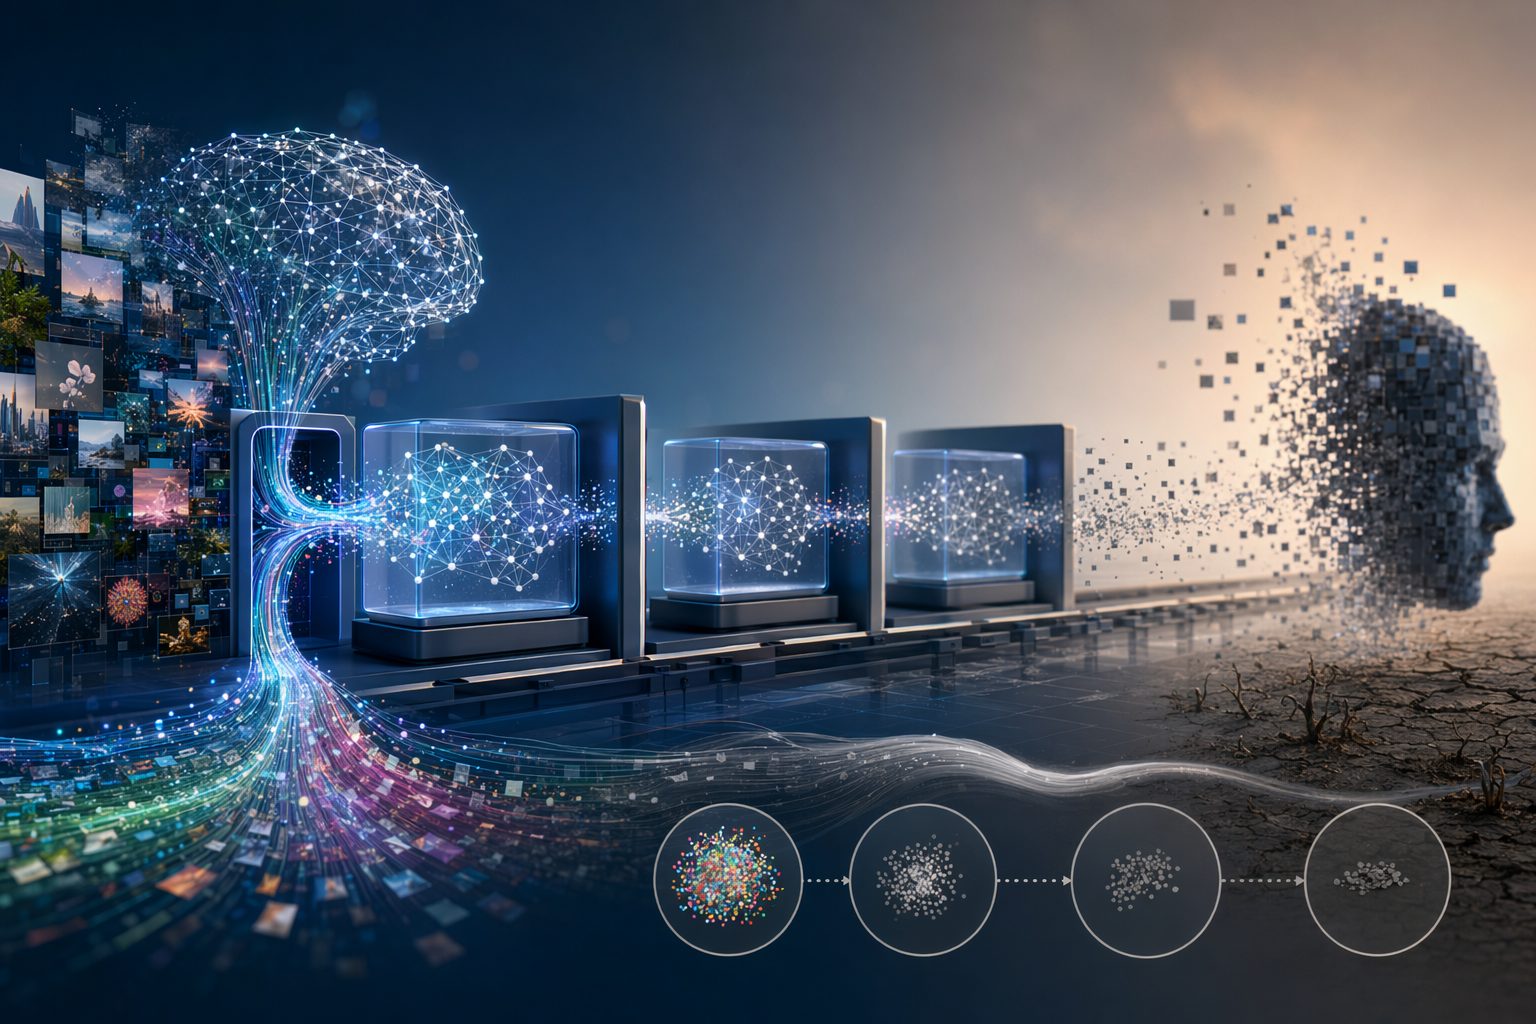
Create a landscape editorial hero image for this Studio Global article: What does the new study on AI model collapse find about preventing degradation when models are trained on synthetic data, why does recursive. Article summary: The study describes model collapse as a failure mode where recursively trained generative models lose information about the original data distribution, especially its rare or low-probability regions.. Topic tags: general, government, education, academic, general web. Reference image context from search candidates: Reference image 1: visual subject "However, as AI-generated data increasingly populates the internet, an important question arises: What happens when new AI models are trained on datasets containing their previous o" source context "Avoiding Model Collapse in AI Training - Risk Insight" Reference image 2: visual subject "Artificial intelligence models
openai.com
Les systèmes d’IA générative sont de plus en plus entraînés à partir de données synthétiques, c’est‑à‑dire du contenu produit par d’autres modèles d’IA. Mais plusieurs travaux de recherche montrent qu’une telle pratique peut entraîner un problème sérieux appelé model collapse (effondrement du modèle) : une dégradation progressive où les modèles perdent leur capacité à représenter toute la diversité des données d’origine.
Une étude majeure sur l’entraînement récursif montre que lorsque les modèles apprennent principalement à partir de sorties générées par d’autres IA plutôt que de données réelles, ils commencent à oublier les motifs rares présents dans la distribution originale. Au fil des cycles d’entraînement, ces informations disparaissent progressivement, ce qui finit par déformer la représentation du monde que le modèle apprend.
Studio Global AI
Continuez vos recherches
Cette page comprend une réponse basée sur la source que vous pouvez continuer dans Studio Global.
Quelle est la réponse courte à « Le risque de « model collapse » : quand l’IA se dégrade en apprenant de ses propres données » ?
Des recherches montrent que l’entraînement répété de modèles d’IA sur des données synthétiques peut provoquer un « model collapse », où les modèles perdent progressivement les motifs rares présents dans les données ré...
Quels sont les points clés à valider en premier ?
Des recherches montrent que l’entraînement répété de modèles d’IA sur des données synthétiques peut provoquer un « model collapse », où les modèles perdent progressivement les motifs rares présents dans les données ré... Le phénomène vient d’un biais statistique : les données générées par l’IA reproduisent surtout les motifs fréquents, ce qui fait disparaître les événements rares au fil des générations de modèles.
Que dois-je faire ensuite en pratique ?
Même une très petite quantité de données réelles — voire un seul point de données dans certains modèles théoriques — peut stabiliser l’apprentissage et empêcher cette dérive.
Ce problème devient particulièrement important à mesure que les contenus générés par l’IA se multiplient sur Internet et risquent d’occuper une part croissante des données utilisées pour entraîner les futures générations de modèles.
Qu’est‑ce que le « model collapse » ?
Le model collapse désigne un mode d’échec dans lequel des modèles génératifs se dégradent lorsqu’ils sont entraînés sur des données produites par des modèles précédents plutôt que sur des données originales générées par des humains.
Les chercheurs ont montré que cet entraînement récursif introduit des défauts irréversibles : les modèles perdent peu à peu l’information contenue dans les queues de la distribution statistique — c’est‑à‑dire les exemples rares ou atypiques qui apparaissent peu souvent mais sont essentiels pour représenter correctement la réalité.
Avec le temps, les sorties du modèle deviennent plus étroites et moins diverses, reflétant surtout les motifs les plus fréquents présents dans les données d’entraînement.
Le phénomène a été observé dans plusieurs familles de modèles génératifs, notamment :
les grands modèles de langage (LLM)
les variational autoencoders (VAE)
les modèles de mélanges gaussiens (GMM)
Le fait que ces architectures différentes montrent le même effet suggère que le model collapse est une propriété générale de l’apprentissage génératif lorsqu’il repose sur des données synthétiques récursives, et non un problème propre à un type de modèle particulier.
Pourquoi l’entraînement récursif fait disparaître les motifs rares
La cause principale est statistique.
Lorsqu’un modèle génère des données synthétiques, il a tendance à produire les motifs les plus probables beaucoup plus souvent que les événements rares. Or ces événements rares se trouvent déjà dans les extrémités de la distribution des données et sont donc peu représentés lors de l’échantillonnage.
Quand une nouvelle génération de modèles est entraînée sur ces données synthétiques :
les exemples rares apparaissent encore moins souvent ;
la distribution apprise devient légèrement biaisée ;
les générations suivantes amplifient ce biais.
Chaque cycle d’entraînement renforce donc la distorsion introduite par les modèles précédents. À terme, les queues de la distribution disparaissent complètement et il ne reste plus que les motifs dominants.
Une fois ces exemples rares absents du corpus d’entraînement, les modèles ultérieurs ne peuvent plus les reconstruire, car aucune donnée ne prouve qu’ils existaient initialement.
Comment des données réelles ou des connaissances préalables peuvent éviter l’effondrement
Une observation surprenante de travaux récents est que très peu d’informations réelles peuvent suffire à stabiliser l’apprentissage.
Des chercheurs qui ont analysé des modèles statistiques appelés familles exponentielles ont montré que l’ajout d’un seul point de données provenant de la distribution réelle peut servir d’« ancre ». Ce point conserve une preuve de l’existence des motifs rares et empêche l’entraînement récursif de converger vers une distribution erronée.
Un effet similaire peut être obtenu avec des connaissances préalables (priors) intégrées au modèle. Ces contraintes limitent les distributions que le modèle peut apprendre, évitant qu’il dérive entièrement vers les biais présents dans les données synthétiques.
En pratique :
des échantillons réels permettent de préserver les motifs rares mais valides ;
des priors structurent l’apprentissage pour empêcher la dérive statistique.
Même si les données synthétiques sont beaucoup plus nombreuses que les données réelles, ces « points d’ancrage » peuvent suffire à maintenir la stabilité du modèle.
Pourquoi ce problème devient crucial pour les grands modèles de langage
Le model collapse inquiète particulièrement les chercheurs parce que la proportion de contenu généré par l’IA sur le web augmente rapidement.
Les grands modèles de langage sont souvent entraînés sur d’immenses ensembles de données collectés sur Internet. Si ces corpus contiennent de plus en plus de texte généré par des IA, les modèles futurs pourraient être formés principalement à partir de données déjà synthétiques.
Le risque est que les modèles s’éloignent progressivement de la richesse et de la diversité du langage humain et des connaissances réelles.
Les conséquences possibles incluent :
une diversité plus faible dans les réponses générées ;
une moins bonne gestion des cas rares ou inhabituels ;
une représentation plus étroite du monde réel.
Pour éviter ce scénario, les chercheurs soulignent l’importance de préserver l’accès à des données humaines fiables ou d’intégrer des mécanismes capables de maintenir la distribution originale des données pendant l’entraînement.
Ce que l’on ne sait pas encore
Même si le mécanisme du model collapse est bien étayé, certains détails restent incertains. Par exemple, l’idée qu’un seul point de donnée réel puisse empêcher l’effondrement provient d’analyses théoriques et de modèles statistiques simplifiés, plutôt que d’expériences à grande échelle sur des LLM industriels.
Dans la pratique, la quantité exacte de données réelles nécessaire pourrait donc dépendre de nombreux facteurs : architecture du modèle, composition du dataset ou méthode d’entraînement.
Malgré ces incertitudes, la conclusion générale est claire : un entraînement d’IA reposant uniquement sur du contenu généré par l’IA risque d’effacer progressivement certaines parties de la réalité, ce qui rend crucial le maintien d’un lien avec des données du monde réel.
arxiv.org
Lost in Retraining: Roaming the Parameter Space of ...
pmc.ncbi.nlm.nih.govAI models collapse when trained on recursively generated data - PMC
pure.ed.ac.uk[PDF] AI models collapse when trained on recursively generated data
openreview.net[PDF] How Bad is Training on Synthetic Data? A Statistical Analysis of ...
techxplore.comA single real-world data point may stop AI model collapse, analysis suggests