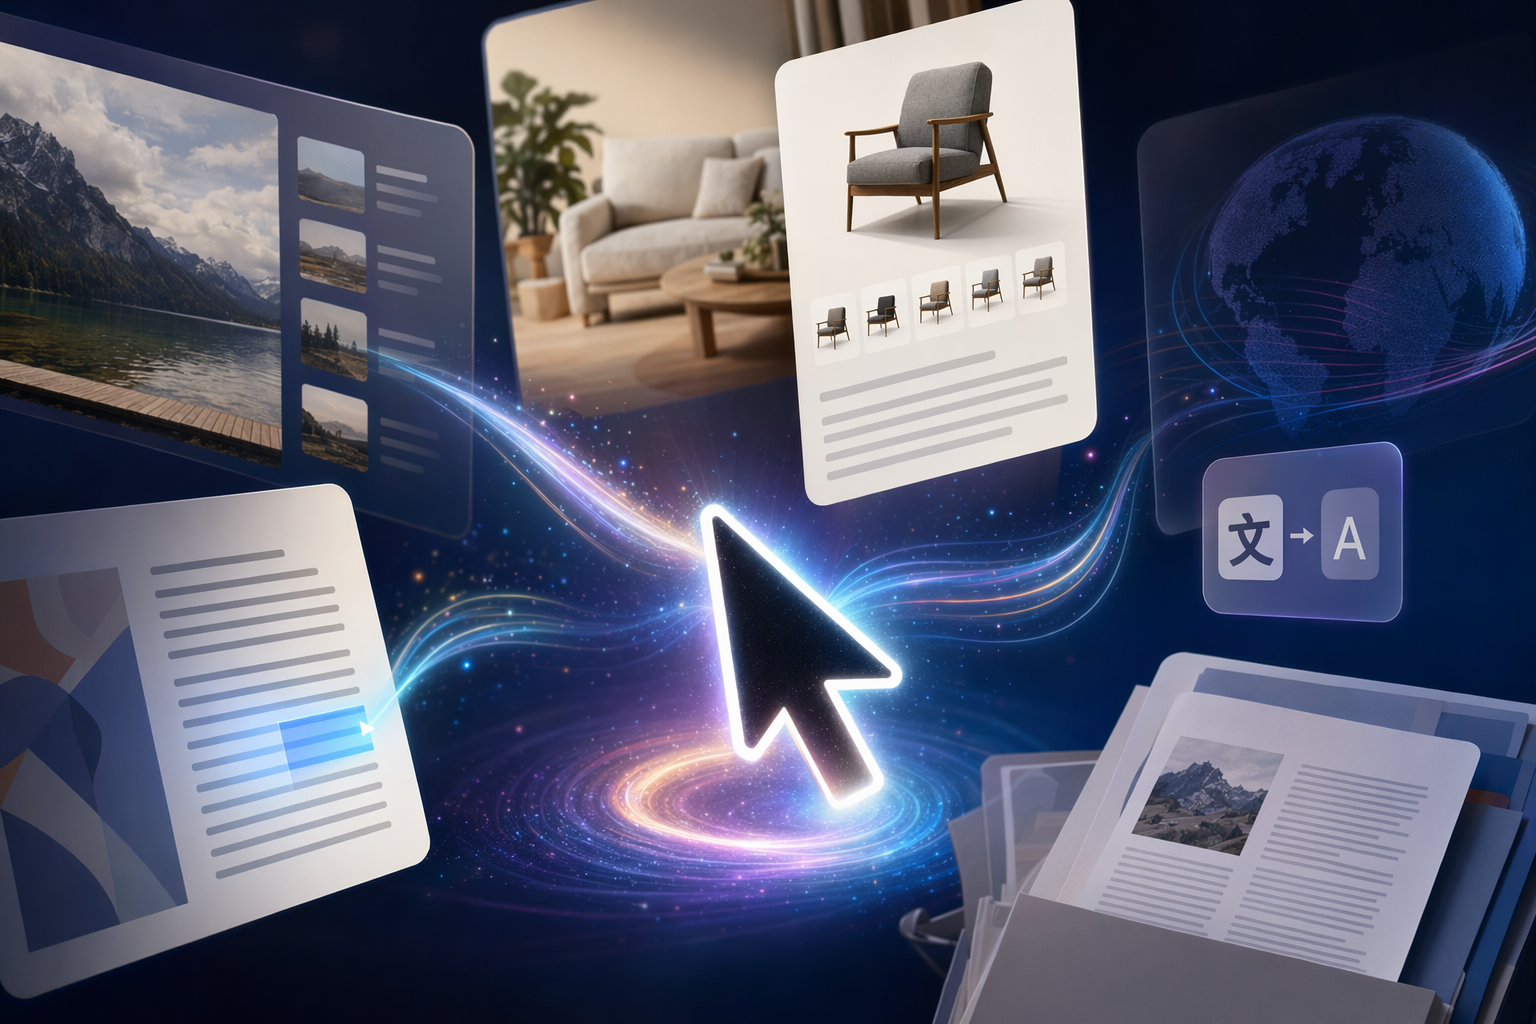
Magic Pointer : le curseur intelligent de Google qui veut transformer l’ordinateur en interface IA
Magic Pointer intègre l’IA Gemini directement dans le curseur : il suffit de pointer un élément à l’écran et de demander à l’IA de le résumer, comparer, traduire ou transformer. La première intégration arrive dans le navigateur Chrome, avec des fonctions comme la comparaison de produits, le résumé d’articles ou l’ex...
Publié parModifié avec GPT-5.5Images générées avec GPT Image 2
Magic Pointer intègre l’IA Gemini directement dans le curseur : il suffit de pointer un élément à l’écran et de demander à l’IA de le résumer, comparer, traduire ou transformer.
La première intégration arrive dans le navigateur Chrome, avec des fonctions comme la comparaison de produits, le résumé d’articles ou l’extraction de données depuis des tableaux.
La technologie reste expérimentale et soulève des questions sur la précision dans les interfaces complexes et sur la confidentialité des données affichées à l’écran.
Google Magic Pointer: How Gemini Turns Your Cursor Into an AI AssistantMagic Pointer integrates Gemini AI directly into the cursor, allowing users to point at on‑screen content and ask the AI to act on it.
Prompt IA
Create a landscape editorial hero image for this Studio Global article: Google Magic Pointer: How Gemini Turns Your Cursor Into an AI Assistant. Article summary: Google’s new “Magic Pointer” turns the mouse cursor into a Gemini powered AI tool that understands what you’re pointing at on screen—letting you compare products, summarize PDFs, translate text, or trigger actions dir.... Topic tags: google, gemini ai, googlebook, chrome, ai assistants. Reference image context from search candidates: Reference image 1: visual subject "Title: Gemini Knows Everything About You: Google's Personal Intelligence Turns AI into a True Personal Assistant # Gemini Knows Everything About You: Google's Personal Intelligence" source context "Gemini Knows Everything About You: Google's Personal Intelligence Turns AI into a True Personal Assistant" Reference image 2: visual subject "# Pointer: A New Way to Int
openai.com
Google expérimente une nouvelle manière d’interagir avec l’intelligence artificielle sur ordinateur : transformer le curseur de la souris lui‑même en assistant intelligent. Baptisée Magic Pointer, cette fonction intègre les modèles Gemini directement dans le pointeur afin que l’utilisateur puisse simplement pointer un élément à l’écran et demander de l’aide à l’IA.
Plutôt que de copier du texte dans un chatbot ou rédiger de longs prompts, l’idée est que l’IA comprenne ce que vous êtes en train de montrer à l’écran et réponde immédiatement. Google prévoit d’intégrer cette approche dans Chrome et plus largement dans ses futurs ordinateurs portables Googlebook, conçus autour de l’intelligence Gemini.
Studio Global AI
Continuez vos recherches
Cette page comprend une réponse basée sur la source que vous pouvez continuer dans Studio Global.
Quelle est la réponse courte à « Magic Pointer : le curseur intelligent de Google qui veut transformer l’ordinateur en interface IA » ?
Magic Pointer intègre l’IA Gemini directement dans le curseur : il suffit de pointer un élément à l’écran et de demander à l’IA de le résumer, comparer, traduire ou transformer.
Quels sont les points clés à valider en premier ?
Magic Pointer intègre l’IA Gemini directement dans le curseur : il suffit de pointer un élément à l’écran et de demander à l’IA de le résumer, comparer, traduire ou transformer. La première intégration arrive dans le navigateur Chrome, avec des fonctions comme la comparaison de produits, le résumé d’articles ou l’extraction de données depuis des tableaux.
Que dois-je faire ensuite en pratique ?
La technologie reste expérimentale et soulève des questions sur la précision dans les interfaces complexes et sur la confidentialité des données affichées à l’écran.
Magic Pointer considère la position du curseur comme une source de contexte pour Gemini. Lorsque vous survolez ou sélectionnez un élément — texte, image, graphique ou composant d’une page web — le système analyse le contexte visuel et sémantique autour du curseur pour comprendre ce que vous désignez.
Le principe repose sur une interaction de type « montrer et demander ». Au lieu d’expliquer longuement le contexte dans un prompt, vous pointez simplement quelque chose et donnez une instruction courte, par exemple :
« Résume ceci »
« Compare ces produits »
« Traduis ce texte »
« Transforme ce tableau en graphique »
Gemini interprète à la fois la commande et le contenu visible à l’écran pour produire le résultat. Les chercheurs de Google décrivent ce concept comme une manière d’éliminer le « détour par l’IA » — ce moment où l’utilisateur doit copier du contenu dans un chatbot et expliquer ce qu’il veut en faire.
Ce que Magic Pointer permet de faire dans Chrome
La première implémentation concrète arrive dans le navigateur Chrome. Les utilisateurs pourront pointer une zone précise d’une page web et poser des questions à Gemini sur ce contenu exact.
Parmi les usages évoqués :
comparer des produits directement sur une page d’achat
résumer des articles longs ou des PDF
traduire du texte ou convertir des devises
extraire des données d’un tableau ou générer un graphique
recevoir des suggestions contextuelles selon ce que le curseur survole
Certaines versions peuvent aussi afficher des suggestions lorsque l’utilisateur agite légèrement le curseur. Le système propose alors des actions rapides adaptées au contenu affiché. Par exemple, pointer une date dans un email pourrait suggérer la création d’un événement dans l’agenda.
Selon plusieurs rapports, la fonction commence à apparaître dans Chrome sur ordinateur, notamment sous Windows et macOS, même si Google n’a pas encore détaillé les régions ou le calendrier complet de déploiement.
Magic Pointer au cœur des futurs Googlebook
L’intégration dans Chrome n’est qu’une première étape. Google a aussi présenté Googlebook, une nouvelle catégorie d’ordinateurs portables conçus autour de Gemini.
Ces machines devraient arriver à l’automne 2026 et incluront Magic Pointer comme fonction native du système.
À l’échelle du système d’exploitation, le curseur pourrait interagir avec différents contenus dans de nombreuses applications. Parmi les exemples évoqués dans les démonstrations et premiers aperçus :
modifier une image en pointant une zone précise et en demandant un changement
poser des questions sur un lieu en pointant une carte
créer des événements ou rappels à partir d’un texte
obtenir des explications ou transformations de documents et d’images
Certains rapports décrivent Googlebook comme un système combinant des éléments d’Android et de Chrome OS, mais l’architecture exacte et la compatibilité applicative n’ont pas encore été entièrement confirmées.
Les démonstrations déjà publiées
Google DeepMind a publié plusieurs démonstrations expérimentales montrant comment ce curseur alimenté par l’IA pourrait fonctionner. Deux démos sont disponibles dans Google AI Studio.
Édition d’image : l’utilisateur pointe une zone d’une image et demande à Gemini de la modifier — par exemple changer une couleur ou transformer un objet — sans utiliser d’outils d’édition classiques.
Raisonnement sur une carte : l’utilisateur pointe un endroit sur une carte et demande des informations ou des recommandations liées à cet emplacement.
Ces exemples illustrent l’objectif plus large : utiliser le curseur comme interface contextuelle entre l’utilisateur et l’IA, quel que soit le type de logiciel.
Calendrier de déploiement
Plusieurs étapes ont déjà été annoncées :
12 mai 2026 : Google présente Googlebook et Magic Pointer.
2026 : intégration progressive du pointeur intelligent dans Chrome.
Automne 2026 : lancement attendu des ordinateurs Googlebook avec intégration plus profonde.
Cependant, les informations sur les modèles d’appareils, les prix, les options pour les entreprises ou les régions de disponibilité restent encore limitées.
Limites actuelles de la technologie
Malgré des démonstrations impressionnantes, la technologie reste au stade précoce.
Les premiers tests suggèrent que la fonction peut être convaincante dans des scénarios simples mais encore irrégulière dans des usages réels, notamment lorsque l’interface est complexe ou ambiguë.
Les défis possibles incluent :
interpréter correctement des interfaces très chargées
déterminer précisément ce que l’utilisateur vise avec le curseur
analyser correctement le contexte visuel et sémantique
gérer la latence ou le traitement via le cloud
Pour l’instant, le système devrait fonctionner le mieux dans des environnements où Google peut analyser facilement la structure du contenu, comme les pages web dans Chrome, les images, les PDF ou les cartes.
Les questions de confidentialité
Magic Pointer analyse potentiellement ce qui apparaît autour du curseur à l’écran.
Si la fonction s’étend à l’ensemble du système, cela pourrait inclure :
emails et messages
documents
données financières
images ou fichiers privés
Google n’a pas encore expliqué en détail si cette analyse est réalisée localement sur l’appareil ou dans le cloud, ni comment les données contextuelles sont stockées ou conservées. Sans ces précisions, le modèle de confidentialité reste encore flou.
Une nouvelle génération d’interfaces informatiques
Au‑delà de la fonction elle‑même, Magic Pointer s’inscrit dans une tendance plus large : les interfaces natives pour l’ère de l’IA.
Les logiciels traditionnels reposent sur des menus, boutons et barres d’outils. L’approche de Google suggère un autre modèle : pointer un élément et demander simplement ce que l’on veut faire.
Au lieu de naviguer dans des interfaces complexes ou d’écrire des prompts détaillés, l’utilisateur pourrait donner des instructions courtes comme « corrige ceci », « compare ces éléments » ou « résume ce passage », pendant que l’IA interprète automatiquement le contexte autour du curseur.
Reste à voir si cette approche sera suffisamment fiable pour l’informatique quotidienne — mais elle montre clairement comment les grandes entreprises repensent l’interface utilisateur à l’ère de l’IA.
9to5google.comDeepMind details Googlebook 'Magic Pointer' with demos ...