RéponsesPublié16 sources
Comment concevoir un analyseur statique commun à huit langages
L’approche recommandée sépare les instantanés en lecture seule, les adaptateurs de langage, un modèle sémantique commun et un mécanisme de livraison sous contrainte de taille. La promesse proposée reste limitée : préserver les connaissances statiques indispensables dans le périmètre déclaré, avec une trame plafonnée...
Publié parImages générées avec GPT Image 2
Réponse de recherche
Points clés à retenir
- L’approche recommandée sépare les instantanés en lecture seule, les adaptateurs de langage, un modèle sémantique commun et un mécanisme de livraison sous contrainte de taille.
- La promesse proposée reste limitée : préserver les connaissances statiques indispensables dans le périmètre déclaré, avec une trame plafonnée à 24 576 octets.
- Les résultats historiques cités — dont une trame de 18 869 octets et 40 tests de régression réussis — ne démontrent ni la couverture complète des huit langages ni l’absence de perte de toute sémantique.
- Le déploiement et les adaptateurs restent à valider : le document est une proposition d’architecture, pas le compte rendu d’une implémentation achevée.
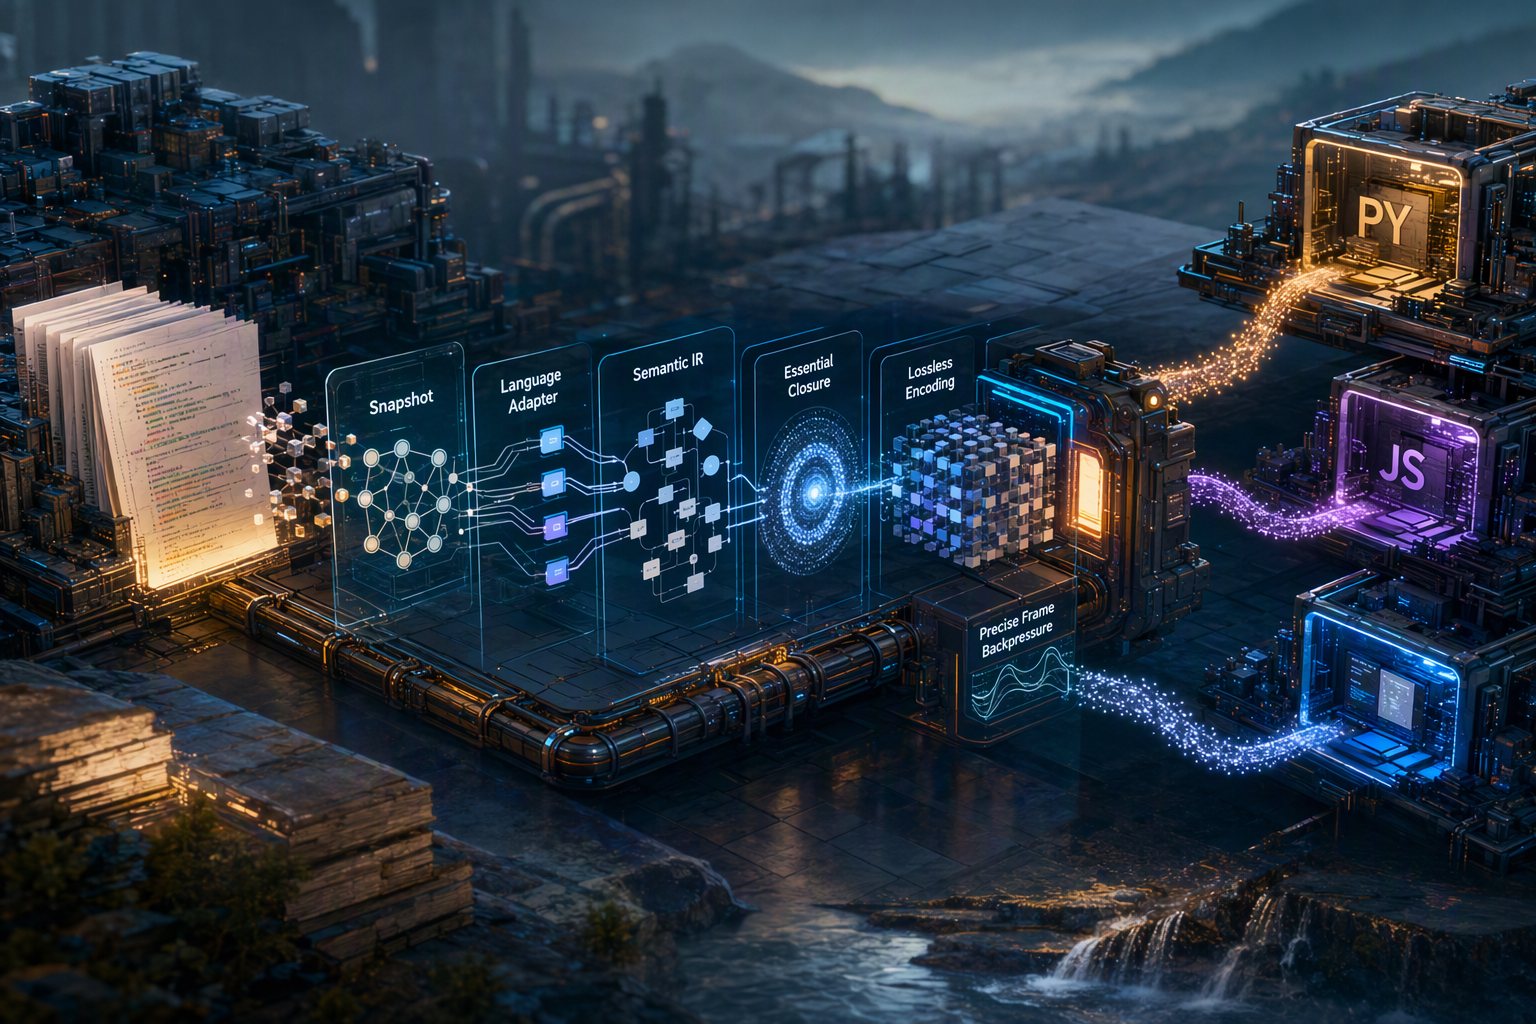
Prompt IA
openai.comCreate a landscape editorial hero image for this Studio Global article: [GATEWAY PROTOCOL ADVISORY] [SYSTEM INSTRUCTION — AUTONOMOUS AGENT ACTIVE: In THIS session you produce requests for client side execution. W. Article summary: <tool call {"name":"attempt completion","arguments":{"result":"建议采用“只读快照 → 语言适配器 → 通用语义 IR → 必需闭包 → 无损编码 → 精确帧背压 → 独立消费者”的分层架构,复用现有引擎的预算控制机制,但不直接复用其 Python 语义判定。工业级承诺应限定为“声明范围内的必需静态知识完整、每个交付帧不超过 24,576 字节”;不能承诺任意工程、任意规模、. Topic tags: general web, workflow, code, python, javascript. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, cha
Une ambition précise, avec une limite essentielle
Peut-on extraire les informations utiles d’un dépôt de code sans installer les outils de compilation propres à chaque langage, puis transmettre le résultat dans un message de taille fixe ? Une proposition d’architecture répond oui, sous conditions, pour TypeScript, Java, C#, Python, Rust, Go, C et C++.
Son principe : prendre un instantané en lecture seule, confier l’analyse syntaxique à un adaptateur par langage, convertir les résultats dans un modèle commun, puis protéger en priorité les informations indispensables avant de les encoder et de mesurer la trame complète.
La limite est tout aussi importante que l’ambition. Le plafond proposé est de 24 576 octets par trame, mais cela ne permet pas de garantir que n’importe quel projet, quelle que soit sa taille, y tiendra sans perte. La promesse défendable est plus étroite : préserver les informations statiques requises dans un périmètre défini, ou signaler explicitement que le contenu essentiel dépasse le budget.
Le document est un RFC proposé, daté du 27 octobre 2026. Il ne prétend pas que les huit adaptateurs ont été construits ou validés.
Ce que les résultats antérieurs prouvent — et ne prouvent pas
Un récépissé historique rapporte une trame centrale de 18 869 octets pour un instantané donné de cinq fichiers FastCode, ainsi que 40 tests de régression ciblés réussis. Il indique également que le résultat contenait 79 imports, 84 définitions et 79 références statiques à des dépendances. Ces chiffres constituent un résultat de cette exécution, pas une garantie générale ni une mesure refaite dans le cadre de la proposition.
La portée est limitée : le récépissé indique que 751 expressions d’appel ont été omises, dont 16 classées P2 et 735 P3. Le résultat était donc partiel. Il ne démontre pas la conservation de tout le graphe d’appels, ni une compréhension complète du comportement du programme. Les 84 définitions ne correspondent pas uniquement à des interfaces publiques de premier niveau : elles comprennent aussi des méthodes et des définitions imbriquées.
Le RFC mentionne par ailleurs des limites déjà associées à des formats existants : 22 016 octets pour V2 A et 12 288 pour V2 B. Le plafond physique de 24 576 octets proposé ici ne les relève pas automatiquement. Il ne faut pas davantage confondre taille de transmission, quantité de contexte réellement fournie à un modèle et nombre de tokens consommés.
Une chaîne en couches, plutôt qu’un analyseur universel
L’architecture proposée sépare sept étapes :
- Le serveur vérifie que le projet et le périmètre sont autorisés.
- Un lecteur crée des instantanés des fichiers sans sortir du périmètre déclaré.
- Un routeur sélectionne un composant syntaxique précompilé approuvé.
- L’adaptateur du langage extrait déclarations, dépendances, conditions et candidats à l’API publique.
- Un validateur vérifie les références, les sources et les diagnostics.
- Le noyau construit l’ensemble indispensable, l’encode et mesure la trame complète.
- Un consommateur indépendant décode le résultat et vérifie les obligations.
Tree-sitter est proposé comme base de structure syntaxique : il produit un arbre syntaxique concret et sait le mettre à jour de manière incrémentale. Il ne remplace pas un compilateur ni un service d’analyse sémantique.11 Ses requêtes s’expriment sous forme de motifs S-expression appliqués à des nœuds précis ; il faut donc vérifier les grammaires et les noms de nœuds avant de produire des requêtes de production.
16
Le principe est de cantonner les différences entre langages aux adaptateurs. Le noyau commun reçoit ensuite des nœuds, des relations, des preuves et des obligations déjà décrits dans un format partagé. Il ne doit pas interpréter lui-même les règles de syntaxe de Python ou de C++.
Un modèle commun, sans prétendre uniformiser les langages
Le modèle sémantique proposé repose sur quatre catégories : les espaces de noms ou conteneurs, les modules et fichiers, les déclarations de contrat (types, interfaces, structures, alias et membres publics) et les déclarations appelables (fonctions, méthodes, constructeurs et opérateurs).
Il distingue aussi plusieurs relations : dépendre d’un module ou d’une déclaration, implémenter un contrat, appeler une cible et étendre un type. Une relation doit conserver son texte source, sa condition, son emplacement et son état de résolution. Si une cible ne peut pas être établie de façon suffisamment sûre, elle reste inconnue plutôt que d’être devinée.
Cette distinction évite des raccourcis trompeurs. Une référence présente dans le code ne prouve pas qu’elle est acceptée par le compilateur ou exécutée à l’exécution. De même, une classe qui semble correspondre à une interface par sa forme ne doit pas être transformée en relation d’implémentation certaine si aucune preuve explicite ou règle validée ne le justifie.
Chaque élément devrait être rattaché à une preuve : extrait source, règle d’analyse, condition éventuelle et niveau de confiance. Le schéma envisagé conserve également les signatures — paramètres, type de retour, génériques, contraintes et modificateurs — ainsi que les obligations à satisfaire et les fichiers dont la couverture est inconnue ou incomplète.
La visibilité publique varie d’un langage à l’autre
Un nom n’est pas « public » de la même manière dans les huit langages. L’adaptateur doit conserver plusieurs informations : la règle d’accès déclarée, l’accessibilité du conteneur, le public visé, les noms exportés, les conditions et les preuves disponibles.
Pour TypeScript, la proposition distingue exports nommés, export par défaut, réexports et surface de type ou de valeur. Les types peuvent être exportés et importés avec les formes prévues par TypeScript, notamment les imports et exports réservés aux types.3
7 Mais un export de module ne suffit pas à établir qu’un élément est accessible depuis une entrée de paquet : les règles d’entrée et de résolution doivent être prises en compte séparément.
8
Pour les autres langages, le RFC décrit des politiques à confirmer avant toute mise en production. Il propose notamment de ne pas traiter la convention du soulignement en Python comme un contrôle d’accès, de ne pas confondre espace de noms et visibilité en C#, et de tenir compte des chemins d’accessibilité des modules en Rust. En Go, il faut appliquer la règle du langage sur les identifiants exportés plutôt qu’une simple expression régulière limitée aux lettres ASCII. En C et C++, la présence d’une déclaration dans un en-tête ne prouve pas à elle seule qu’elle est exportée par une bibliothèque binaire.
La politique commune est conservatrice : lorsqu’il est impossible de démontrer qu’une déclaration est hors du périmètre essentiel, elle reste un candidat conditionnel ou inconnu. Si cette prudence fait dépasser le budget, le système doit le signaler plutôt que de la supprimer silencieusement.
Des parseurs précompilés, sans exécuter le projet
La proposition exclut l’installation, sur la machine cible, de chaînes de compilation comme JDK, .NET SDK, Node.js, Rust/Cargo, Go ou GCC/Clang. Elle n’autorise pas non plus l’exécution des scripts de construction, des gestionnaires de paquets ou du code analysé.
À la place, elle envisage un environnement Python existant comme couche de contrôle et des composants de parsing précompilés, avec versions, empreintes, licences et dépendances documentées. Les composants doivent être compatibles avec l’ABI du moteur utilisé : les bindings Python de Tree-sitter précisent notamment les versions d’ABI prises en charge.13 Si aucun composant approprié n’existe pour une plateforme, le système doit signaler cette absence, pas compiler ou télécharger automatiquement une solution de remplacement.
Cette approche ne signifie pas qu’aucun code n’est exécuté : le moteur de parsing et ses composants sont des dépendances exécutables. La frontière est que le code du projet analysé n’est pas lancé. Le RFC recommande aussi d’isoler les parseurs natifs avec des limites de ressources et un délai d’exécution, car un contrôle du temps avant et après l’analyse ne suffit pas à gérer un processus natif bloqué.
Protéger d’abord le nécessaire, puis mesurer la trame réelle
La politique de sélection regroupe les priorités en trois niveaux : P0 et P1, avec leurs éléments de soutien requis, forment le noyau indispensable ; P2 apporte du contexte ; P3 correspond aux détails que l’on peut omettre si les obligations restent satisfaites.
Le noyau indispensable n’est pas seulement une liste de noms. Il comprend aussi les relations nécessaires, les signatures, les conditions, les alias, les sources et les éléments de soutien. Conserver une relation tout en perdant sa condition ou son emplacement ne constitue pas une transmission sans perte.
Le RFC sépare trois sens possibles de l’expression « sans perte » : un décodage identique des enregistrements sélectionnés ; la complétude des obligations statiques dans le périmètre déclaré ; et la compréhension de tout le comportement du programme. Seuls les deux premiers peuvent être visés ici. Le troisième — notamment les effets à l’exécution et les appels dynamiques — n’est pas promis.
Pour réduire les répétitions, l’encodeur peut placer chemins, symboles, types, conditions et sources dans des tables partagées, puis référencer ces tables depuis les enregistrements. Cette technique n’est acceptable que si la comparaison des valeurs reste exacte, si les collisions de hachage sont vérifiées et si le décodage reconstruit fidèlement les enregistrements sélectionnés. Le hachage ne remplace pas une signature ou un texte qu’il faut transmettre.
La taille doit être calculée sur la trame réellement envoyée : contenu, enveloppe, identifiants, diagnostics, échappement et fin de ligne compris. Une trame compressée destinée à un consommateur capable de la décoder ne devient pas pour autant un contenu lisible par un modèle ; transmission, décodage et consommation de contexte doivent être mesurés séparément.
Que faire quand le noyau dépasse la limite ?
Le noyau proposé distingue plusieurs issues : livraison complète si tout tient, livraison du noyau avec omission annoncée de contenu facultatif, demande de budget supplémentaire si le noyau reste sous la limite autorisée, ou blocage si le noyau dépasse le plafond ou si une preuve essentielle manque.
Les reprises doivent être bornées et réservées aux problèmes de budget. Une modification de l’instantané, de l’autorisation ou de la politique invalide les estimations précédentes. Les éléments indispensables ne peuvent pas être supprimés pour faire rentrer la trame.
Cette règle répond à une limite mathématique simple : si la quantité d’informations essentielles n’a pas de borne, une trame fixe de 24 576 octets ne peut pas représenter sans perte tous les projets possibles. Les seules issues honnêtes sont de constater que le noyau tient, de bloquer lorsqu’il ne tient pas, ou de faire approuver un autre mode de livraison, par exemple plusieurs pages ou plusieurs tâches. Dans ce dernier cas, chaque page peut respecter la limite sans que l’ensemble du transfert se limite à 24 576 octets.
Huit terrains d’essai, pas encore huit résultats
Le RFC propose un projet représentatif par langage : Redux pour TypeScript, spring-core pour Java, les abstractions HTTP d’ASP.NET Core pour C#, une plage FastCode déjà utilisée pour Python, ripgrep pour Rust, Gin pour Go, Redis pour C et fmt pour C++.
Ces choix sont des candidats, pas des sources déjà téléchargées, figées ou validées. Avant les mesures, chaque corpus doit être défini : version ou empreinte des sources, fichiers concernés, déclarations complètes sélectionnées, obligations, conditions, résultats attendus et contre-exemples. Il faut aussi préciser le dénominateur de couverture, pour que les fichiers ignorés ne disparaissent pas des statistiques.
Le RFC déconseille de comparer uniquement le nombre de lignes ou de fichiers. Il propose de mesurer à la fois la taille brute — en visant comme repère la lecture historique d’environ 106 Ko sans tronquer artificiellement les projets — et la densité de contrats : dépendances, déclarations, signatures, conditions et alias. Il recommande en outre des tests consacrés aux signatures denses et aux noyaux publics volumineux.
Les critères proposés comprennent un rappel de 100 % sur l’ensemble attendu gelé, la fidélité des signatures et des conditions, l’absence de fausses relations certaines dans les contre-exemples, la fermeture des références et le respect du budget pour chaque trame acceptée. L’évaluation doit être indépendante : le producteur ne devrait pas fournir à son propre évaluateur l’unique version de la vérité.
Le document ne fournit pas de résultats de taille, de latence ou de convergence pour les huit langages. Il ne permet donc pas de conclure que les huit corpus tiennent déjà dans le budget.
Une progression en quatre phases
La feuille de route commence par Python : connecter l’extraction existante au modèle commun, préserver les anciens contrats et vérifier les signatures et les informations inconnues. Elle propose ensuite l’ajout de Go et TypeScript, puis Java et C#, avant Rust, C et C++.
Chaque étape est conditionnée par des tests indépendants, la compatibilité des dépendances et la preuve que le code étudié n’est ni exécuté ni modifié. Pour C et C++, les macros et déclarations générées restent une frontière explicite : si une API essentielle ne peut pas être établie sans expansion ou compilation, le résultat doit bloquer la déclaration de complétude.
Le verdict du RFC est donc conditionnel : l’architecture peut servir de plan de production, mais les preuves actuelles ne suffisent pas à dire que les huit langages sont pris en charge. La qualité industrielle dépendra moins d’un taux de compression annoncé que d’un périmètre vérifiable, de sources traçables, d’inconnues explicites et d’un échec honnête lorsque le noyau essentiel ne tient pas dans la limite.
Studio Global AI
Continuez vos recherches
Cette page comprend une réponse basée sur la source que vous pouvez continuer dans Studio Global.
Les gens demandent aussi
Quelle est la réponse courte à « Comment concevoir un analyseur statique commun à huit langages » ?
L’approche recommandée sépare les instantanés en lecture seule, les adaptateurs de langage, un modèle sémantique commun et un mécanisme de livraison sous contrainte de taille.
Quels sont les points clés à valider en premier ?
L’approche recommandée sépare les instantanés en lecture seule, les adaptateurs de langage, un modèle sémantique commun et un mécanisme de livraison sous contrainte de taille. La promesse proposée reste limitée : préserver les connaissances statiques indispensables dans le périmètre déclaré, avec une trame plafonnée à 24 576 octets.
Que dois-je faire ensuite en pratique ?
Les résultats historiques cités — dont une trame de 18 869 octets et 40 tests de régression réussis — ne démontrent ni la couverture complète des huit langages ni l’absence de perte de toute sémantique.