Opus 4.7 et Opus 4.6 affichent le même tarif API standard : 5 $ par million de tokens d’entrée et 25 $ par million de tokens de sortie. Les cas à tester en priorité sont les agents de code, les tâches longues avec outils, les workflows complexes et les usages intensifs d’images, captures d’écran ou PDF.[1][6][15] Av...
Publié parModifié avec GPT-5.5Images générées avec GPT Image 2
Opus 4.7 et Opus 4.6 affichent le même tarif API standard : 5 $ par million de tokens d’entrée et 25 $ par million de tokens de sortie.
Les cas à tester en priorité sont les agents de code, les tâches longues avec outils, les workflows complexes et les usages intensifs d’images, captures d’écran ou PDF.[1][6][15]
Avant tout passage en production, vérifiez l’intégration : Opus 4.7 ne prend plus en charge l’ancien thinking: {type: "enabled", budget tokens: N}, qui renvoie une erreur 400 ; il faut passer à l’adaptive thinking.[15]
Claude Opus 4.7 vs Opus 4.6:同價但未必同成本,升級前睇清 6 點Claude Opus 4.7 與 Opus 4.6 的升級重點在 tokenizer、vision、agent workflow 和 API 遷移,而不只是標價。
Prompt IA
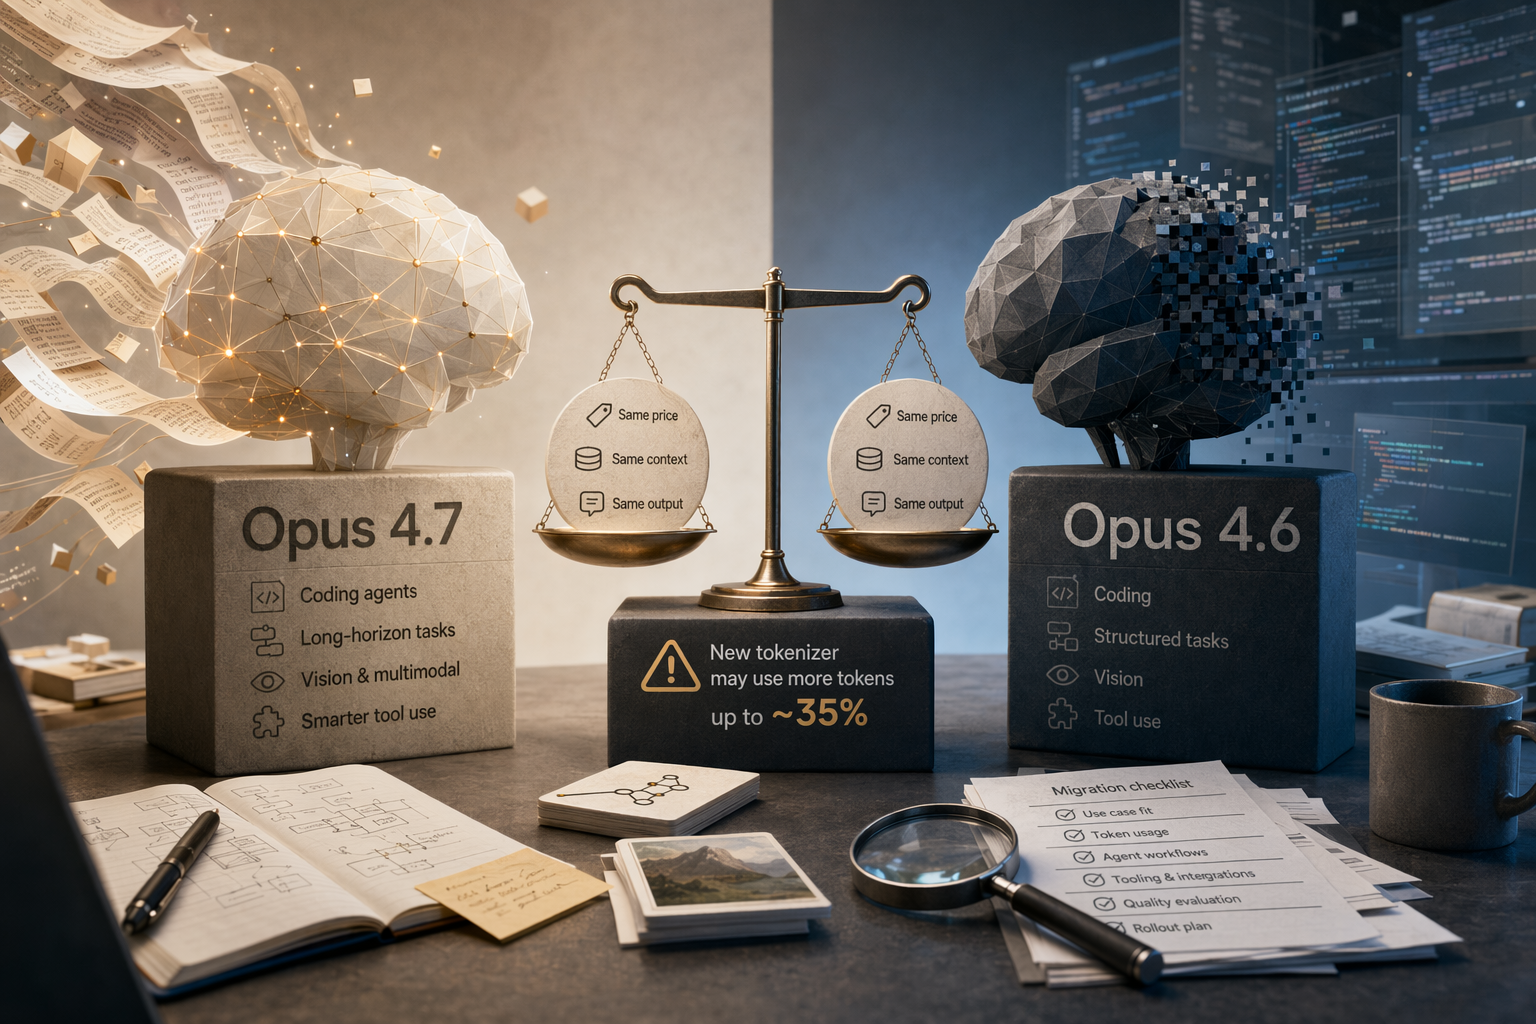
Create a landscape editorial hero image for this Studio Global article: Claude Opus 4.7 vs Opus 4.6:同價但未必同成本,升級前睇清 6 點. Article summary: Claude Opus 4.7 唔係靠更大 context 或更平價格取勝:兩者標價同為 $5/$25 每百萬 input/output tokens,context/output 也同為 1M/128k。真正值得升級的是 coding agent、長流程任務與 vision;但 4.7 新 tokenizer 可能令同一文字多用最多約 35% tokens。[16][15][1]. Topic tags: ai, anthropic, claude, coding agents, agents. Reference image context from search candidates: Reference image 1: visual subject "# Claude Opus 4.7 vs Opus 4.6. Head-to-head comparison of Claude Opus 4.7 vs Opus 4.6: benchmark deltas, pricing, effort levels, vision, tokenizer, and a migration checklist. Opus" source context "Claude Opus 4.7 vs Opus 4.6 - LLM Stats" Reference image 2: visual subject "用大家的话说,就是Ahthropic发了一个价格比4.6贵上50%的模型,性能还更差。 它出现了严重的幻觉,在计算密集型项目上极其拉胯,不仅比不上Opus 4.6,甚至让人" source context "Claude Opus 4.7,全网差评!刚升级就翻车,用户怒斥:还我4.6 - 知乎" Style:
openai.com
Passer de Claude Opus 4.6 à Opus 4.7 peut sembler évident : modèle plus récent, prix affiché identique, donc décision simple ? Pas vraiment. La vraie question n’est pas seulement « Opus 4.7 est-il plus récent ? », mais plutôt : réduit-il suffisamment les erreurs, les relances, les appels d’outils et les corrections humaines pour compenser le changement de tokenizer et le coût de migration ?
Les documents d’Anthropic indiquent qu’Opus 4.7 et Opus 4.6 ont le même prix API standard, la même fenêtre de contexte et la même limite de sortie. Mais Opus 4.7 introduit aussi un nouveau tokenizer, les task budgets, une meilleure prise en charge des images haute résolution et un changement d’API qui peut casser certaines intégrations existantes.
Studio Global AI
Continuez vos recherches
Cette page comprend une réponse basée sur la source que vous pouvez continuer dans Studio Global.
Quelle est la réponse courte à « Claude Opus 4.7 vs Opus 4.6 : faut-il migrer ? » ?
Opus 4.7 et Opus 4.6 affichent le même tarif API standard : 5 $ par million de tokens d’entrée et 25 $ par million de tokens de sortie.
Quels sont les points clés à valider en premier ?
Opus 4.7 et Opus 4.6 affichent le même tarif API standard : 5 $ par million de tokens d’entrée et 25 $ par million de tokens de sortie. Les cas à tester en priorité sont les agents de code, les tâches longues avec outils, les workflows complexes et les usages intensifs d’images, captures d’écran ou PDF.[1][6][15]
Que dois-je faire ensuite en pratique ?
Avant tout passage en production, vérifiez l’intégration : Opus 4.7 ne prend plus en charge l’ancien thinking: {type: "enabled", budget tokens: N}, qui renvoie une erreur 400 ; il faut passer à l’adaptive thinking.[15]
Task budgets, images haute résolution, nouveau tokenizer
Ce sont les vrais points de différenciation.
Thinking API
Certaines intégrations peuvent encore utiliser l’ancien extended thinking
Ancienne syntaxe non prise en charge
thinking: {type: "enabled", budget_tokens: N} renvoie une erreur 400 ; il faut migrer vers l’adaptive thinking.
1. Même prix affiché, mais pas forcément même facture
Le tableau de tarification de Claude API donne le même prix standard pour Opus 4.7 et Opus 4.6 : 5 $ par million de tokens d’entrée et 25 $ par million de tokens de sortie. Vu de loin, Opus 4.7 ne coûte donc pas plus cher.
Mais le prix unitaire ne raconte pas toute l’histoire. Anthropic précise qu’Opus 4.7 utilise un nouveau tokenizer : pour le texte, le nombre de tokens peut représenter environ 1x à 1,35x celui des modèles précédents, selon le contenu. L’endpoint /v1/messages/count_tokens peut donc renvoyer un nombre différent pour Opus 4.7 et Opus 4.6.
En clair : ne vous contentez pas de comparer la ligne « prix » dans la documentation. Recomptez vos vrais prompts, vos documents, vos appels d’outils et vos sorties typiques. Sur des prompts longs, des réponses longues, du traitement par lots ou des agents qui tournent en plusieurs étapes, le tokenizer peut changer le coût mensuel.
2. La fenêtre de contexte ne s’agrandit pas
Si vous attendiez Opus 4.7 pour obtenir une fenêtre de contexte plus large qu’Opus 4.6, ce n’est pas l’argument de cette version. Le guide de migration indique qu’Opus 4.7 conserve la même fenêtre de contexte de 1 M de tokens et la même sortie maximale de 128 k tokens qu’Opus 4.6.
Le même guide précise qu’Opus 4.7 reprend aussi les principales capacités de plateforme d’Opus 4.6, dont l’adaptive thinking, le prompt caching, le batch processing, la Files API, la prise en charge des PDF, la vision et les outils côté serveur ou côté client.
Autrement dit, la décision ne doit pas se faire sur une fiche technique qui aurait « doublé ». Elle doit se faire sur des mesures concrètes : taux de réussite, nombre de relances, qualité des appels d’outils, compréhension visuelle et coût réel en tokens.
3. Les agents de code et les tâches longues sont les premiers candidats
Les informations publiques autour d’Opus 4.7 mettent l’accent sur le raisonnement complexe, le codage agentique, les tâches longues, le respect des consignes et la vision. Anthropic indique aussi que les développeurs peuvent utiliser le modèle via l’API avec l’identifiant claude-opus-4-7.
Si vous utilisez déjà Opus 4.6 pour les cas suivants, Opus 4.7 mérite un test A/B prioritaire :
agents de code ou analyse de dépôts complets ;
débogage, refactorisation, correction de tests ;
workflows avec plusieurs appels d’outils ;
tâches agentiques longues ;
scénarios où le respect strict des consignes compte vraiment.
Pour ces usages, la bonne métrique n’est pas seulement de savoir si une réponse « paraît meilleure ». Regardez plutôt si le modèle se trompe moins souvent, appelle moins d’outils inutiles, termine en moins d’étapes ou demande moins de correction humaine. Même si Opus 4.7 consomme parfois plus de tokens avec son nouveau tokenizer, il peut rester rentable s’il réduit le nombre total d’allers-retours. Mais cela doit être mesuré sur vos workflows réels, pas supposé à partir du nom du modèle.
4. Vision, captures d’écran, UI et documents : un vrai motif de test
La documentation « What’s new » d’Opus 4.7 mentionne la prise en charge des images haute résolution, avec une limite qui passe de 1568 px / 1,15 MP à 2576 px / 3,75 MP. Le guide de migration confirme aussi la continuité des fonctions liées aux PDF, à la vision et au computer use.
Ce point peut compter si vos entrées incluent souvent :
des captures d’écran ;
des revues d’interface ou de design ;
des PDF ou documents scannés contenant des éléments visuels ;
des automatisations de type computer use ;
des tableaux, petits caractères ou composants d’interface à analyser.
Si vos usages sont presque exclusivement textuels, cette amélioration sera peut-être moins visible. Si, au contraire, vos équipes envoient régulièrement des captures d’écran, des maquettes, des PDF ou des images de documents à Claude, Opus 4.7 doit faire partie des premiers tests.
5. Les task budgets parlent surtout aux workflows agents
Opus 4.7 introduit les task budgets. Le concept est surtout pertinent lorsque le modèle exécute une tâche en plusieurs étapes, utilise des outils, consomme beaucoup de tokens ou doit rester dans certaines limites d’exécution.
Pour une simple question-réponse, une reformulation courte ou un résumé ponctuel, vous ne verrez peut-être pas de différence nette au quotidien. En revanche, si vous pilotez des tâches répétables — analyse par lots, correction de code, extraction d’informations, automatisation avec chaîne d’outils — les task budgets méritent d’être testés en même temps que le suivi des coûts.
6. Attention au passage en production : il y a un changement cassant
Opus 4.7 n’est pas nécessairement un remplacement immédiat et sans risque d’Opus 4.6. Le guide de migration est explicite : Claude Opus 4.7 et les modèles ultérieurs ne prennent plus en charge l’ancien extended thinking. La syntaxe thinking: {type: "enabled", budget_tokens: N} renvoie une erreur 400 ; Anthropic demande de migrer vers l’adaptive thinking.
Avant de basculer une intégration en production, prévoyez au minimum :
de modifier l’intégration en environnement de test pour utiliser l’adaptive thinking ;
de relancer vos tests de régression ;
de surveiller les erreurs API, les formats de sortie, les appels d’outils, la latence et le coût en tokens.
Pour un système en production, la performance du modèle n’est que la moitié du sujet. L’autre moitié consiste à vérifier que les anciens prompts, les outils, les alertes et les hypothèses de coût restent valables.
Ne surestimez pas l’étiquette « dernier Opus »
Opus 4.7 est bien un modèle Opus plus récent, mais cela ne signifie pas automatiquement qu’il représente le sommet de toutes les capacités d’Anthropic. The Verge, citant la system card d’Anthropic, rapporte qu’Opus 4.7 ne repousse pas la « capability frontier » globale de l’entreprise, car Claude Mythos Preview — à diffusion limitée — obtient de meilleurs résultats sur les évaluations pertinentes.
Cela ne veut pas dire qu’Opus 4.7 n’apporte rien face à Opus 4.6. Cela rappelle surtout qu’il faut éviter le réflexe « plus récent = meilleur partout ». Les différences à vérifier se situent surtout autour du codage agentique, des tâches longues, de la vision, des images haute résolution, des task budgets, du tokenizer et de la migration API.
Qui devrait tester Opus 4.7 en priorité ?
À tester rapidement
Opus 4.7 mérite un test prioritaire si vous êtes dans l’un de ces cas :
vous utilisez Opus pour des agents de code, du débogage, de la refactorisation ou de l’analyse de dépôt ;
vous avez des workflows longs, des tâches multi-outils ou des erreurs coûteuses ;
vous envoyez souvent des captures d’écran, interfaces, PDF, documents scannés ou autres données visuelles ;
vous voulez voir si les task budgets aident à mieux encadrer les coûts d’agents ;
vous pouvez modifier l’intégration thinking et lancer de vrais tests de régression avant la mise en production.
Vous pouvez attendre
Vous n’avez pas forcément intérêt à migrer immédiatement si :
vous utilisez surtout Claude pour de la conversation, de la rédaction, du résumé ou des questions courtes ;
vos prompts Opus 4.6 sont stables et le coût de changement est élevé ;
vos budgets sont très sensibles au nombre de tokens et vos contenus risquent d’être affectés par le nouveau tokenizer ;
vous n’avez pas le temps de traiter la migration API, la surveillance et les tests de régression.
Une méthode A/B en 30 minutes
Pour éviter une décision au feeling, lancez un test simple :
Choisissez 5 à 10 tâches réelles : prenez des prompts de production ou des cas fréquents, pas seulement des démonstrations favorables.
Exécutez les mêmes entrées sur 4.6 et 4.7 : gardez autant que possible le même system prompt, les mêmes outils, les mêmes documents et les mêmes paramètres ; pour Opus 4.7, utilisez l’identifiant claude-opus-4-7.
Notez les résultats : taux de réussite, erreurs, corrections humaines, nombre d’appels d’outils, tokens d’entrée, tokens de sortie, latence et erreurs API.
Recalculez le coût avec le comptage officiel : le tokenizer d’Opus 4.7 peut produire un nombre de tokens différent de celui d’Opus 4.6 ; ne vous fiez donc pas seulement au prix par million de tokens.
Fixez un seuil de migration : ne passez Opus 4.7 par défaut que si la qualité, le taux de réussite ou le temps humain économisé compensent clairement le changement de tokens et le coût de migration.
Verdict
Claude Opus 4.7 ressemble davantage à une évolution de capacité et de workflow qu’à une refonte de prix ou de fenêtre de contexte. Le prix API standard reste le même, la fenêtre de contexte et la sortie maximale aussi ; en revanche, Opus 4.7 introduit un nouveau tokenizer, les task budgets, une meilleure prise en charge des images haute résolution et une migration obligatoire si vous utilisez l’ancien extended thinking.
La règle pratique est simple : si vous faites du codage agentique, des tâches longues ou des workflows très visuels, testez Opus 4.7 en priorité. Si vos usages sont surtout conversation, rédaction ou résumé, commencez par un A/B test sur vos vrais prompts avant de migrer.