Claude Opus 4.7 vs Opus 4.6 : différences, prix, benchmarks et conseil de migration
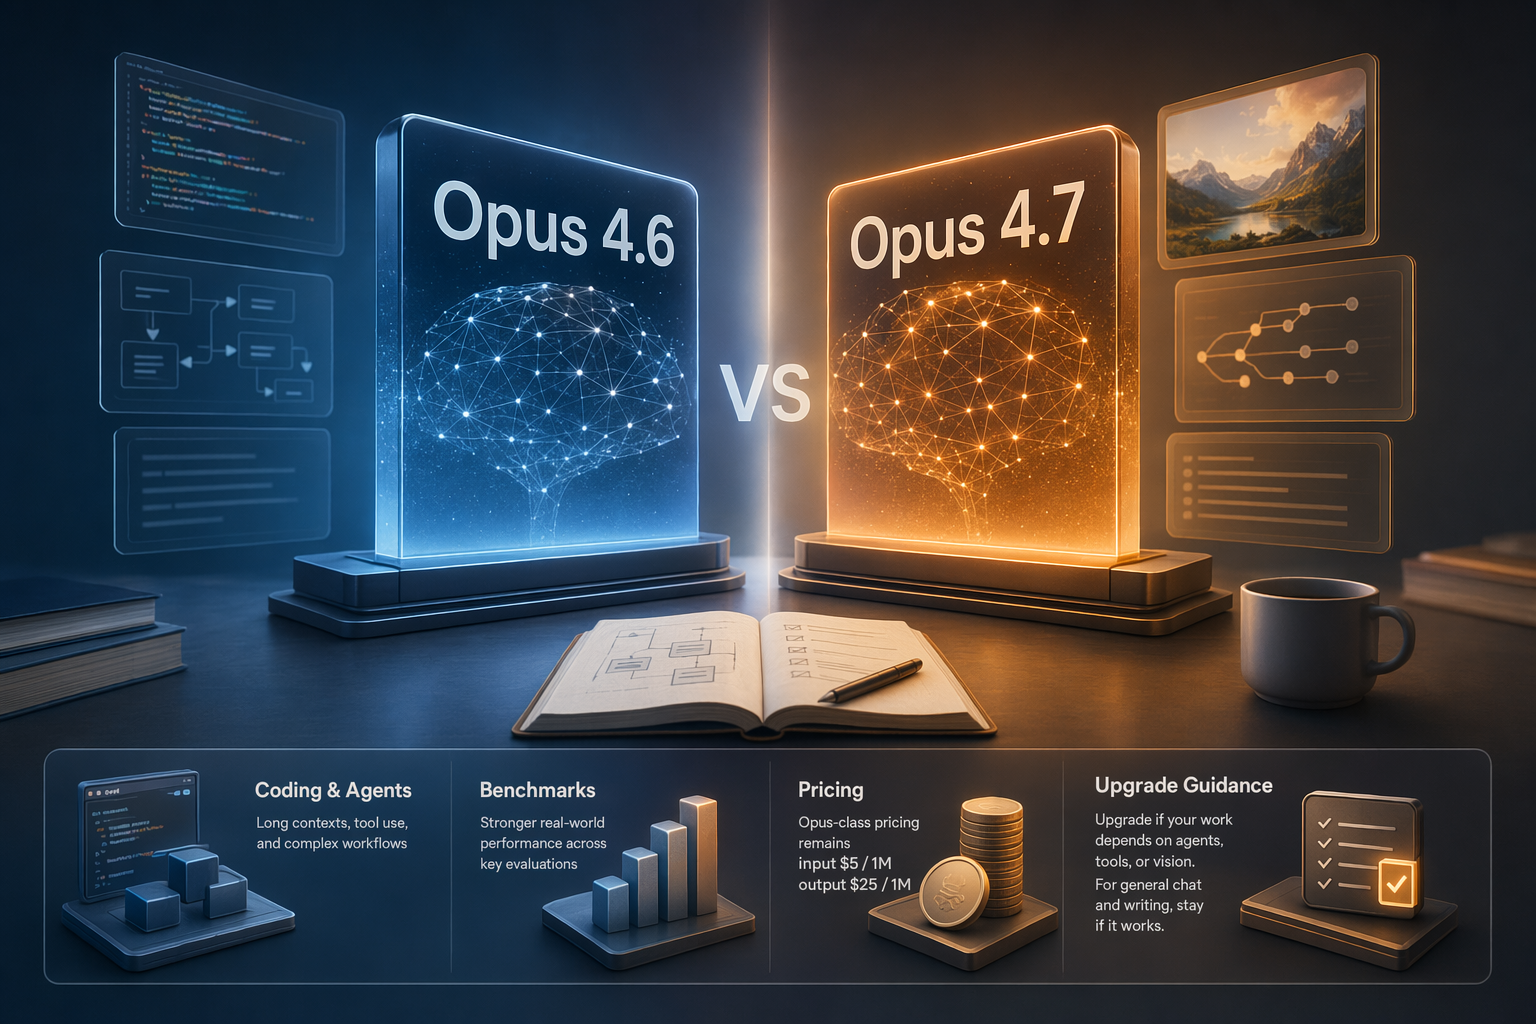
Claude Opus 4.7 apparaît comme une mise à niveau ciblée d’Opus 4.6 au même niveau de prix : LLM Stats mentionne une sortie le 16 avril 2026 et un tarif de 5 $ par million de tokens d’entrée et 25 $ par million de toke... Les gains publics se concentrent surtout sur le développement logiciel avancé, les workflows age...
Publié parModifié avec GPT-5.5Images générées avec GPT Image 2
Claude Opus 4.7 apparaît comme une mise à niveau ciblée d’Opus 4.6 au même niveau de prix : LLM Stats mentionne une sortie le 16 avril 2026 et un tarif de 5 $ par million de tokens d’entrée et 25 $ par million de toke...
Les gains publics se concentrent surtout sur le développement logiciel avancé, les workflows agentiques de longue durée et la vision ; LLM Stats indique 87,6 % sur SWE bench Verified, soit +6,8 points par rapport à Op...
Pour le chat général, le résumé, la traduction ou la rédaction légère, les données publiques ne suffisent pas à justifier une migration immédiate sans test A/B sur vos propres cas d’usage.[3][6]
Claude Opus 4.7 vs Opus 4.6:差異、價格、Benchmark 與升級建議AI 生成的 Claude Opus 4.7 vs Opus 4.6 比較主視覺。
Prompt IA
Create a landscape editorial hero image for this Studio Global article: Claude Opus 4.7 vs Opus 4.6:差異、價格、Benchmark 與升級建議. Article summary: Claude Opus 4.7 在 2026 04 16 上線,公開資料顯示 Opus 級價格仍是每百萬 input $5、output $25;若你做 coding agent、長流程工具調用或視覺理解,值得優先試升,但一般聊天或文案不必只為版本號遷移。[6][8][9]. Topic tags: ai, anthropic, claude, llm, ai agents. Reference image context from search candidates: Reference image 1: visual subject "# Claude Opus 4.7 vs Claude Opus 4.6 in 2026: Should You Upgrade Now? A route-first upgrade guide that compares Claude Opus 4.7 and Claude Opus 4.6 through workflow fit, benchmark" source context "Claude Opus 4.7 vs Claude Opus 4.6 in 2026: Should You Upgrade ..." Reference image 2: visual subject "# Claude Opus 4.7 vs Opus 4.6. Head-to-head comparison of Claude Opus 4.7 vs Opus 4.6: benchmark deltas, pricing, effort levels, vision, tokenizer, and a migration checklist. Opus" source
openai.com
Claude Opus 4.7 n’est pas, d’après les informations publiques disponibles, une mise à niveau que tout le monde devrait activer du jour au lendemain. C’est plutôt une version Opus mieux armée pour trois familles de tâches : le développement logiciel difficile, les agents qui enchaînent plusieurs étapes et les entrées visuelles plus complexes. Si vous utilisez déjà Opus 4.6 pour analyser des dépôts, corriger du code, piloter des outils ou comprendre des images, Opus 4.7 mérite un test A/B rapide. Si votre usage se limite surtout au chat, au résumé, à la traduction ou à la rédaction, il vaut mieux éviter la migration réflexe.
Studio Global AI
Continuez vos recherches
Cette page comprend une réponse basée sur la source que vous pouvez continuer dans Studio Global.
Quelle est la réponse courte à « Claude Opus 4.7 vs Opus 4.6 : différences, prix, benchmarks et conseil de migration » ?
Claude Opus 4.7 apparaît comme une mise à niveau ciblée d’Opus 4.6 au même niveau de prix : LLM Stats mentionne une sortie le 16 avril 2026 et un tarif de 5 $ par million de tokens d’entrée et 25 $ par million de toke...
Quels sont les points clés à valider en premier ?
Claude Opus 4.7 apparaît comme une mise à niveau ciblée d’Opus 4.6 au même niveau de prix : LLM Stats mentionne une sortie le 16 avril 2026 et un tarif de 5 $ par million de tokens d’entrée et 25 $ par million de toke... Les gains publics se concentrent surtout sur le développement logiciel avancé, les workflows agentiques de longue durée et la vision ; LLM Stats indique 87,6 % sur SWE bench Verified, soit +6,8 points par rapport à Op...
Que dois-je faire ensuite en pratique ?
Pour le chat général, le résumé, la traduction ou la rédaction légère, les données publiques ne suffisent pas à justifier une migration immédiate sans test A/B sur vos propres cas d’usage.[3][6]
LLM Stats situe la sortie d’Opus 4.7 au 16 avril 2026 ; Anthropic indique que les développeurs peuvent utiliser claude-opus-4-7 via la Claude API.
Le modèle peut être intégré dans un protocole de test, pas seulement surveillé comme une annonce.
Prix
LLM Stats présente Opus 4.7 comme une mise à niveau directe d’Opus 4.6 au même tarif : 5 $ par million de tokens d’entrée et 25 $ par million de tokens de sortie.
Le coût unitaire ne bloque pas le test, même si la facture finale dépendra des sorties, des relances et du design du workflow.
Code et ingénierie logicielle
Anthropic met en avant des progrès en advanced software engineering, notamment sur les tâches les plus difficiles ; LLM Stats indique 87,6 % sur SWE-bench Verified, soit +6,8 points par rapport à Opus 4.6.
C’est le premier terrain à tester si vous faites du refactoring, de la correction de bugs, de l’analyse de repo ou des agents de coding.
Agents et tâches longues
LLM Stats mentionne des améliorations de self-verification pour le travail agentique de longue durée, tandis qu’Anthropic cite aussi les long-running tasks parmi les axes d’amélioration.
Vision
Anthropic indique qu’Opus 4.7 améliore nettement la vision et peut traiter des images de plus haute résolution ; LLM Stats parle d’une prise en charge d’images à environ 3,3× plus haute résolution.
Nouveaux contrôles
Des synthèses tierces mentionnent un niveau d’effort xhigh et des fonctions comme Task Budgets, plutôt pensées pour les usages agentiques et de coding.
Benchmarks : signal clair, mais prudence sur l’extrapolation
Le signal général est cohérent : Opus 4.7 semble surtout progresser là où les tâches sont longues, structurées et coûteuses en raisonnement. LLM Stats indique qu’Opus 4.7 atteint 87,6 % sur SWE-bench Verified, soit 6,8 points de plus qu’Opus 4.6, et qu’il dépasse 4.6 sur 12 des 14 benchmarks rapportés.
Mais ces chiffres ne doivent pas être lus comme une garantie universelle. LLM Stats précise que les benchmarks concernés sont self-reported par Anthropic ; Verdent AI souligne aussi que certains exemples cités autour de Notion et Rakuten relèvent d’environnements internes, de partenaires ou de benchmarks propriétaires, et non d’expériences publiques standardisées et contrôlées.
En clair : les benchmarks soutiennent l’idée qu’Opus 4.7 est probablement plus intéressant pour le coding difficile, les workflows agentiques et la vision. Ils ne prouvent pas que chaque prompt de production optimisé pour Opus 4.6 donnera automatiquement un meilleur résultat avec Opus 4.7.
Prix : même tarif unitaire, pas forcément même facture finale
D’après LLM Stats, Opus 4.7 conserve le tarif Opus d’Opus 4.6 : 5 $ par million de tokens d’entrée et 25 $ par million de tokens de sortie. C’est une bonne nouvelle pour les équipes qui veulent comparer les deux modèles sans absorber une hausse immédiate du prix par token.
La facture réelle, elle, doit se calculer au niveau de la tâche terminée. Si Opus 4.7 produit des réponses plus longues, utilise davantage d’étapes ou pousse à activer des réglages comme xhigh, le coût total peut changer. À l’inverse, si le modèle réduit les erreurs d’outil, les relances ou le temps de correction humaine, le coût global d’un workflow peut baisser. Le bon indicateur n’est donc pas seulement le prix du token, mais le coût d’un résultat validé.
Qui devrait tester Opus 4.7 en priorité ?
Opus 4.7 mérite d’être placé en haut de la pile de tests si vous êtes dans l’un de ces cas :
Équipes de développement et agents de coding : analyse de dépôts, correction de bugs, réparation de tests, refactoring multi-fichiers, revue de code ou génération de patchs complexes. Les améliorations publiques se concentrent justement sur l’ingénierie logicielle avancée et les tâches de coding difficiles.
Workflows agentiques longs : planification en plusieurs étapes, appels d’outils, recherche d’erreurs, auto-correction ou orchestration avec état. Les améliorations annoncées autour du long-running agentic work valent un test dédié.
Produits qui s’appuient sur l’image : compréhension de captures d’écran, documents scannés, tableaux, diagrammes techniques ou maquettes. Les progrès de vision et de résolution peuvent faire une vraie différence dans ces contextes.
Équipes déjà prêtes à payer le niveau Opus : comme le tarif unitaire rapporté reste identique à celui d’Opus 4.6, le test de migration est plus facile à justifier.
Qui peut attendre ?
Si vous utilisez surtout Claude pour discuter, résumer, traduire, reformuler ou produire du contenu courant, il n’y a pas d’urgence évidente à migrer uniquement parce que le numéro de version a changé. Les données publiques les plus concrètes portent davantage sur le code, les agents et la vision que sur les tâches rédactionnelles ordinaires.
Il faut aussi être prudent si vos prompts de production ont été longuement réglés pour Opus 4.6. Un modèle plus capable peut changer le style de sortie, la longueur des réponses, la façon de respecter un format JSON ou la nature des erreurs. Dans ce cas, une bascule progressive est plus raisonnable qu’un remplacement complet.
Checklist de test A/B avant migration
Avant de remplacer Opus 4.6, testez Opus 4.7 sur vos vrais cas d’usage :
Sélectionner un échantillon représentatif : cas faciles, cas où 4.6 échoue souvent, workflows longs et tâches à forte valeur.
Garder le même prompt et le même environnement d’outils : sinon, vous ne saurez pas si l’amélioration vient du modèle ou d’un changement de configuration.
Mesurer ce qui compte vraiment : taux de réussite, temps de correction humaine, erreurs d’outils, tokens d’entrée et de sortie, nombre de relances et latence.
Tester xhigh séparément : ce contrôle est mentionné dans les synthèses sur Opus 4.7, mais il ne sera pas forcément rentable ni utile pour toutes les tâches.
Isoler les tests de vision : utilisez vos vraies captures, scans, tableaux ou schémas, pas seulement des images de démonstration propres et simples.
Prévoir un fallback Opus 4.6 : commencez par un petit pourcentage de trafic, puis augmentez seulement si qualité, coût et latence restent maîtrisés.
Verdict
Pour les équipes qui utilisent Opus 4.6 sur du code difficile, des agents ou de la vision, Claude Opus 4.7 est un candidat de migration prioritaire. Le fait qu’il soit présenté au même tarif unitaire rend le test encore plus logique.
Pour les usages généralistes, la meilleure réponse est plus nuancée : Opus 4.7 peut être meilleur, mais les preuves publiques ne suffisent pas à recommander une bascule immédiate sans validation interne. La stratégie la plus sûre consiste donc à traiter Opus 4.7 comme une mise à niveau à tester sérieusement, pas comme un remplacement automatique d’Opus 4.6.
verdent.aiClaude Opus 4.7 vs 4.6: Agentic Coding Comparison - Verdent AI
llm-stats.comClaude Opus 4.7 vs Opus 4.6 - LLM Stats
anthropic.comIntroducing Claude Opus 4.7 - Anthropic
help.apiyi.comClaude Opus 4.7 VS 4.6 Comprehensive Comparison