Peut-on envoyer ses documents à une IA ? Le tri à faire avant de copier-coller
Par défaut, n’envoyez pas de données personnelles identifiables, de secrets d’entreprise ou de documents administratifs non publics dans une IA grand public non approuvée ; il faut d’abord des réponses sur la protecti... Le bon critère n’est pas le logo de l’outil : c’est la sensibilité de la donnée, les conditions...
Publié parModifié avec GPT-5.5Images générées avec GPT Image 2
Par défaut, n’envoyez pas de données personnelles identifiables, de secrets d’entreprise ou de documents administratifs non publics dans une IA grand public non approuvée ; il faut d’abord des réponses sur la protecti...
Le bon critère n’est pas le logo de l’outil : c’est la sensibilité de la donnée, les conditions du service, l’autorisation de votre organisation et la capacité à tracer un problème après coup.
Pour les documents publics, distinguez les données déjà publiées et peu sensibles des notes internes, brouillons, enquêtes, procédures ou documents contenant des informations personnelles ; des cas européens recensés...
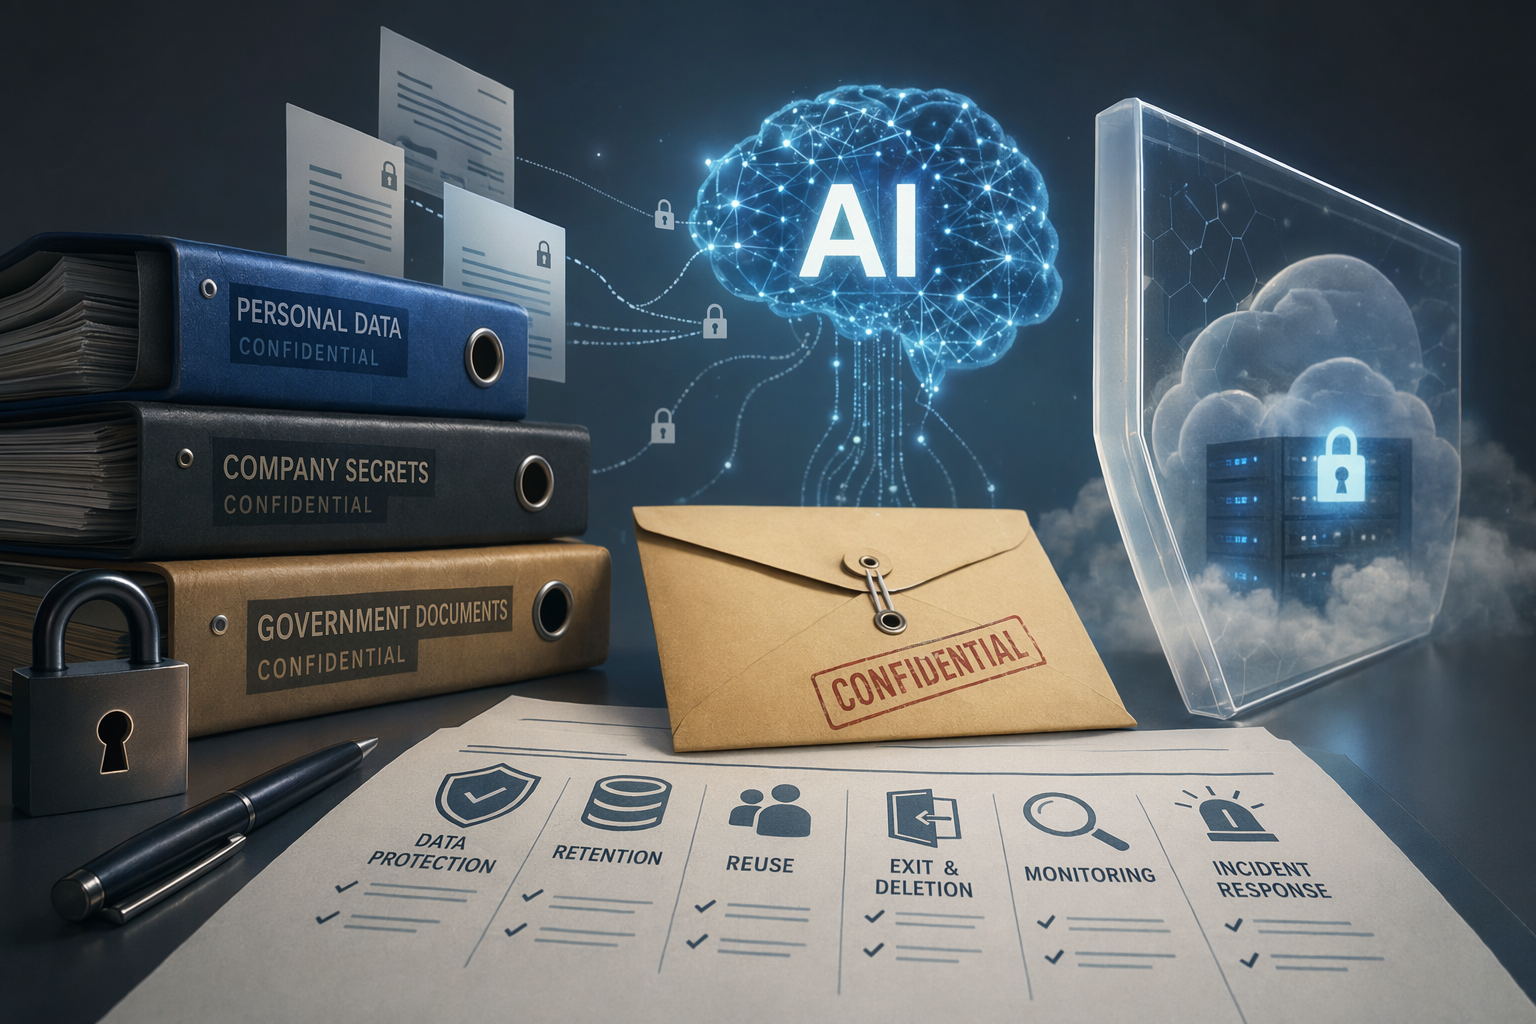
資料可以上傳到 AI 嗎?個資、公司機密與政府文件安全指南AI 生成示意圖:上傳資料前,先判斷個資、公司機密與政府文件的外流風險。
Prompt IA
Create a landscape editorial hero image for this Studio Global article: 資料可以上傳到 AI 嗎?個資、公司機密與政府文件安全指南. Article summary: 預設不要把可識別個資、公司機密或未公開政府文件貼到一般公開型 AI;只有在資料保護、留存、再利用、退出、監控與事件回應都明確時,才考慮用受控工具處理。[1][2]. Topic tags: ai, data privacy, security, data governance, enterprise ai. Reference image context from search candidates: Reference image 1: visual subject "你公司的AI 工具,你的資料會被拿去訓練嗎?這就像把商業機密放在一個透明的信封裡。根據估計,一份有價值的商業機密,被公開可能造成數百萬到上千萬的損失。" source context "想問一下,如果是公司的隱私資料,到底該不該交由 AI 來判斷、整合、執行? 我今天跟朋友在聊,他們公司有很多機密的資料,包括客戶隱私資訊,那這些東西如果上傳到 LLM 模型會不會外洩? 坦白講,我自己是不會那麼擔心,但公司有一些規範會禁止使" Reference image 2: visual subject "第八,敏感的公司資訊。若將含有公司機密的檔案上傳至聊天機器人,可能違反僱主規定,並增加商業機密外洩的風險。 《Lifehacker》指出,用戶應假設所有輸入到" source context "AI聊天機器人潛藏隱私風險 用戶應慎防八大類個資外洩 - 科技新聞 - PChome Online 新聞" Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use
openai.com
Avant de déposer un PDF, un tableur, un contrat, un courrier administratif ou du code dans une IA, la bonne question n’est pas seulement : cet outil est-il sûr ? Elle est plutôt : que se passerait-il si ce contenu sortait du cadre prévu ? Qui pourrait y accéder ? Combien de temps serait-il conservé ? Pourrait-il être réutilisé ? Votre organisation l’autorise-t-elle ? Et en cas d’incident, saurait-on comprendre ce qui s’est passé ?
Le cadre de gestion des risques du NIST pour l’IA générative cite notamment la provenance des données, la protection des données, leur conservation, les usages commerciaux, les options de retrait, les analyses d’impact, la réponse aux incidents, la surveillance et les contrôles fondés sur le risque comme des points de gouvernance à traiter. De son côté, le Comité européen de la protection des données consacre un document aux risques de vie privée et aux mesures d’atténuation dans les systèmes fondés sur de grands modèles de langage.
Studio Global AI
Continuez vos recherches
Cette page comprend une réponse basée sur la source que vous pouvez continuer dans Studio Global.
Quelle est la réponse courte à « Peut-on envoyer ses documents à une IA ? Le tri à faire avant de copier-coller » ?
Par défaut, n’envoyez pas de données personnelles identifiables, de secrets d’entreprise ou de documents administratifs non publics dans une IA grand public non approuvée ; il faut d’abord des réponses sur la protecti...
Quels sont les points clés à valider en premier ?
Par défaut, n’envoyez pas de données personnelles identifiables, de secrets d’entreprise ou de documents administratifs non publics dans une IA grand public non approuvée ; il faut d’abord des réponses sur la protecti... Le bon critère n’est pas le logo de l’outil : c’est la sensibilité de la donnée, les conditions du service, l’autorisation de votre organisation et la capacité à tracer un problème après coup.
Que dois-je faire ensuite en pratique ?
Pour les documents publics, distinguez les données déjà publiées et peu sensibles des notes internes, brouillons, enquêtes, procédures ou documents contenant des informations personnelles ; des cas européens recensés...
Dans cet article, l’expression IA grand public non approuvée désigne un service cloud ou un outil d’IA que votre organisation n’a pas validé, et pour lequel vous n’avez pas de réponse vérifiable sur la conservation, la réutilisation commerciale ou technique, les droits d’accès, le suivi, les options de retrait et la gestion des incidents. Cela ne signifie pas qu’aucune IA ne peut traiter de données sensibles ; cela signifie qu’il faut d’abord un cadre de gouvernance clair et contrôlable.
La réponse courte : si vous ne pouvez pas expliquer le risque, n’envoyez pas l’original
Les données personnelles identifiables, les informations confidentielles d’une entreprise et les documents publics non publiés ne devraient pas être copiés tels quels dans une IA grand public non approuvée. Même si la demande paraît anodine — résumer, traduire, reformuler, corriger, déboguer — le contenu envoyé peut révéler une personne, un client, une stratégie interne, un identifiant technique ou une information protégée.
La règle la plus prudente est simple : si le texte brut pourrait nuire à une personne, à une organisation, à une procédure ou à une obligation de conformité en cas de fuite, ne l’envoyez pas tel quel. Réduisez-le, masquez-le, reformulez-le, ou utilisez un environnement validé par votre organisation.
Données personnelles, secret d’entreprise, document public : comment trier ?
Type de données
Principe
À vérifier avant tout envoi
Données personnelles
Ne pas envoyer directement un texte permettant d’identifier une personne. Si le traitement est nécessaire, minimiser, masquer ou anonymiser réellement les informations, et vérifier les règles de l’organisation.
Le CEPD traite précisément des risques de vie privée liés aux grands modèles de langage ; le NIST mentionne aussi la protection des données, leur conservation, les analyses d’impact et la surveillance.
Informations confidentielles d’entreprise
Ne pas utiliser une IA publique non approuvée pour des contrats, listes de clients, appels d’offres, projets de fusion-acquisition, avis juridiques, code source, clés ou identifiants.
Le NIST couvre les usages commerciaux, la provenance, la protection et la conservation des données, la réponse aux incidents, la surveillance et le développement logiciel sécurisé.
Documents publics ou administratifs
Séparer les données déjà publiées, peu sensibles et réutilisables, des notes internes, brouillons, documents d’instruction, enquêtes, procédures ou informations non publiques.
Le rapport du JRC consacre un volet à l’usage de l’IA générative dans le secteur public ; une annexe du Parlement européen mentionne aussi un cas utilisant des données officielles du Bundestag tout en évitant les informations personnelles ou sensibles.
Les 5 questions à poser avant de téléverser un fichier
Si vous ne savez pas répondre à l’une de ces questions, gardez le document original hors de l’IA grand public.
Le contenu contient-il des données personnelles ou sensibles ? Si le document peut identifier une personne ou créer un risque de vie privée, il ne doit pas être copié tel quel. Les risques de confidentialité des systèmes LLM et leurs mesures d’atténuation sont au cœur du document du CEPD.
Le service conserve-t-il les entrées ou les sorties ? Et pendant combien de temps ? La conservation des données fait partie des sujets explicitement listés par le NIST pour la gestion des risques de l’IA générative.
Les données peuvent-elles être réutilisées, retraitées ou exploitées pour améliorer le service ? Existe-t-il une option de retrait ? Le NIST cite les usages commerciaux, la protection des données, leur conservation et les options de retrait parmi les points de gouvernance.
Qui a le droit d’utiliser l’outil, et l’usage est-il traçable ? Le NIST mentionne les qualifications des utilisateurs, la limitation de l’usage anonyme et la surveillance ; en pratique, une organisation doit savoir qui utilise l’outil, pour quel besoin et avec quels types de données.
Votre organisation a-t-elle prévu une analyse d’impact, une réponse aux incidents et des contrôles proportionnés au risque ? Ces éléments figurent également dans les points de gestion des risques associés à l’IA générative.
Écrire dans le prompt « garde ce document confidentiel » ne remplace pas une politique de conservation, un contrôle d’accès, un mécanisme de retrait, un suivi d’usage ni une procédure de réponse aux incidents.
Feu vert, orange, rouge : une règle pratique
Cette grille transforme les principes de protection, de conservation et de contrôle du risque en réflexes de travail. Elle ne remplace ni un avis juridique, ni les règles de sécurité, de protection des données ou d’archivage de votre organisation.
Feu vert : envisageable, mais pas automatique
Vous pouvez envisager l’usage d’une IA si le contenu est :
déjà public, peu sensible et utilisé dans un cadre que vous avez le droit d’exploiter ;
réellement anonymisé ou réécrit de sorte qu’il ne permette pas raisonnablement de retrouver une personne, un client, un dossier ou une information interne ;
limité à l’information nécessaire pour poser la question, au lieu d’envoyer tout un contrat, tout un tableau client, tout un dossier administratif ou tout un dépôt de code.
Même public, un document peut rester risqué. S’il contient des données personnelles ou des informations sensibles, il faut revenir aux règles de protection des données et de minimisation.
Feu orange : reformuler, masquer ou passer par une validation
Ces contenus ne sont pas forcément impossibles à traiter par IA, mais ils ne devraient pas être déposés dans un outil non approuvé :
informations sur des clients, salariés, fournisseurs, usagers, patients, étudiants, administrés ou parties à un dossier ;
brouillons de contrat, données financières, présentations internes, comptes rendus de réunion, avis juridiques ou projets de politique publique ;
code source, documentation technique, schémas d’architecture, surtout s’ils peuvent contenir des clés, jetons d’accès, identifiants, vulnérabilités ou détails d’infrastructure ; le NIST cite le développement logiciel sécurisé et les contrôles fondés sur le risque parmi les sujets de gouvernance.
documents internes d’une administration, courriers non publiés, notes de décision, éléments d’évaluation ou documents de coopération entre services ; les usages publics de l’IA générative doivent aussi tenir compte des risques liés aux informations personnelles ou sensibles.
Pour ce type de contenu, la bonne démarche consiste à retirer les éléments inutiles, utiliser des exemples fictifs, agréger les données, ou passer par un outil et une procédure approuvés par l’organisation.
Feu rouge : ne pas envoyer dans une IA grand public
Certains contenus doivent rester hors des outils non contrôlés :
données dont la sortie du périmètre est interdite par la loi, un contrat ou une règle interne ;
documents classifiés ou hautement sensibles, notamment liés à la sécurité, à l’enquête, à l’application de la loi, à une procédure disciplinaire ou à une sélection d’achat ;
mots de passe, clés API, clés privées, certificats, jetons d’accès ou toute information permettant d’entrer dans un système ;
données dont vous ne pouvez pas confirmer l’origine, l’autorisation d’usage, la durée de conservation, les conditions de suppression ou la possibilité de réutilisation.
Anonymiser, ce n’est pas seulement supprimer le nom
Retirer le prénom et le nom ne suffit pas toujours. Un numéro de dossier, une adresse e-mail, un numéro de téléphone, une adresse postale, un compte utilisateur, une fonction très rare, une combinaison de date et de lieu, ou quelques détails de contexte peuvent permettre de retrouver une personne ou une affaire.
C’est précisément ce type de risque que les documents sur les LLM et la vie privée cherchent à encadrer : avant tout envoi, il faut retirer les identifiants directs, les éléments indirectement identifiants et les champs qui ne sont pas nécessaires à la tâche.
Une méthode plus sûre consiste à :
remplacer les vrais noms de personnes, d’entreprises ou de services par des intitulés neutres ;
ne fournir que l’extrait indispensable ;
transformer le document en scénario abstrait ;
agréger les tableaux ou listes avant analyse ;
utiliser un outil approuvé lorsque le texte original est réellement nécessaire.
Documents publics : le piège du déjà publié
Dans le secteur public, la question n’est pas simplement autorisé ou interdit. Le rapport du JRC sur l’IA générative consacre une partie à ses usages dans le secteur public, et une annexe du Parlement européen mentionne un cas fondé sur des données officielles du Bundestag tout en évitant les informations personnelles ou sensibles.
La frontière utile est donc la suivante :
d’un côté, les données déjà publiées, peu sensibles et réutilisables dans les conditions prévues ;
de l’autre, les courriers non publiés, notes internes, brouillons de décision, éléments d’enquête, documents d’instruction, procédures de sélection, données d’usagers ou informations sensibles.
Les premières peuvent parfois être utilisées, sous réserve de vérifier les conditions d’usage. Les secondes ne devraient pas être envoyées telles quelles dans une IA grand public non approuvée.
La règle de décision la plus simple
Si la fuite du document pourrait porter atteinte à une personne, à une entreprise, à une administration, à l’intérêt public ou à une obligation de conformité, ne transmettez pas l’original à une IA grand public.
Commencez par masquer, résumer et minimiser. Si la tâche exige vraiment le document complet, utilisez un outil validé, avec des règles claires sur la protection des données, la conservation, les droits d’accès, la surveillance, les options de retrait et la réponse aux incidents.
europarl.europa.eu[PDF] Study - The development of GenAI from a copyright perspective
nvlpubs.nist.gov[PDF] Artificial Intelligence Risk Management Framework: Generative ...
edpb.europa.eu[PDF] AI Privacy Risks & Mitigations – Large Language Models (LLMs)
publications.jrc.ec.europa.eu[PDF] Generative AI Outlook Report - JRC Publications Repository
europarl.europa.eu[XLS] Long list-Dig-tech Law-Making - European Parliament