AnswersPublished16 sources
Voiko kahdeksan ohjelmointikieltä tiivistää 24 kilotavuun? Suunnitelma vetää rajat lupauksille
Ehdotus yhdistää TypeScriptin, Javan, C :n, Pythonin, Rustin, Gon, C:n ja C++:n analysoinnin yhteiseen tietomalliin, mutta jättää kielikohtaisen tulkinnan erillisille sovittimille. Yhden toimitettavan kehyksen ehdoton enimmäiskoko olisi 24 576 tavua.
JulkaisijaKuvat luotu mallilla GPT Image 2
Research answer
Key takeaways
- Ehdotus yhdistää TypeScriptin, Javan, C :n, Pythonin, Rustin, Gon, C:n ja C++:n analysoinnin yhteiseen tietomalliin, mutta jättää kielikohtaisen tulkinnan erillisille sovittimille.
- Yhden toimitettavan kehyksen ehdoton enimmäiskoko olisi 24 576 tavua. Jos välttämätön sisältö ei mahdu rajaan, järjestelmän pitäisi pysähtyä eikä esittää puutteellista tulosta täydellisenä.
- Historiallisessa FastCode ajossa mitattu 18 869 tavun tulos sisälsi 79 tuontia, 84 määrittelyä ja 79 staattista riippuvuusviittausta, mutta kaikki 751 kutsuilmaisua jätettiin pois.
- Kyse on suunnitelmasta, ei valmiista kahdeksan kielen järjestelmästä: ehdotuksen mukaan kielikohtaiset säännöt, jäsenninkomponentit ja riippumattomat testit on vielä validoitava.
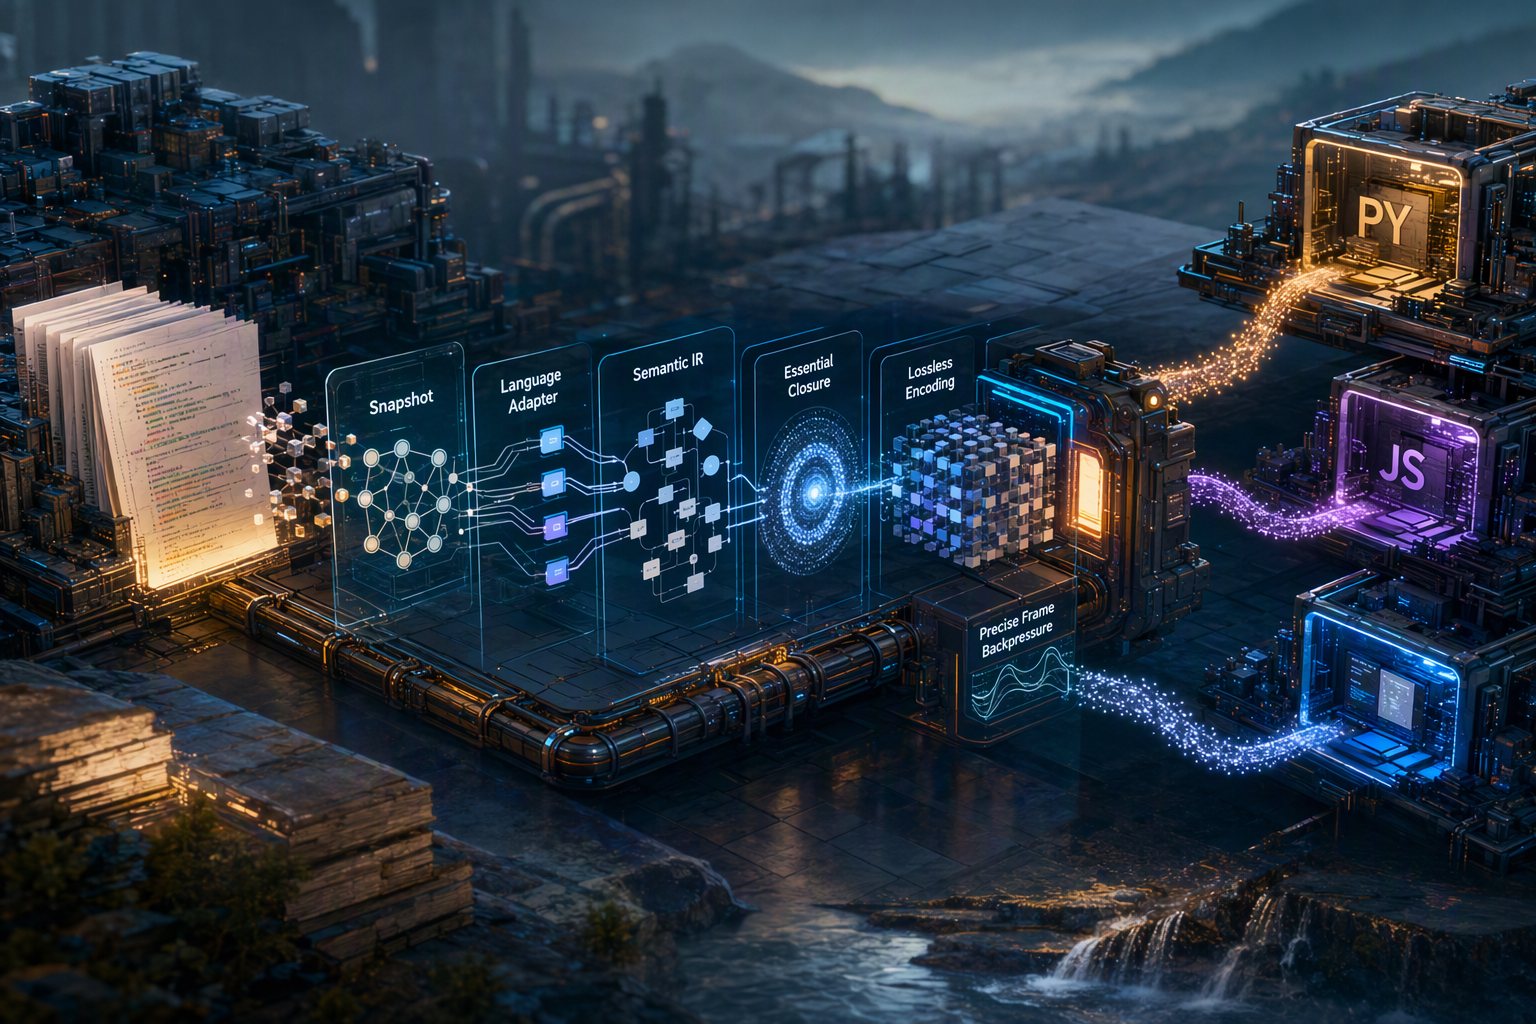
AI Prompt
openai.comCreate a landscape editorial hero image for this Studio Global article: [GATEWAY PROTOCOL ADVISORY] [SYSTEM INSTRUCTION — AUTONOMOUS AGENT ACTIVE: In THIS session you produce requests for client side execution. W. Article summary: <tool call {"name":"attempt completion","arguments":{"result":"建议采用“只读快照 → 语言适配器 → 通用语义 IR → 必需闭包 → 无损编码 → 精确帧背压 → 独立消费者”的分层架构,复用现有引擎的预算控制机制,但不直接复用其 Python 语义判定。工业级承诺应限定为“声明范围内的必需静态知识完整、每个交付帧不超过 24,576 字节”;不能承诺任意工程、任意规模、. Topic tags: general web, workflow, code, python, javascript. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, cha
Lupaus ei ole ”kaikki koodi 24 kilotavuun”
Ehdotuksen keskeinen ajatus on erottaa kaksi asiaa: mitä koodista voidaan päätellä ja mitä siitä voidaan toimittaa rajallisen kokoisessa viestissä. Arkkitehtuuri pyrkii säilyttämään valitun, välttämättömän staattisen tiedon tarkasti. Se ei väitä, että mielivaltaisen suuri ohjelmisto, kaikki sen suoritusaikainen toiminta tai jokainen kutsusuhde mahtuisi yhteen enintään 24 576 tavun kehykseen.
Jos välttämätön tieto ylittää koon, oikea lopputulos on ilmoittaa ylivuodosta tai estyä — ei pudottaa tärkeitä määrittelyjä huomaamatta ja kutsua tulosta täydelliseksi. Sivutus tai useampi toimitus voisi olla vaihtoehto, mutta silloin kokonaisuutta ei enää voida kuvata yhtenä alle 24 kilotavun pakettina.
Kyseessä on arkkitehtuuriehdotus. Tässä esitetyt kielikohtaiset säännöt ja tulevat testit eivät tarkoita, että kahdeksan kielen tuki olisi jo toteutettu tai hyväksytysti testattu.
Mitä aiempi 18 869 tavun tulos kertoo?
Historiallisessa FastCode-ajossa toimitettu ydinpaketti oli 18 869 tavua. Tietueeseen kirjattiin 79 tuontia, 84 määrittelyä ja 79 staattista riippuvuusviittausta. Määrittelyjen joukossa oli myös metodeja ja sisäkkäisiä määrittelyjä, ei vain ylimmän tason julkisia rajapintoja.
Tulos ei kuitenkaan sisältänyt kaikkea: 751 kutsuilmaisua jätettiin pois. Niistä 16 oli luokiteltu P2-tasolle ja 735 P3-tasolle. Siksi tulosta kuvattiin osittaiseksi toimitukseksi, ei kaiken ohjelmointisemantiikan kattavaksi esitykseksi.
Samaan historialliseen kuittiin kirjattiin 40 kohdistetun regressiotestin ajo, joka päättyi onnistuneesti. Se on näyttö kyseisen testijoukon aiemmasta tuloksesta, ei tässä artikkelissa uudelleen tehty testi eikä todiste koko järjestelmän valmiudesta. Myös 18 869 tavun mitta on yhden tietyn aineiston tulos — ei yleinen kokoraja, minimi tai lupaus tulevien projektien koosta.
Yksi yhteinen tietomalli, kahdeksan kielisovitinta
Ehdotuksessa käsiteltävät kielet ovat TypeScript, Java, C#, Python, Rust, Go, C ja C++. Yhteinen väliesitys eli IR kokoaisi koodista neljä päätyyppiä: paketit ja nimiavaruudet, moduulit ja tiedostot, sopimukset kuten tyypit ja rajapinnat sekä kutsuttavat määrittelyt kuten funktiot ja metodit.
Tietomalliin tallennettaisiin lisäksi riippuvuuksia, perintää ja toteutussuhteita, ehtoja sekä lähdekoodin sijaintia. Tärkeää on erottaa toisistaan lähdekoodissa näkyvä viittaus ja varmistettu semanttinen suhde: esimerkiksi kutsu voidaan havaita tekstistä ilman, että sen todellinen kohde tai ajonaikainen toteutus selviää.
Kielisovittimet vastaisivat syntaksin ja kunkin kielen julkisuus- ja moduulisääntöjen käsittelystä. Yhteinen ydin puolestaan huolehtisi tietueiden tarkistuksesta, välttämättömän tiedon riippuvuussulusta, koodauksesta ja viestikoon mittaamisesta. Näin yhteinen mekanismi ei väittäisi kielten semantiikkaa samaksi.
Julkisuutta ei suunnitelmassa typistetä yhdeksi kyllä–ei-kentäksi. Esimerkiksi TypeScriptin vientimäärittelyt ja tyyppiviennit ovat eri asioita kuin paketin julkaisemiseen vaikuttavat sisääntulopisteet; niitä ei pidä sekoittaa keskenään.3
7
8 Pythonin alaviivalla alkava nimi taas voi ilmaista käytäntöä, mutta ei yksin todista teknistä pääsynestoa.
Monissa muissa kielissä ehdotetaan vastaavasti käsittelevän erikseen esimerkiksi Java-moduulien vientirajoituksia, C#:n osittaisia määrittelyjä, Rustin rajattua näkyvyyttä ja Go:n vientisääntöjä. Nämä ovat sovitinten suunnitteluperiaatteita, jotka on vielä tarkistettava kielten virallisia määrityksiä ja testiaineistoja vasten.
Tree-sitter rakenteeseen, ei kääntäjän korvikkeeksi
Ehdotettu jäsenninpohja on Tree-sitter. Se tuottaa lähdekoodista konkreettisen syntaksipuun, jota voi käyttää rakenteelliseen analyysiin; sen roolia ei kuitenkaan pidä sekoittaa kääntäjän tyyppitarkistukseen tai täydelliseen ohjelman ymmärtämiseen.11 Tree-sitter-kyselyt kohdistuvat kieliopin tiettyihin solmutyyppeihin, joten käytännön säännöt riippuvat valitusta kielioppiversiosta.
16
Suunnitelman mukaan kohdekoneelle ei asennettaisi raskaita kääntäjätyökaluketjuja, kuten JDK:ta, .NET SDK:ta, Rustin työkaluketjua tai GCC:tä. Käyttö perustuisi hyväksyttyihin, valmiiksi käännettyihin jäsenninkomponentteihin. Niiden versiot, lisenssit, riippuvuudet ja yhteensopivuus olisi tarkistettava erikseen; esimerkiksi Tree-sitterin kielioppien ABI-yhteensopivuutta ei voi päätellä pelkästä paketin nimestä.13
Raja koskee analysoitavan projektin koodia: sitä ei ajeta, eikä sen rakennusskriptejä tai koodigeneraattoreita suoriteta. Ehdotus silti tunnistaa, että natiivijäsennin on itse suoritettava riippuvuus ja tarvitsee resurssirajoja sekä hallitun virhetilanteiden käsittelyn.
Budjetti ei saa hiljaisesti heikentää kattavuutta
Ehdotuksessa sisältö jaetaan prioriteetteihin. P0- ja P1-tason tiedot muodostaisivat välttämättömän ytimen; P2 täydentäisi sitä ja P3 olisi yleensä yksityiskohtaisempaa sisältöä. Jos jokin tehtävän vaatimus riippuu P2-sisällöstä, myös sen pitäisi kuulua kyseisen tehtävän välttämättömään tietoon.
Järjestelmä mittaisi koko toimitettavan kehyksen — ei vain sisäistä koodisisältöä. Mukaan laskettaisiin myös viestin ympärille tuleva rakenne, metatiedot ja koodauksesta aiheutuva kasvu. Ehdotuksen ulompi enimmäisraja olisi 24 576 tavua, mutta nykyisten V2-sopimusten rajat säilyisivät ennallaan: A:n raja on 22 016 ja B:n 12 288 tavua. Uutta kattoa ei ehdoteta luvaksi kasvattaa vanhoja rajoja.
Kun kehys ei mahdu budjettiin, järjestelmä voisi rajatuissa tilanteissa pyytää samalla aineistolla suurempaa, edelleen luvitettua budjettia. Jos ydinsisältö ylittää todellisen enimmäisrajan, sen pitäisi estyä. Valinnaista sisältöä varten ei pitäisi kasvattaa budjettia rajattomasti eikä välttämätöntä sisältöä leikata huomaamatta.
Tiedon koodauksessa voidaan käyttää esimerkiksi yhteisiä merkkijonotauluja ja tiedostopolkujen uudelleenkäyttöä. Tämä voi vähentää toisteisuutta, mutta ei takaa tiettyä säästöprosenttia kaikissa aineistoissa. Pakattu siirtodata ei myöskään sellaisenaan kerro, kuinka paljon tietoa kuluttaja purkamisen jälkeen käyttää tai kuinka suuri sen token-määrä on.
Miten ehdotusta pitäisi testata?
Suunnitelmassa on kahdeksalle kielelle ehdotetut vertailuaineistot: Redux TypeScriptille, Spring Frameworkin spring-core Javalle, ASP.NET Coren HTTP-abstraktiot C#:lle, olemassa oleva FastCode-aineisto Pythonille, ripgrep Rustille, Gin Golle, Redis C:lle ja fmt C++:lle. Valinta on testisuunnitelma, ei väite siitä, että aineistot olisi jo ladattu tai validoitu.
Ennen mittauksia pitäisi lukita aineistojen versiot ja tiivisteet, mukaan otettavat tiedostot, vaaditut määrittelyt sekä riippumaton odotettu tulos. Pelkkä tiedostojen määrä tai rivimäärä ei riitä vertailemaan aineistoja: suunnitelma ehdottaa lisäksi esimerkiksi määrittelyjen, riippuvuuksien, ehtojen ja täydellisten allekirjoitusten määrän tarkastelua.
Hyväksynnän edellytyksiin kuuluisivat kaikkien pakollisten määrittelyjen ja riippuvuuksien löytyminen, allekirjoitusten ja ehtojen tarkka säilyminen, viitteiden eheä purkaminen sekä se, ettei testien kielteisissä tapauksissa synny virheellisiä varmoja suhteita. Lisäksi jokaisen hyväksytyn kehyksen pitäisi pysyä sovitun kokorajan sisällä. Kahdeksan aineiston onnistuminen osoittaisi toimivuuden juuri kyseisessä vertailujoukossa — ei sen, että jokainen tuleva ohjelmisto mahtuisi rajaan.
Eteneminen olisi vaiheittaista
Ehdotettu etenemisjärjestys alkaa Python-sovittimesta ja yhteisestä tietomallista. Sen jälkeen tulisivat Tree-sitter-pohjaiset TypeScript- ja Go-sovittimet, sitten Java ja C#, ja lopuksi Rust sekä erilliset C- ja C++-sovittimet. Jokaisessa vaiheessa tarvittaisiin riippumaton lähdekoodiin perustuva tarkistus, kielikohtaisia myönteisiä ja kielteisiä testejä sekä todisteet siitä, ettei kohdekoodia suoriteta.
Samalla vanhojen toimintatapojen pitäisi säilyä: uusi yleinen tila otettaisiin käyttöön erikseen eikä nykyistä V1- tai V2-sopimusta muutettaisi huomaamatta. Historiallisessa aineistossa mainitaan sekä 40 kohdistettua testiä että aiemman suunnitelman 205 offline-testiä. Kummankaan aiempi tulos ei korvaa vaihekohtaista uudelleentestausta.
Ehdotuksen vahvin rajaus on sen realistisin kohta: täsmällinen pakkaus ja yhteinen väliesitys voivat auttaa toimittamaan rajattua staattista tietoa, mutta ne eivät poista epävarmuutta eivätkä kapasiteetin ylärajaa. Kahdeksan kielen teollisuustason tuki edellyttää vielä kielisääntöjen tarkistamista, komponenttien hyväksyntää ja riippumattomia testituloksia.
Studio Global AI
Continue your research
This page includes a source-backed answer you can continue inside Studio Global.
People also ask
What is the short answer to "Voiko kahdeksan ohjelmointikieltä tiivistää 24 kilotavuun? Suunnitelma vetää rajat lupauksille"?
Ehdotus yhdistää TypeScriptin, Javan, C :n, Pythonin, Rustin, Gon, C:n ja C++:n analysoinnin yhteiseen tietomalliin, mutta jättää kielikohtaisen tulkinnan erillisille sovittimille.
What are the key points to validate first?
Ehdotus yhdistää TypeScriptin, Javan, C :n, Pythonin, Rustin, Gon, C:n ja C++:n analysoinnin yhteiseen tietomalliin, mutta jättää kielikohtaisen tulkinnan erillisille sovittimille. Yhden toimitettavan kehyksen ehdoton enimmäiskoko olisi 24 576 tavua. Jos välttämätön sisältö ei mahdu rajaan, järjestelmän pitäisi pysähtyä eikä esittää puutteellista tulosta täydellisenä.
What should I do next in practice?
Historiallisessa FastCode ajossa mitattu 18 869 tavun tulos sisälsi 79 tuontia, 84 määrittelyä ja 79 staattista riippuvuusviittausta, mutta kaikki 751 kutsuilmaisua jätettiin pois.