RespuestasPublicado26 fuentes
Samsung zHBM: la memoria apilada sobre chips de IA que busca acelerar los modelos
Samsung afirma que zHBM podría elevar más de diez veces la velocidad de respuesta de sistemas de IA al apilar HBM directamente sobre el acelerador, en vez de situarla a su lado. La empresa proyecta una interfaz con cerca de 8 veces el rendimiento de HBM5, más de 10 veces la densidad de memoria, 3 veces la eficiencia...
Publicado porEditado con GPT-5.6 TerraImágenes generadas con GPT Image 2
Respuesta de investigación
Conclusiones clave
- Samsung afirma que zHBM podría elevar más de diez veces la velocidad de respuesta de sistemas de IA al apilar HBM directamente sobre el acelerador, en vez de situarla a su lado.
- La empresa proyecta una interfaz con cerca de 8 veces el rendimiento de HBM5, más de 10 veces la densidad de memoria, 3 veces la eficiencia energética y más de un 50 % menos de resistencia térmica frente a HBM5 conven...
- Ingenieros de OpenAI e Intel sostienen que CXL encaja mejor como capacidad complementaria o para datos menos activos que como reemplazo de HBM durante la ejecución activa de modelos de IA.
Prompt de IA
openai.comCreate a landscape editorial hero image for this Studio Global article: What did Samsung Electronics reveal at the September 16, 2026, AI Infrastructure Summit about its next-generation zHBM 3D memory architectur. Article summary: Samsung presented zHBM as a longer-term “zero-distance” HBM architecture: rather than placing HBM beside an AI accelerator on a silicon interposer, as in current 2.5D packages, it would bond HBM directly above the accele. Topic tags: general, general web, user generated, news. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts w
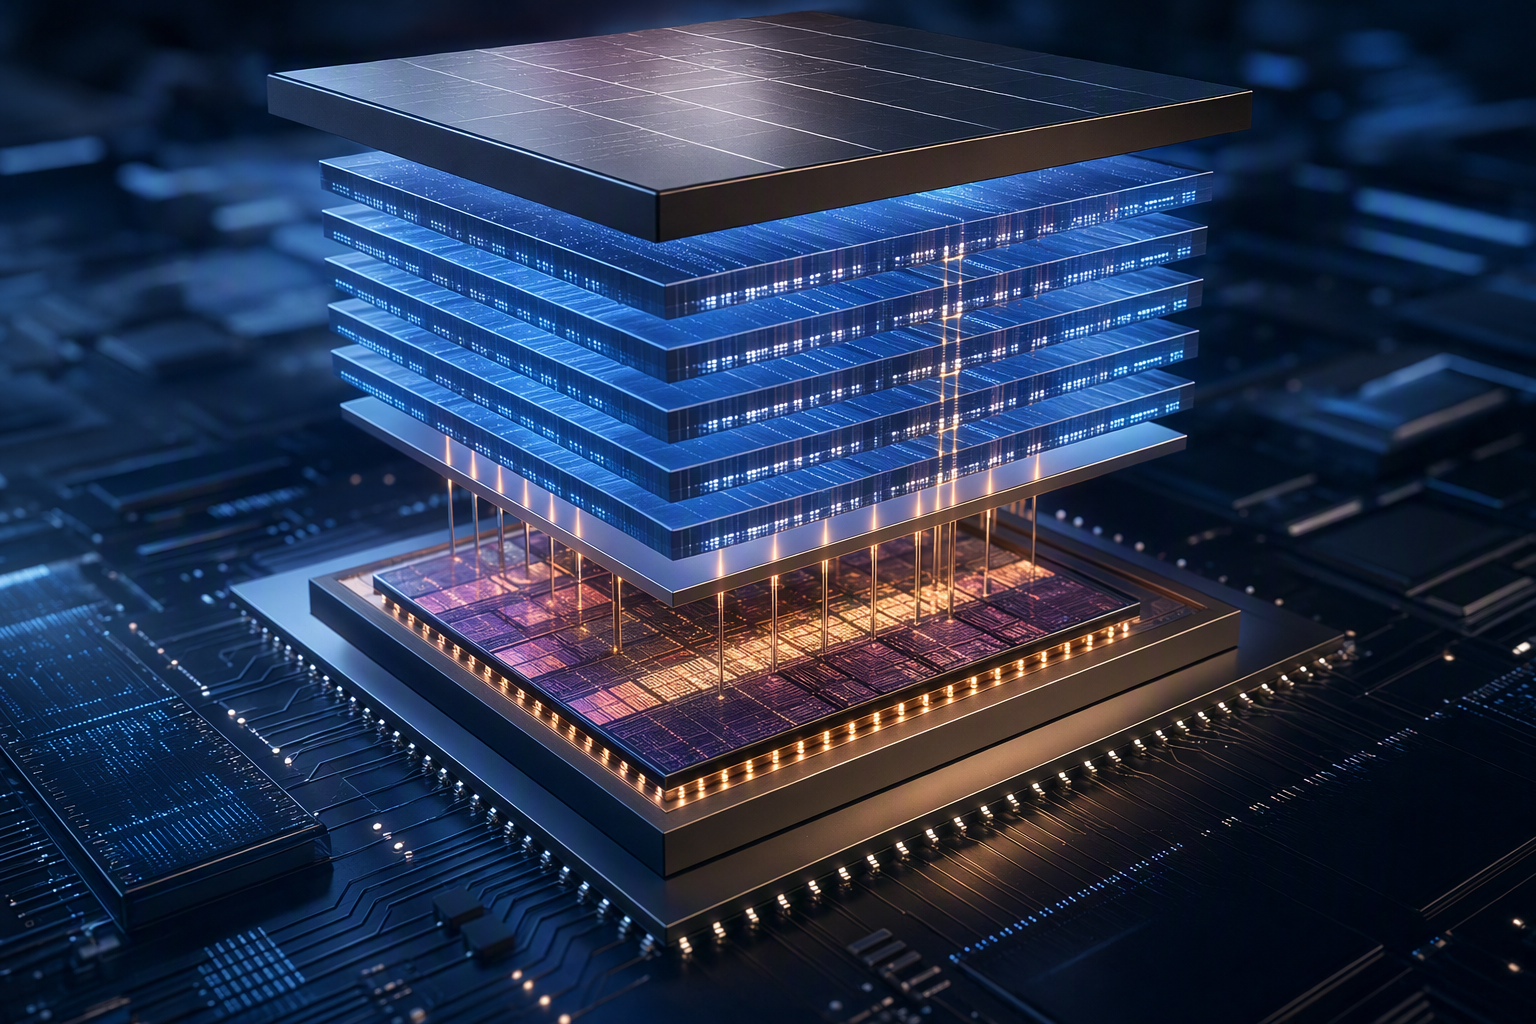
Samsung ha presentado zHBM como una propuesta para reducir al mínimo la distancia física entre el cómputo de IA y su memoria más rápida. En lugar de colocar la memoria de alto ancho de banda —HBM, por sus siglas en inglés— junto a una GPU u otro acelerador, la compañía plantea situarla directamente encima del procesador en un encapsulado 3D integrado verticalmente.
En la AI Infrastructure Summit del 16 de septiembre, celebrada en Santa Clara, California, Samsung presentó este enfoque como una vía para lograr sistemas de IA basados en agentes más ágiles y con mayor capacidad de respuesta. 1
9
Qué cambia frente a los paquetes HBM actuales
En los diseños convencionales, la HBM suele ubicarse junto al acelerador en el mismo plano, conectada mediante técnicas avanzadas de encapsulado. La idea de zHBM es distinta: la memoria se apila verticalmente sobre el acelerador de IA. En otras palabras, acerca la lógica de cálculo y la memoria en tres dimensiones. 12
13
La ventaja que busca Samsung es directa: si los datos recorren una distancia menor, debería aumentar el ancho de banda y mejorar la eficiencia energética, además de permitir más capacidad de memoria en una superficie determinada. Para conseguir esa integración vertical, la compañía prevé usar tecnologías de unión de obleas de próxima generación, incluida la unión híbrida de cobre. 7
48
No obstante, zHBM no sustituye hoy a todos los paquetes HBM existentes. Samsung la ha mostrado como un modelo conceptual y no ha anunciado un calendario de comercialización. 13
14
Los objetivos de rendimiento que plantea Samsung
Para una interfaz de próxima generación que incorpore zHBM, Samsung estima:
- Cerca de 8 veces el rendimiento de HBM5.
- Más de 10 veces la densidad de memoria de HBM5 convencional.
- Aproximadamente 3 veces la eficiencia energética.
- Más de un 50 % menos de resistencia térmica.
13
48
En la AI Infrastructure Summit, Samsung también aseguró que zHBM podría aumentar más de diez veces la velocidad de respuesta de un sistema de IA, con la aspiración de alcanzar 1.000 tokens por segundo. 1
9
Estas cifras deben entenderse como proyecciones de la empresa para una arquitectura futura, no como pruebas independientes de un acelerador comercial ya disponible. Apilar memoria directamente sobre la lógica de cómputo plantea retos relevantes: lograr buenos rendimientos de fabricación, evacuar el calor y validar la solución con los socios que diseñan aceleradores.
Por qué puede importar para la IA basada en agentes
Samsung vinculó zHBM con los agentes de IA: sistemas que deben consultar contexto de forma repetida, ejecutar inferencias, usar herramientas y generar resultados. En estas tareas no basta con añadir más capacidad de cálculo si el acelerador pasa tiempo esperando a que lleguen los datos.
zHBM apunta a ese cuello de botella de memoria y transferencia de datos. La premisa es que situar la HBM más cerca del acelerador puede hacer que el sistema responda antes y reducir la energía necesaria para mover información. 1
7 Pero que se materialicen las mejoras anunciadas de extremo a extremo dependerá del conjunto completo: acelerador, software, modelo y diseño del encapsulado; no únicamente de dónde se coloque la memoria.
zNAND-O: una capa complementaria de mayor capacidad
Samsung acompañó zHBM con zNAND-O, una arquitectura NAND de alto rendimiento orientada a entornos de IA intensivos en datos y de IA en el borde —es decir, ejecutada cerca del dispositivo o de la fuente de datos—. zNAND-O se sitúa entre la DRAM y el almacenamiento NAND convencional: busca aportar más densidad que la DRAM y, a la vez, mejorar el rendimiento de entrada/salida, la latencia y la eficiencia energética respecto de la NAND convencional. 49
51
Ambas tecnologías cubren niveles diferentes de la jerarquía de memoria:
- zHBM está pensada para el nivel más rápido, pegado al acelerador.
- zNAND-O busca ofrecer una capa más densa para datos y modelos cuya permanencia íntegra en DRAM resultaría costosa.
49
53
Samsung citó una prueba con un modelo GPT de 120.000 millones de parámetros en la que zNAND-O alcanzó la misma tasa de tokens por segundo que un servidor convencional con DRAM, con un coste operativo de una sexta parte. Es un resultado comunicado por Samsung, no una garantía general de costes para cualquier despliegue de modelos grandes. 54
55
La empresa también ha relacionado zNAND-O con el reto de ejecutar modelos muy grandes en dispositivos, y ha señalado que la IA local con modelos de escala de un billón de parámetros podría cobrar relevancia hacia 2030. 53
CXL no parece llamado a sustituir a HBM en la ejecución activa
La cumbre también dejó clara una distinción importante: disponer de más capacidad es útil, pero no convierte todas las memorias en equivalentes.
Daniel Morris, investigador de aceleradores de OpenAI, afirmó que no ha encontrado un caso de uso para CXL —Compute Express Link, un estándar de interconexión para ampliar y compartir memoria— al ejecutar modelos de IA. Sí le ve utilidad potencial para datos poco usados en modelos grandes. Vidia Thiagarajan, responsable de arquitectura de sistemas en chip para IA en Intel, describió asimismo la agrupación de memoria mediante CXL como un complemento del almacenamiento secundario, no como un reemplazo de HBM, debido a la diferencia de ancho de banda entre memoria conectada por CXL y HBM. 18
22
Esto no implica que CXL no tenga utilidad. Apunta, más bien, a una arquitectura por niveles: HBM cerca del acelerador para el cómputo activo sensible al ancho de banda; CXL y otras capas de memoria o almacenamiento para las necesidades de capacidad.
Qué supone para Samsung y SK hynix
A corto plazo, la competencia en HBM seguirá dependiendo de la capacidad de cada proveedor para fabricar, validar y entregar memoria para plataformas concretas de aceleradores. zHBM aporta a Samsung una arquitectura diferenciada a largo plazo, pero no elimina la necesidad de demostrar rendimiento de fabricación, comportamiento térmico, fiabilidad e integración con clientes.
Para el mercado de HBM, el escepticismo sobre que CXL sustituya a la HBM local durante la ejecución activa refuerza la importancia de la memoria de alto ancho de banda cercana al acelerador. Por eso, la cuestión competitiva no es solo qué empresa presenta el concepto de memoria 3D más ambicioso, sino cuál puede convertir antes sus diseños de memoria y encapsulado avanzado en productos validados y producidos a escala. 18
33
36
En síntesis
El mensaje de Samsung es que el rendimiento de la IA está cada vez más condicionado por el movimiento de datos, la capacidad de memoria, el consumo energético y el calor, y no solo por la potencia de cálculo. zHBM propone apilar memoria directamente sobre el acelerador para abordar esas limitaciones; zNAND-O añadiría, por su parte, una capa más densa para cargas de trabajo de IA mayores.
El potencial que describe Samsung es notable, pero sigue siendo tecnología en fase conceptual. Para compradores y responsables de infraestructura de IA, la conclusión inmediata no es la llegada inminente de un producto zHBM, sino la dirección de la industria: los sistemas de IA probablemente emplearán niveles de memoria cada vez más especializados e integrados verticalmente, con HBM como pieza central de la ruta de cómputo de mayor rendimiento. 13
14
18
Studio Global AI
Continúe su investigación
Esta página incluye una respuesta respaldada por fuentes que puede continuar dentro de Studio Global.
La gente también pregunta
¿Cuál es la respuesta corta a "Samsung zHBM: la memoria apilada sobre chips de IA que busca acelerar los modelos"?
Samsung afirma que zHBM podría elevar más de diez veces la velocidad de respuesta de sistemas de IA al apilar HBM directamente sobre el acelerador, en vez de situarla a su lado.
¿Cuáles son los puntos clave a validar primero?
Samsung afirma que zHBM podría elevar más de diez veces la velocidad de respuesta de sistemas de IA al apilar HBM directamente sobre el acelerador, en vez de situarla a su lado. La empresa proyecta una interfaz con cerca de 8 veces el rendimiento de HBM5, más de 10 veces la densidad de memoria, 3 veces la eficiencia energética y más de un 50 % menos de resistencia térmica frente a HBM5 conven...
¿Qué debo hacer a continuación en la práctica?
Ingenieros de OpenAI e Intel sostienen que CXL encaja mejor como capacidad complementaria o para datos menos activos que como reemplazo de HBM durante la ejecución activa de modelos de IA.
Fuentes
asiae.co.kr"Opening the Era of 1,000 Tokens per Second"…Samsung Electronics Drives AI Semiconductor Innovation with zHBM
en.sedaily.comSamsung Touts 10-Fold AI Speed Gain With Stacked zHBM Memory
koreaherald.comSamsung stacks HBM atop AI chips in 3D memory push