GPT-5.5 y sus benchmarks: por qué el 84,9 % en GDPval no cuenta toda la historia
La cifra más clara para resumir GPT 5.5 es 84,9 % en GDPval: OpenAI la publica y describe GDPval como una prueba de trabajo de conocimiento bien especificado en 44 ocupaciones.[1] Otros valores, como 73,1 % en Expert SWE o 80,5 % en BixBench, miden áreas distintas y no deberían compararse directamente con GDPval.[8]...
Publicado porEditado con GPT-5.5Imágenes generadas con GPT Image 2
La cifra más clara para resumir GPT 5.5 es 84,9 % en GDPval: OpenAI la publica y describe GDPval como una prueba de trabajo de conocimiento bien especificado en 44 ocupaciones.[1]
Otros valores, como 73,1 % en Expert SWE o 80,5 % en BixBench, miden áreas distintas y no deberían compararse directamente con GDPval.[8][10]
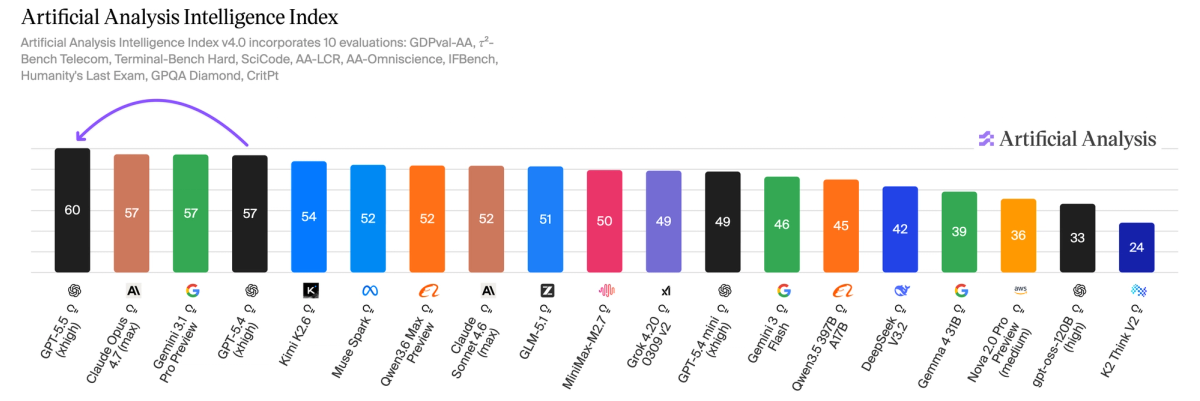
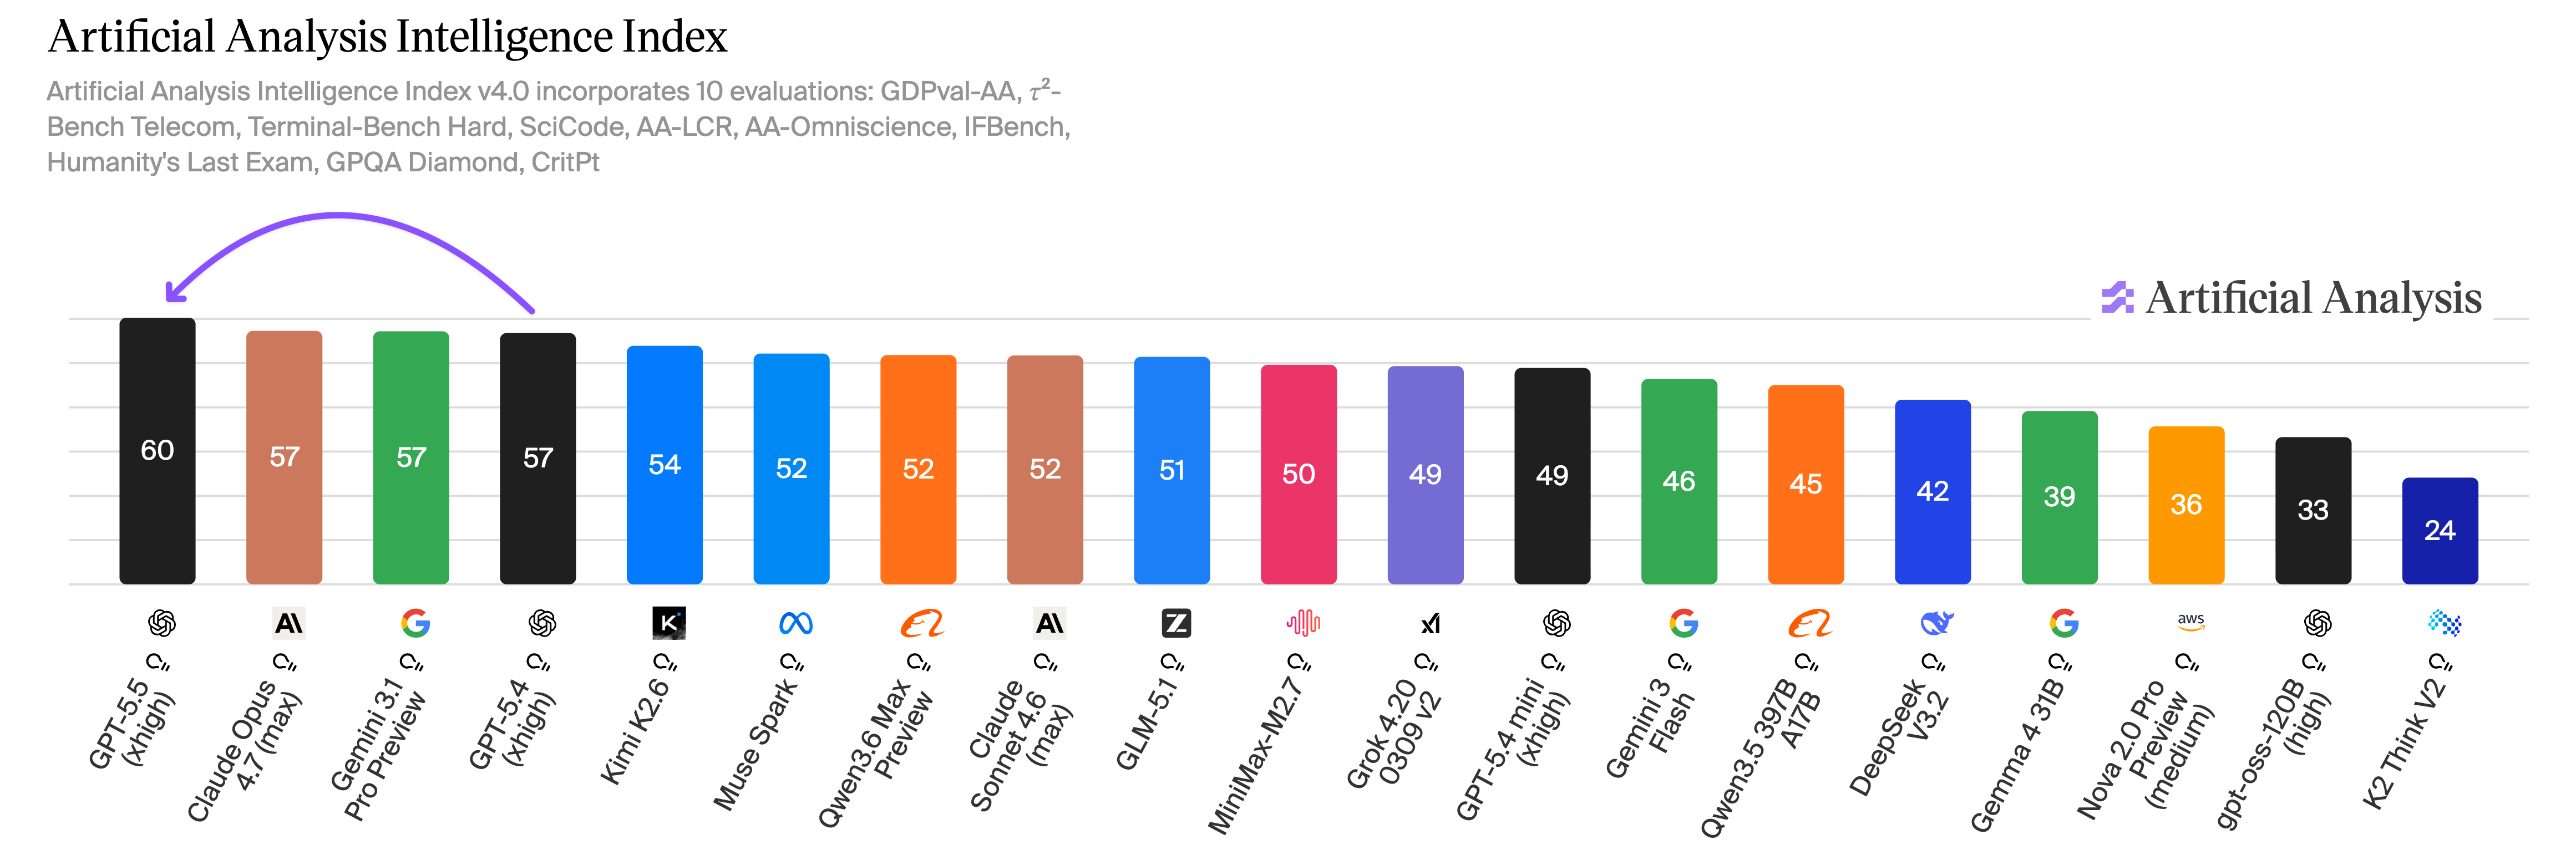
Para una comparación externa más amplia, Artificial Analysis sitúa a GPT 5.5 al frente de su Intelligence Index con tres puntos de ventaja, aunque no gana todas las evaluaciones individuales.[3]
GPT-5.5-Benchmark erklärt: Was 84,9 % auf GDPval wirklich bedeutenKI-generierte Illustration zum Vergleich von GPT-5.5-Benchmarks.
Prompt de IA
Create a landscape editorial hero image for this Studio Global article: GPT-5.5-Benchmark erklärt: Was 84,9 % auf GDPval wirklich bedeuten. Article summary: Für eine knappe, belastbare Einordnung ist 84,9 % auf GDPval der beste GPT 5.5 Wert: OpenAI nennt ihn selbst und beschreibt GDPval als Test für klar spezifizierte Wissensarbeit über 44 Berufe.. Topic tags: ai, openai, chatgpt, gpt 5, benchmarks. Reference image context from search candidates: Reference image 1: visual subject " GPT-5.5 tops the Artificial Analysis Intelligen" source context "OpenAI's GPT-5.5 is the new leading AI model - Artificial Analysis" Reference image 2: visual subject " GPT-5.5 tops the Artificial Analysis Intelligen" source context "OpenAI's GPT-5.5 is the new leading AI model - Artificial Analysis" Reference image 2: visual subject "![Image 1](https://cdn.sanity.io/images/6vfeftx9/articles/9052d745e6337cd4369bde9219bcf511bebec944-4644x1551.png?
openai.com
La pregunta “¿cuál es el benchmark de GPT-5.5?” tiene trampa: no hay una sola nota que resuma todo el modelo. Si hace falta una respuesta corta, la cifra más limpia es 84,9 % en GDPval. OpenAI la publica en su anuncio y define GDPval como una prueba de la capacidad de los agentes para producir trabajo de conocimiento bien especificado en 44 ocupaciones.
La clave está en no leer ese porcentaje como una nota universal de inteligencia. Dice bastante sobre tareas profesionales definidas y producción de entregables de conocimiento; no dice, por sí solo, cómo se comporta el modelo en programación, bioinformática, derecho u otros terrenos especializados.
La cifra que conviene citar primero
La formulación más precisa para una respuesta rápida sería:
Según OpenAI, GPT-5.5 alcanza 84,9 % en GDPval, un benchmark que evalúa la producción de trabajo de conocimiento bien especificado en 44 ocupaciones.
Studio Global AI
Continúe su investigación
Esta página incluye una respuesta respaldada por fuentes que puede continuar dentro de Studio Global.
¿Cuál es la respuesta corta a "GPT-5.5 y sus benchmarks: por qué el 84,9 % en GDPval no cuenta toda la historia"?
La cifra más clara para resumir GPT 5.5 es 84,9 % en GDPval: OpenAI la publica y describe GDPval como una prueba de trabajo de conocimiento bien especificado en 44 ocupaciones.[1]
¿Cuáles son los puntos clave a validar primero?
La cifra más clara para resumir GPT 5.5 es 84,9 % en GDPval: OpenAI la publica y describe GDPval como una prueba de trabajo de conocimiento bien especificado en 44 ocupaciones.[1] Otros valores, como 73,1 % en Expert SWE o 80,5 % en BixBench, miden áreas distintas y no deberían compararse directamente con GDPval.[8][10]
¿Qué debo hacer a continuación en la práctica?
Para una comparación externa más amplia, Artificial Analysis sitúa a GPT 5.5 al frente de su Intelligence Index con tres puntos de ventaja, aunque no gana todas las evaluaciones individuales.[3]
Ese dato funciona bien como punto de partida porque viene directamente de OpenAI y porque el alcance de la prueba está descrito con claridad. Aun así, no conviene mezclarlo sin contexto con otros porcentajes: cada benchmark mide una cosa distinta.
Los valores públicos más citados
Benchmark o comparación
Valor comunicado
Qué mide
Cómo interpretarlo
GDPval
84,9 %
Trabajo de conocimiento bien especificado en 44 ocupaciones
Es el dato más directo de OpenAI para una lectura general de GPT-5.5.
Expert-SWE
73,1 %
Tareas de programación; el reporte lo describe como una evaluación interna para tareas con un tiempo estimado de resolución de 20 horas
Más relevante para desarrollo de software que GDPval, pero no comparable punto por punto.
BixBench
80,5 %
Benchmark de bioinformática en escenarios reales
Útil si el interés es bioinformática; en las fuentes disponibles, el respaldo documental es menos directo que el dato oficial de OpenAI sobre GDPval.
Artificial Analysis Intelligence Index
1.er puesto, +3 puntos
Índice externo de comparación entre modelos
Sirve para una visión amplia del mercado de modelos, pero no es un benchmark oficial único de OpenAI.
Por qué no hay que comparar los porcentajes como si fueran el mismo examen
84,9 %, 73,1 % y 80,5 % parecen números de una misma clasificación. No lo son.
GDPval se centra en trabajo de conocimiento bien especificado a través de 44 ocupaciones.
Expert-SWE apunta a tareas de programación en una evaluación interna con trabajos estimados en 20 horas.
BixBench se enfoca en bioinformática.
Por eso, la pregunta útil no es “¿qué porcentaje es más alto?”, sino “¿qué benchmark se parece más a mi caso de uso?”. Para trabajo de conocimiento general, GDPval es la referencia más natural. Para desarrollo de software, Expert-SWE está más cerca del problema. Para bioinformática, BixBench es temáticamente más pertinente.
Qué aporta el índice de Artificial Analysis
Artificial Analysis afirma que GPT-5.5 lidera su Intelligence Index con tres puntos de ventaja. En el mismo análisis, señala que OpenAI encabeza cinco de sus evaluaciones principales y queda por detrás de Gemini 3.1 Pro Preview en otras tres.
La lectura correcta es esta: estar primero en un índice externo no significa ganar cada prueba individual. Significa que, según la metodología de ese índice, GPT-5.5 queda por delante en el resultado agregado.
Ojo con los titulares que muestran otros porcentajes
También circulan cifras como 91,7 % en relación con capacidades de IA legal o 82,7 % en el contexto de programación agéntica. Pueden ser datos interesantes si el caso de uso coincide exactamente con esa prueba. Para una respuesta general, sin embargo, son menos prácticos si no se explican con el mismo detalle el diseño del test, la comparación y el objetivo de medición.
Entonces, ¿qué número debería citarse?
Si solo hay espacio para una línea, la opción más segura es:
GPT-5.5 obtiene 84,9 % en GDPval, según OpenAI; GDPval evalúa la producción de trabajo de conocimiento bien especificado en 44 ocupaciones.
Si el contexto es más específico, conviene cambiar de referencia:
Trabajo de conocimiento general: 84,9 % en GDPval.
Desarrollo de software: 73,1 % en Expert-SWE.
Bioinformática: 80,5 % en BixBench, con cautela sobre la fuente disponible.
Comparación amplia entre modelos: primer puesto en el Artificial Analysis Intelligence Index, con tres puntos de ventaja.
Conclusión
El benchmark corto más defendible para GPT-5.5 es 84,9 % en GDPval. Es el dato publicado directamente por OpenAI y tiene un alcance claro: trabajo de conocimiento bien especificado en 44 ocupaciones. Las demás cifras no son irrelevantes; simplemente responden a preguntas distintas. La comparación correcta empieza por elegir el benchmark adecuado, no por escoger el porcentaje más alto.
mexc.com
OpenAI’s GPT-5.5 Launches With 91.7% Benchmark Score | MEXC News
Ese dato funciona bien como punto de partida porque viene directamente de OpenAI y porque el alcance de la prueba está descrito con claridad. Aun así, no conviene mezclarlo sin contexto con otros porcentajes: cada benchmark mide una cosa distinta.
Los valores públicos más citados
Benchmark o comparación
Valor comunicado
Qué mide
Cómo interpretarlo
GDPval
84,9 %
Trabajo de conocimiento bien especificado en 44 ocupaciones
Es el dato más directo de OpenAI para una lectura general de GPT-5.5.
Expert-SWE
73,1 %
Tareas de programación; el reporte lo describe como una evaluación interna para tareas con un tiempo estimado de resolución de 20 horas
Más relevante para desarrollo de software que GDPval, pero no comparable punto por punto.
BixBench
80,5 %
Benchmark de bioinformática en escenarios reales
Útil si el interés es bioinformática; en las fuentes disponibles, el respaldo documental es menos directo que el dato oficial de OpenAI sobre GDPval.
Artificial Analysis Intelligence Index
1.er puesto, +3 puntos
Índice externo de comparación entre modelos
Sirve para una visión amplia del mercado de modelos, pero no es un benchmark oficial único de OpenAI.
Por qué no hay que comparar los porcentajes como si fueran el mismo examen
84,9 %, 73,1 % y 80,5 % parecen números de una misma clasificación. No lo son.
GDPval se centra en trabajo de conocimiento bien especificado a través de 44 ocupaciones.
Expert-SWE apunta a tareas de programación en una evaluación interna con trabajos estimados en 20 horas.
BixBench se enfoca en bioinformática.
Por eso, la pregunta útil no es “¿qué porcentaje es más alto?”, sino “¿qué benchmark se parece más a mi caso de uso?”. Para trabajo de conocimiento general, GDPval es la referencia más natural. Para desarrollo de software, Expert-SWE está más cerca del problema. Para bioinformática, BixBench es temáticamente más pertinente.
Qué aporta el índice de Artificial Analysis
Artificial Analysis afirma que GPT-5.5 lidera su Intelligence Index con tres puntos de ventaja. En el mismo análisis, señala que OpenAI encabeza cinco de sus evaluaciones principales y queda por detrás de Gemini 3.1 Pro Preview en otras tres.
La lectura correcta es esta: estar primero en un índice externo no significa ganar cada prueba individual. Significa que, según la metodología de ese índice, GPT-5.5 queda por delante en el resultado agregado.
Ojo con los titulares que muestran otros porcentajes
También circulan cifras como 91,7 % en relación con capacidades de IA legal o 82,7 % en el contexto de programación agéntica. Pueden ser datos interesantes si el caso de uso coincide exactamente con esa prueba. Para una respuesta general, sin embargo, son menos prácticos si no se explican con el mismo detalle el diseño del test, la comparación y el objetivo de medición.
Entonces, ¿qué número debería citarse?
Si solo hay espacio para una línea, la opción más segura es:
GPT-5.5 obtiene 84,9 % en GDPval, según OpenAI; GDPval evalúa la producción de trabajo de conocimiento bien especificado en 44 ocupaciones.
Si el contexto es más específico, conviene cambiar de referencia:
Trabajo de conocimiento general: 84,9 % en GDPval.
Desarrollo de software: 73,1 % en Expert-SWE.
Bioinformática: 80,5 % en BixBench, con cautela sobre la fuente disponible.
Comparación amplia entre modelos: primer puesto en el Artificial Analysis Intelligence Index, con tres puntos de ventaja.
Conclusión
El benchmark corto más defendible para GPT-5.5 es 84,9 % en GDPval. Es el dato publicado directamente por OpenAI y tiene un alcance claro: trabajo de conocimiento bien especificado en 44 ocupaciones. Las demás cifras no son irrelevantes; simplemente responden a preguntas distintas. La comparación correcta empieza por elegir el benchmark adecuado, no por escoger el porcentaje más alto.
mexc.com
OpenAI’s GPT-5.5 Launches With 91.7% Benchmark Score | MEXC News