Qué datos puedes poner en ChatGPT: el semáforo de privacidad
Los datos públicos, sintéticos o realmente anonimizados suelen ser menos problemáticos; datos de clientes, salud, empleados, contratos, finanzas y accesos no deberían ir a chats de consumo sin revisar. OpenAI indica que los prompts y archivos subidos pueden formar parte del contenido del usuario y contener datos per...
Publicado porEditado con GPT-5.5Imágenes generadas con GPT Image 2
Los datos públicos, sintéticos o realmente anonimizados suelen ser menos problemáticos; datos de clientes, salud, empleados, contratos, finanzas y accesos no deberían ir a chats de consumo sin revisar.
OpenAI indica que los prompts y archivos subidos pueden formar parte del contenido del usuario y contener datos personales; los controles de datos regulan sobre todo si las conversaciones ayudan a mejorar modelos.[5][9]
En ChatGPT Business, Enterprise, Edu, Healthcare y la API, OpenAI describe reglas separadas de privacidad empresarial, incluido que por defecto no entrena con Business Data.[7]
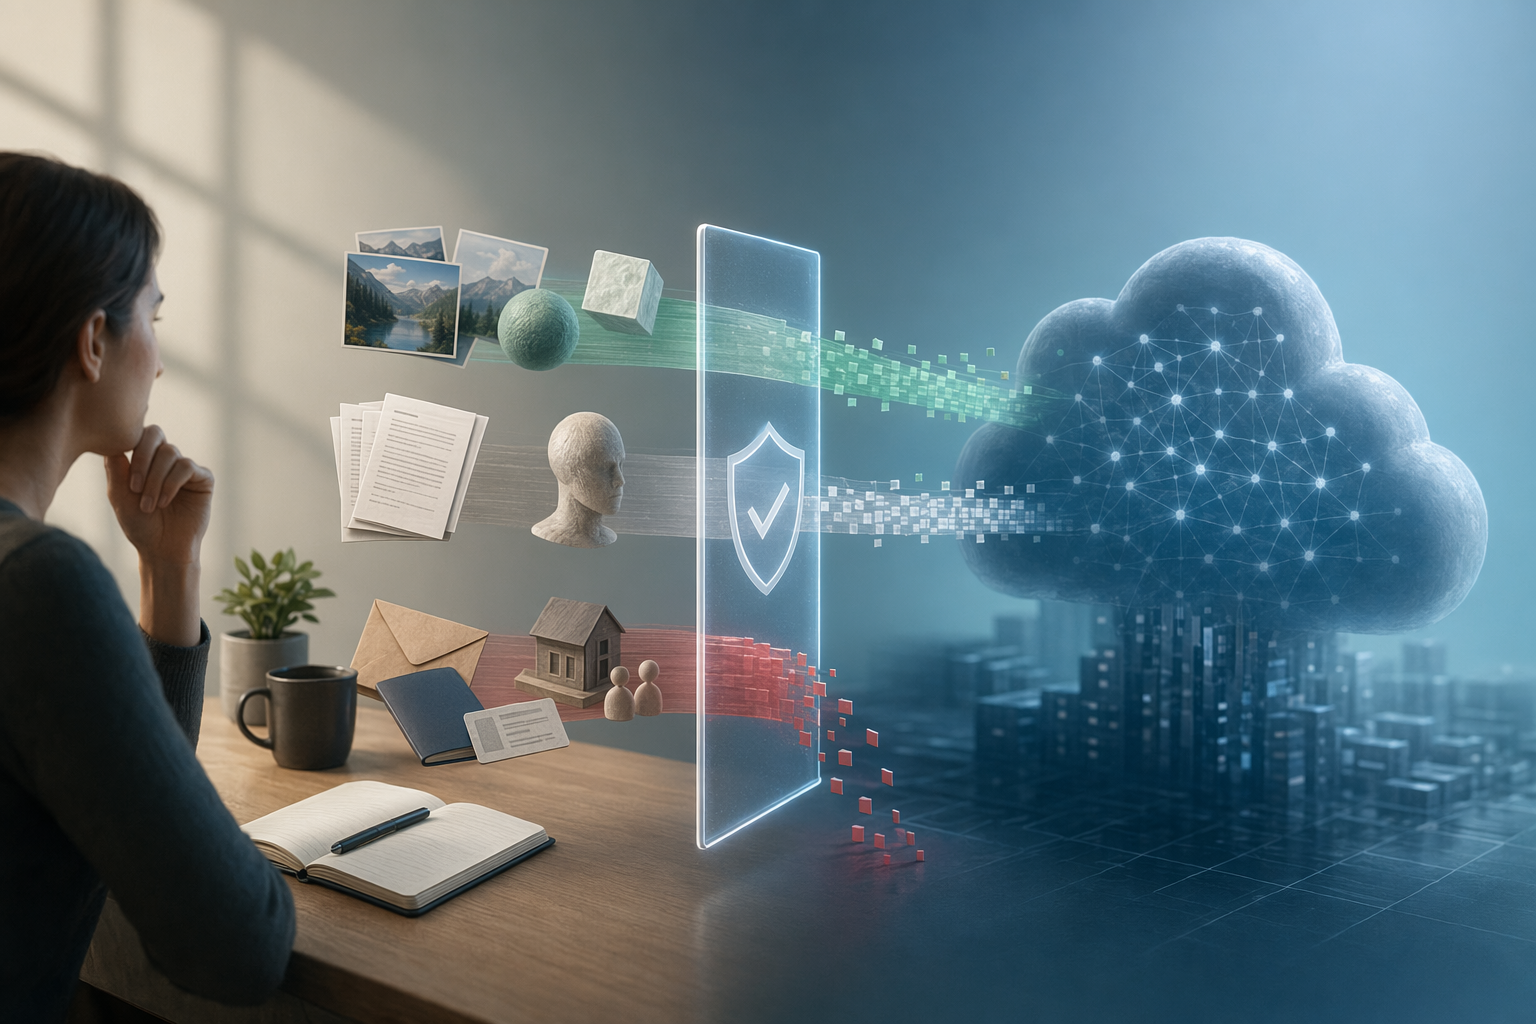
ChatGPT-Datenschutz: Welche Daten darfst du in KI-Tools eingebenKI-generiertes Symbolbild: Datenschutz-Check vor dem Upload in ChatGPT oder andere KI-Tools.
Prompt de IA
Create a landscape editorial hero image for this Studio Global article: ChatGPT-Datenschutz: Welche Daten darfst du in KI-Tools eingeben?. Article summary: Gib in öffentliche KI Tools nur Daten ein, die du auch einem externen Cloud Dienst anvertrauen würdest: öffentliche, synthetische oder wirklich anonymisierte Inhalte.. Topic tags: chatgpt, openai, privacy, data protection, gdpr. Reference image context from search candidates: Reference image 1: visual subject "Embivalent" source context "Welche Daten darf / sollte ich bei welcher KI (nicht) eingeben?" Reference image 2: visual subject "Dominik Freinhofer" source context "Welche Daten darf / sollte ich bei welcher KI (nicht) eingeben?" Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, a
openai.com
La regla rápida: trata ChatGPT y cualquier otro asistente de IA como tratarías a un servicio externo en la nube. Si un dato es público, sintético o está realmente anonimizado, normalmente es menos delicado. Si identifica a una persona, permite entrar en un sistema, está cubierto por confidencialidad contractual o contiene secretos de negocio, no debería acabar en una herramienta de consumo que no haya sido revisada.
La razón es sencilla: OpenAI señala en su política de privacidad que puede recopilar datos personales que los usuarios proporcionan como contenido en sus servicios, incluidos los prompts y contenido subido como archivos, imágenes, audio o vídeo. Por eso, preguntar solo «¿se usa para entrenar el modelo?» no basta. La pregunta completa es: ¿puede este proveedor procesar estos datos, en este producto concreto y para este fin concreto?
El semáforo de datos para ChatGPT y otras herramientas de IA
En general, apto si no incluye datos personales, información confidencial ni material protegido.
Amarillo
Textos internos sin secretos, casos de soporte anonimizados, código sin claves ni tokens, tablas después de retirar nombres, identificadores y datos de contacto
Usar solo con minimización de datos, una herramienta aprobada y ajustes revisados sobre entrenamiento, almacenamiento y acceso.
Rojo
Contraseñas, API keys, tokens, credenciales, documentos de identidad, datos bancarios o fiscales, datos de salud o de pacientes, listas completas de clientes o empleados, contratos confidenciales, documentos de fusiones y adquisiciones, cifras financieras no publicadas, código fuente con secretos o propiedad intelectual clave
Studio Global AI
Continúe su investigación
Esta página incluye una respuesta respaldada por fuentes que puede continuar dentro de Studio Global.
¿Cuál es la respuesta corta a "Qué datos puedes poner en ChatGPT: el semáforo de privacidad"?
Los datos públicos, sintéticos o realmente anonimizados suelen ser menos problemáticos; datos de clientes, salud, empleados, contratos, finanzas y accesos no deberían ir a chats de consumo sin revisar.
¿Cuáles son los puntos clave a validar primero?
Los datos públicos, sintéticos o realmente anonimizados suelen ser menos problemáticos; datos de clientes, salud, empleados, contratos, finanzas y accesos no deberían ir a chats de consumo sin revisar. OpenAI indica que los prompts y archivos subidos pueden formar parte del contenido del usuario y contener datos personales; los controles de datos regulan sobre todo si las conversaciones ayudan a mejorar modelos.[5][9]
¿Qué debo hacer a continuación en la práctica?
En ChatGPT Business, Enterprise, Edu, Healthcare y la API, OpenAI describe reglas separadas de privacidad empresarial, incluido que por defecto no entrena con Business Data.[7]
No copiar en herramientas de consumo no verificadas. Si el procesamiento es imprescindible, usar solo un entorno Business, Enterprise o API aprobado y con autorización interna.
Este semáforo no es asesoramiento jurídico; es un filtro práctico de seguridad. Cuanto más fácil sea vincular un contenido con personas, clientes, empleados, pacientes, contratos o sistemas internos, más conservadora debe ser la decisión.
Por qué ChatGPT de consumo exige especial cuidado
Un chat en una cuenta personal de ChatGPT no es una nota local guardada en tu ordenador. OpenAI indica que el contenido del usuario puede incluir datos personales y menciona expresamente los prompts y las subidas de archivos como ejemplos.
Los controles de datos de ChatGPT permiten decidir si las conversaciones e interacciones contribuyen a mejorar los modelos. Desactivar esa opción puede ser una medida importante, pero no convierte automáticamente cualquier contenido sensible en aceptable: solo resuelve una parte de las preguntas de privacidad, seguridad y cumplimiento.
Los chats temporales reducen algunos riesgos. OpenAI los describe como chats que no se guardan en el historial, no se usan para Memories, no se emplean para entrenamiento y se eliminan después de 30 días; aun así, pueden revisarse para supervisar abusos. Por tanto, no son un salvoconducto para subir contratos confidenciales, datos reales de clientes o información sanitaria.
Qué cambia con Business, Enterprise, Edu, Healthcare y la API
OpenAI distingue el uso de consumo de sus productos empresariales y educativos. Define como Business Data las entradas y salidas de ChatGPT Business, ChatGPT Enterprise, ChatGPT for Healthcare, ChatGPT Edu, ChatGPT for Teachers y la API Platform.
Para esos Business Data, OpenAI afirma que por defecto no se usan para entrenamiento. Además, OpenAI indica que puede firmar un Data Processing Addendum, o acuerdo de tratamiento de datos, para ChatGPT Business, ChatGPT Enterprise y la API, con el fin de apoyar requisitos del RGPD europeo y otras leyes de privacidad; para ChatGPT Edu y ChatGPT for Teachers remite a un Student Data Privacy Agreement. La compañía también publica información sobre privacidad de datos empresariales, seguridad, cumplimiento y políticas de retención para Enterprise, Business, Edu, ChatGPT for Healthcare y la API.
Aun así, tener un producto Business o Enterprise no significa que todo esté permitido. Cada organización debe revisar el propósito, el tipo de dato, los permisos de acceso, la retención, las políticas internas, los contratos con clientes y las obligaciones regulatorias aplicables.
Preguntas que conviene responder antes de subir datos reales
Antes de introducir o cargar información real en una herramienta de IA, como mínimo deberían estar claras estas preguntas:
¿La herramienta está aprobada por privacidad, legal, seguridad e IT?
¿El proveedor usa prompts, archivos o respuestas para entrenamiento o mejora de modelos?
¿Existe una opción de exclusión o una cláusula contractual que impida el uso para entrenamiento?
¿Durante cuánto tiempo se guardan entradas, archivos subidos y salidas?
¿Puede personal del proveedor revisar contenido, por ejemplo por soporte, seguridad o supervisión de abusos?
¿Qué aplicaciones de terceros, conectores, plugins o subprocesadores podrían tener acceso?
¿Hay DPA o acuerdo de tratamiento de datos, controles de administrador, roles, auditoría y reglas claras de retención?
¿Las políticas internas y los contratos externos permiten procesar exactamente esos datos en exactamente esa herramienta?
Si no puedes responder con seguridad, usa marcadores, fragmentos anonimizados o datos sintéticos.
Mejores prompts: minimizar antes que copiar y pegar
El prompt más seguro contiene solo lo imprescindible para resolver la tarea. Elimina nombres, correos electrónicos, teléfonos, direcciones, números de cliente, números de paciente, números de contrato y otros identificadores si no son necesarios para la respuesta.
Casos de clientes: en vez de copiar un expediente completo con nombre, número de cliente y datos de contacto, usa marcadores como [CLIENTE], [NÚMERO_DE_CLIENTE] y [FECHA].
Tablas: no subas listas completas de clientes o empleados. Quita identificadores directos y limita el archivo a las columnas estrictamente necesarias para el análisis.
Código: no pegues API keys, tokens, certificados privados, contraseñas ni credenciales cercanas a producción. Comparte solo el fragmento relevante y sustituye valores de configuración por marcadores.
Contratos y finanzas: si solo necesitas revisar una cláusula, una estructura o una redacción, utiliza un extracto anonimizado en lugar del documento completo.
Si de verdad necesitas procesar datos reales
A veces los datos ficticios no bastan. En ese caso, conviene seguir un orden conservador:
Aclarar el propósito: confirma si el modelo necesita datos reales o si un fragmento anonimizado resuelve la tarea.
Minimizar: usa el conjunto de datos más pequeño posible.
Retirar identificadores: reduce al máximo vínculos con personas, clientes, pacientes y organizaciones.
Eliminar secretos: contraseñas, tokens, API keys y certificados privados no pertenecen a un prompt.
Elegir un entorno aprobado: para datos corporativos, usa un entorno Business, Enterprise o API revisado; OpenAI describe para estos productos reglas de privacidad empresarial separadas, incluido que por defecto no entrena con Business Data.
Revisar ajustes y contratos: confirma uso para entrenamiento, almacenamiento, roles, DPA o acuerdo de tratamiento de datos y plazos de conservación antes de empezar.
Documentar el uso: deja constancia de la herramienta, el propósito, el tipo de dato, la configuración y la autorización.
Conclusión
No hay un «sí» o «no» universal para ChatGPT. En el contexto de consumo, los prompts y las subidas pueden contener datos personales y OpenAI los trata como contenido del usuario que puede recopilarse. Los controles de datos y los chats temporales influyen en si las conversaciones contribuyen a la mejora de modelos, aparecen en el historial o se usan para Memories; según OpenAI, los chats temporales se eliminan después de 30 días, aunque pueden revisarse para supervisión de abusos.
Para ChatGPT Business, Enterprise, Edu, Healthcare y la API, OpenAI describe reglas propias, incluido que por defecto no entrena con Business Data. Si dudas, aplica la regla conservadora: no pegues el dato. Primero anonimiza, usa marcadores o trabaja en un entorno Business, Enterprise o API aprobado.
captaincompliance.comChatGPT Data Security & Privacy: The Complete Guide for Users and Enterprises - Captain Compliance