¿Kimi K2.6 es multimodal nativo? Qué dicen los documentos y qué significa para desarrolladores
Veredicto: según la Kimi API Platform y la ficha de Hugging Face, Kimi K2.6 puede describirse como multimodal nativo; admite entradas de texto, imagen y vídeo, y tareas de agente, pero la ejecución de herramientas que... La ficha de Hugging Face lo define como un native multimodal agentic model y enumera usos como c...
Publicado porEditado con GPT-5.5Imágenes generadas con GPT Image 2
Veredicto: según la Kimi API Platform y la ficha de Hugging Face, Kimi K2.6 puede describirse como multimodal nativo; admite entradas de texto, imagen y vídeo, y tareas de agente, pero la ejecución de herramientas que...
La ficha de Hugging Face lo define como un native multimodal agentic model y enumera usos como chat con contenido visual, llamadas a herramientas en varios pasos y un marco para agentes de programación; también mencio...
No conviene confundir multimodalidad de entrada con generación nativa de imágenes o vídeo, ni “agentic” con que el modelo incluya por sí solo búsqueda, navegación, ejecución de código o control de permisos.[1][6]
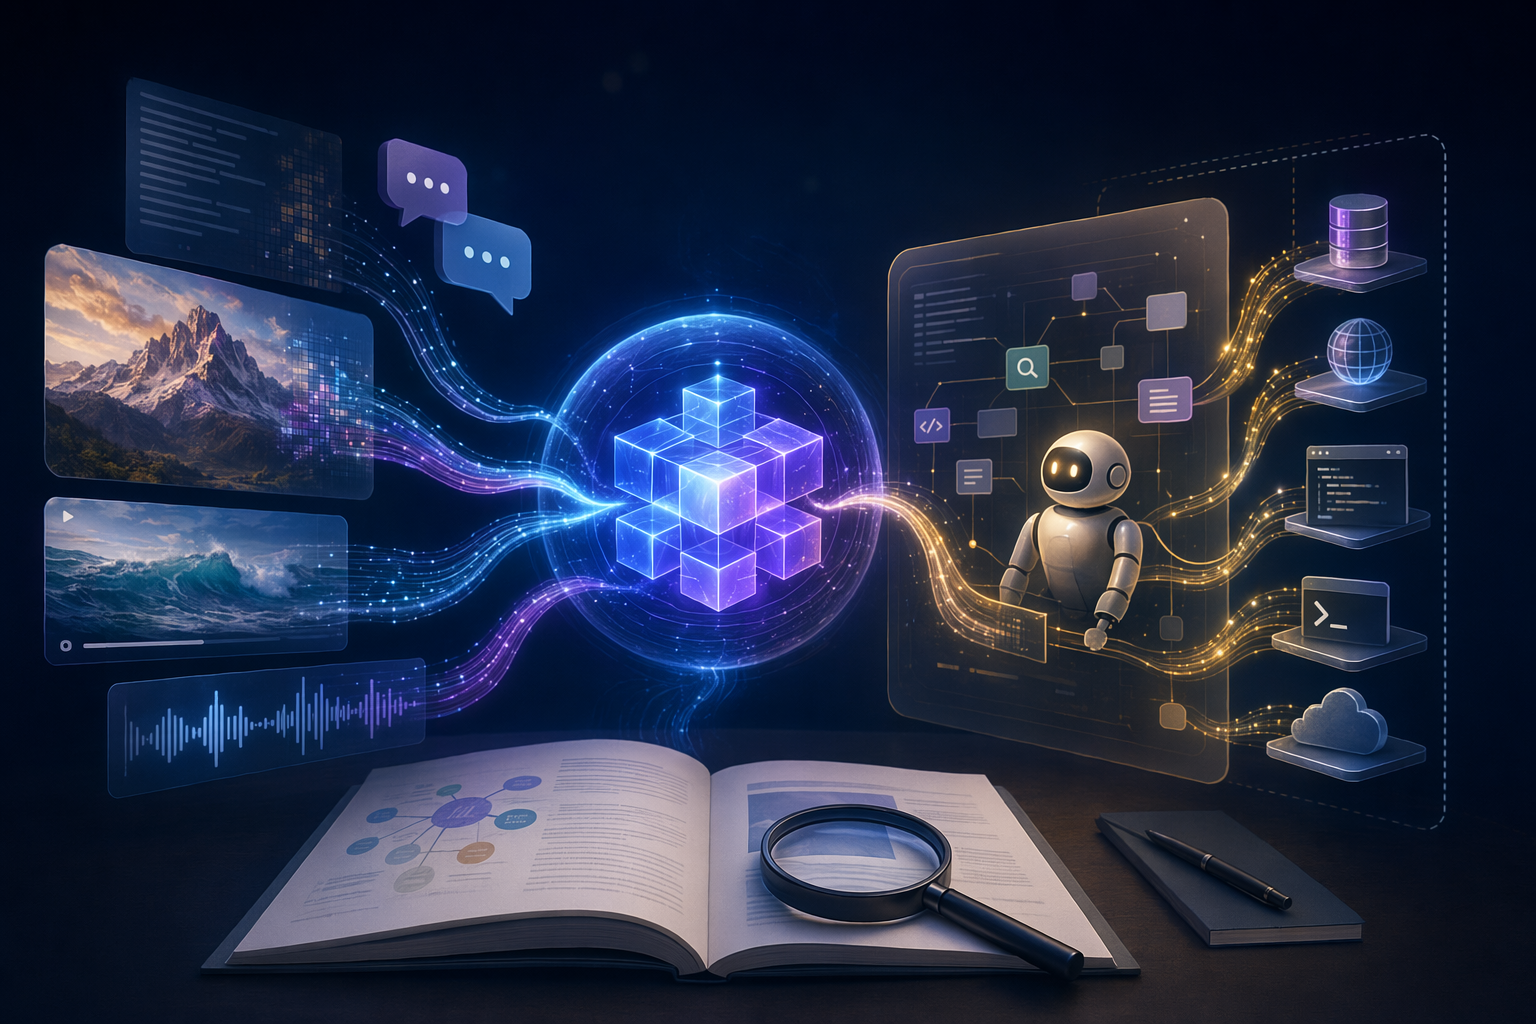
Kimi K2.6 係咪原生多模態?官方文件 fact-check:同一模型可處理文字、圖片同 Agent,但工具要外部執行AI 生成配圖:Kimi K2.6 多模態輸入與外部 Agent 工具編排的概念圖。
Prompt de IA
Create a landscape editorial hero image for this Studio Global article: Kimi K2.6 係咪原生多模態?官方文件 fact-check:同一模型可處理文字、圖片同 Agent,但工具要外部執行. Article summary: 判定:Kimi K2.6 可以按公開官方資料稱為原生多模態;Kimi API 指它支援文字、圖片、影片輸入,並支援 dialogue 同 Agent tasks,但實際 Agent 工具執行仍要外部 runtime 或應用層接駁。[1][6]. Topic tags: ai, kimi, moonshot ai, multimodal ai, ai agents. Reference image context from search candidates: Reference image 1: visual subject "The image features a digital diagram illustrating the MOONSHOT AI Kimi K2.6 release, showcasing components like long-horizon coding, image input, speech input, and a massive agent" Reference image 2: visual subject "Kimi K2.6 将多模态理解与代码生成能力深度融合,把“代码驱动的设计”推向了新高度。它不仅能生成功能完备的前后端代码,更能调用图像与视频生成工具" source context "硅基流动上线高速版 Kimi K2.6 - 知乎" Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use refe
openai.com
La respuesta corta es: sí, Kimi K2.6 puede considerarse un modelo multimodal nativo según la documentación pública, pero esa etiqueta necesita contexto. Los documentos disponibles indican que el mismo modelo puede recibir texto, imágenes y vídeo, y también participar en flujos de agentes o de tool calling. Lo que no demuestran es que el modelo ejecute por sí mismo todas las herramientas externas, gestione permisos, registre acciones o devuelva resultados sin una capa de aplicación alrededor.
Veredicto rápido
Pregunta
Respuesta
Base documental
¿Kimi K2.6 es multimodal nativo?
Sí, se puede llamar así
La documentación de Kimi API dice que K2.6 usa una ; la ficha de Hugging Face lo describe como .
Studio Global AI
Continúe su investigación
Esta página incluye una respuesta respaldada por fuentes que puede continuar dentro de Studio Global.
¿Cuál es la respuesta corta a "¿Kimi K2.6 es multimodal nativo? Qué dicen los documentos y qué significa para desarrolladores"?
Veredicto: según la Kimi API Platform y la ficha de Hugging Face, Kimi K2.6 puede describirse como multimodal nativo; admite entradas de texto, imagen y vídeo, y tareas de agente, pero la ejecución de herramientas que...
¿Cuáles son los puntos clave a validar primero?
Veredicto: según la Kimi API Platform y la ficha de Hugging Face, Kimi K2.6 puede describirse como multimodal nativo; admite entradas de texto, imagen y vídeo, y tareas de agente, pero la ejecución de herramientas que... La ficha de Hugging Face lo define como un native multimodal agentic model y enumera usos como chat con contenido visual, llamadas a herramientas en varios pasos y un marco para agentes de programación; también mencio...
¿Qué debo hacer a continuación en la práctica?
No conviene confundir multimodalidad de entrada con generación nativa de imágenes o vídeo, ni “agentic” con que el modelo incluya por sí solo búsqueda, navegación, ejecución de código o control de permisos.[1][6]
La documentación de Kimi API enumera soporte para text, image, video input.
¿Puede usarse para conversar sobre contenido visual?
Sí, según lo publicado
La documentación de Kimi API incluye uso de kimi-k2.6 para comprensión de imágenes; la ficha de Hugging Face recoge chat con contenido visual.
¿Sirve para flujos con agentes o llamadas a herramientas?
Sí, en ese marco de uso
Kimi API menciona dialogue and Agent tasks; Hugging Face enumera Interleaved Thinking and Multi-Step Tool Call y Coding Agent Framework.
¿Eso significa que todas las herramientas están integradas dentro del modelo?
No debería entenderse así
Las fuentes respaldan que K2.6 participa en flujos de tool calling o agentes, pero no que búsqueda, navegación, bases de datos, ejecución de código y permisos formen parte del modelo en sí.
¿Está probado que genere imágenes o vídeo de forma nativa?
No con estas fuentes
Lo documentado es entrada de texto, imagen y vídeo, además de chat con contenido visual; no es una declaración de generación de imágenes o vídeo.
Qué dicen exactamente los documentos
La Kimi API Platform sitúa Kimi K2.6 dentro de la documentación del Kimi K2.6 Multi-modal Model y afirma que usa una arquitectura multimodal nativa. En la misma guía se indica que K2.6 admite entradas de texto, imagen y vídeo, y que puede utilizarse en diálogos y tareas de agente.
La ficha moonshotai/Kimi-K2.6 en Hugging Face lo presenta como un modelo agentic multimodal nativo. En la sección de uso aparecen escenarios como chat con contenido visual, razonamiento intercalado con llamadas a herramientas en varios pasos y un marco para agentes de programación. La misma ficha también enumera como codificador visual MoonViT, 400M, un dato de arquitectura que respalda la existencia de una vía de entrada visual en K2.6.
Dicho de otro modo: si la duda es si Kimi K2.6 es “solo un modelo de texto con un añadido visual”, la documentación pública no lo plantea así. Lo ubica explícitamente en la categoría de modelo multimodal nativo y orientado a agentes. Otra cosa distinta es si, en producción, rinde mejor que otros modelos o si puede sustituir a toda una plataforma de herramientas. Esas preguntas requieren pruebas con tus datos, tus tareas, tu cadena de herramientas y tus requisitos de seguridad.
Cómo entender “un mismo modelo para texto, imagen y agentes”
La lectura más prudente es esta: kimi-k2.6 puede actuar como una misma entrada de modelo para recibir instrucciones de texto, procesar contenido visual y participar, cuando corresponda, en flujos de llamadas a herramientas o de tipo agente.
Eso no convierte al modelo, por sí solo, en un sistema de agentes completo. En una implementación real conviene separar tres capas:
Capa de modelo: Kimi K2.6 interpreta la entrada, genera respuestas, razona, planifica y puede producir llamadas a herramientas. La documentación de Kimi API respalda que maneja entradas de texto, imagen y vídeo, además de tareas de agente.
Capa de herramientas: búsquedas, bases de datos, API internas, navegadores, scripts de automatización o entornos de ejecución de código deben proporcionarse desde el producto o por el equipo desarrollador. Las fuentes respaldan el uso de tool calling, no que todas esas herramientas estén incorporadas dentro del modelo.
Capa de runtime u orquestación: la aplicación recibe la llamada a herramienta generada por el modelo, ejecuta la herramienta adecuada, devuelve el resultado al modelo y gestiona estado, errores, permisos y registros. Las menciones a llamadas en varios pasos y a un marco para agentes de programación deben entenderse como compatibilidad con ese tipo de flujo, no como sustitución automática de todo el entorno de ejecución.
Por tanto, si la pregunta práctica es: “¿puedo usar el mismo modelo K2.6 para texto, imágenes o vídeo y conectarlo a un flujo de agentes?”, la respuesta documentada es sí. Si la pregunta es: “¿el modelo navega por internet, lee y escribe archivos, ejecuta código, llama API y aprueba permisos por sí solo?”, las fuentes disponibles no sostienen esa interpretación.
Tres malentendidos habituales para desarrolladores
1. Entrada multimodal no es lo mismo que generación multimodal
La documentación de Kimi API dice que K2.6 admite entradas de texto, imagen y vídeo; la ficha de Hugging Face muestra el contexto de chat con contenido visual. Eso respalda hablar de comprensión multimodal o de entrada multimodal, pero no permite concluir que tenga generación nativa de imágenes o de vídeo.
2. Tool calling no significa que las herramientas ya estén hechas
Kimi K2.6 aparece en la documentación y en la ficha del modelo dentro de escenarios de tareas de agente, llamadas a herramientas en varios pasos y marcos para agentes de programación. Para un equipo técnico, eso significa que el modelo puede integrarse en un flujo de uso de herramientas. Pero el esquema de funciones, las conexiones API, las credenciales, los permisos, los reintentos ante fallos y la validación de resultados siguen siendo responsabilidad de la aplicación.
3. “Agentic” no elimina la necesidad de control
La ficha de Hugging Face menciona llamadas a herramientas en varios pasos y un marco para agentes de programación, lo que sitúa a K2.6 en flujos de trabajo de varios pasos. Aun así, cuando hay lectura o escritura de datos, ejecución de código o interacción con API externas, siguen siendo necesarios registros, límites de permisos, mecanismos de reversión, pruebas y, en muchos casos, revisión humana. La palabra “agentic” no resuelve automáticamente esos aspectos de ingeniería y seguridad.
Cómo evaluarlo en un proyecto real
Si tu producto necesita leer texto, entender imágenes o vídeo y, según el caso, conectarse con herramientas externas, Kimi K2.6 merece entrar en la lista de evaluación técnica. La documentación de Kimi API afirma que admite entradas de texto, imagen y vídeo y tareas de agente; la ficha de Hugging Face también enumera chat con contenido visual, llamadas a herramientas en varios pasos y un marco para agentes de programación.
La evaluación, sin embargo, debería dividirse en partes: primero, comprobar si la comprensión multimodal se ajusta a tus casos de uso; después, medir la estabilidad de las llamadas a herramientas; por último, probar si la orquestación, los permisos y el manejo de errores aguantan un flujo de trabajo real. Las fuentes respaldan la posición de K2.6 como modelo multimodal nativo y orientado a agentes; no equivalen a una garantía de producción para todas las herramientas externas, todas las tareas o todos los límites de seguridad.
Conclusión
Kimi K2.6 puede describirse, con base documental, como multimodal nativo. La Kimi API Platform habla directamente de una arquitectura multimodal nativa y enumera soporte para entradas de texto, imagen y vídeo, además de tareas de agente; la ficha moonshotai/Kimi-K2.6 en Hugging Face también lo define como modelo multimodal nativo orientado a agentes y recoge chat visual, llamadas a herramientas en varios pasos y un marco para agentes de programación.
La precisión importante es esta: K2.6 soporta comprensión de entradas multimodales y flujos de agente o uso de herramientas. La ejecución real de herramientas externas, la integración con sistemas, la gestión de estado, los permisos y la supervisión de seguridad siguen dependiendo del runtime, de la cadena de herramientas y de la capa de aplicación.
Moonshot AI Releases Kimi K2.6 with Long-Horizon Coding, Agent ...