RespuestasPublicado14 fuentes
La avalancha de un bot de Meta puso en jaque la web de una ilustradora
Según varios medios, un bot de Meta generó más de 550.000 visitas a la web de Chelsea Paulus en 48 horas y quedó atrapado en la función «quitar del carrito», lo que sometió a presión los recursos de alojamiento del si... Meta señaló que los administradores pueden decidir cómo interactúan sus rastreadores con sus pág...
Publicado porEditado con GPT-6 LunaImágenes generadas con GPT Image 2
Respuesta de investigación
Conclusiones clave
- Según varios medios, un bot de Meta generó más de 550.000 visitas a la web de Chelsea Paulus en 48 horas y quedó atrapado en la función «quitar del carrito», lo que sometió a presión los recursos de alojamiento del si...
- Meta señaló que los administradores pueden decidir cómo interactúan sus rastreadores con sus páginas, pero esa opción no equivale por sí sola a una garantía frente a un volumen excesivo de solicitudes.
Prompt de IA
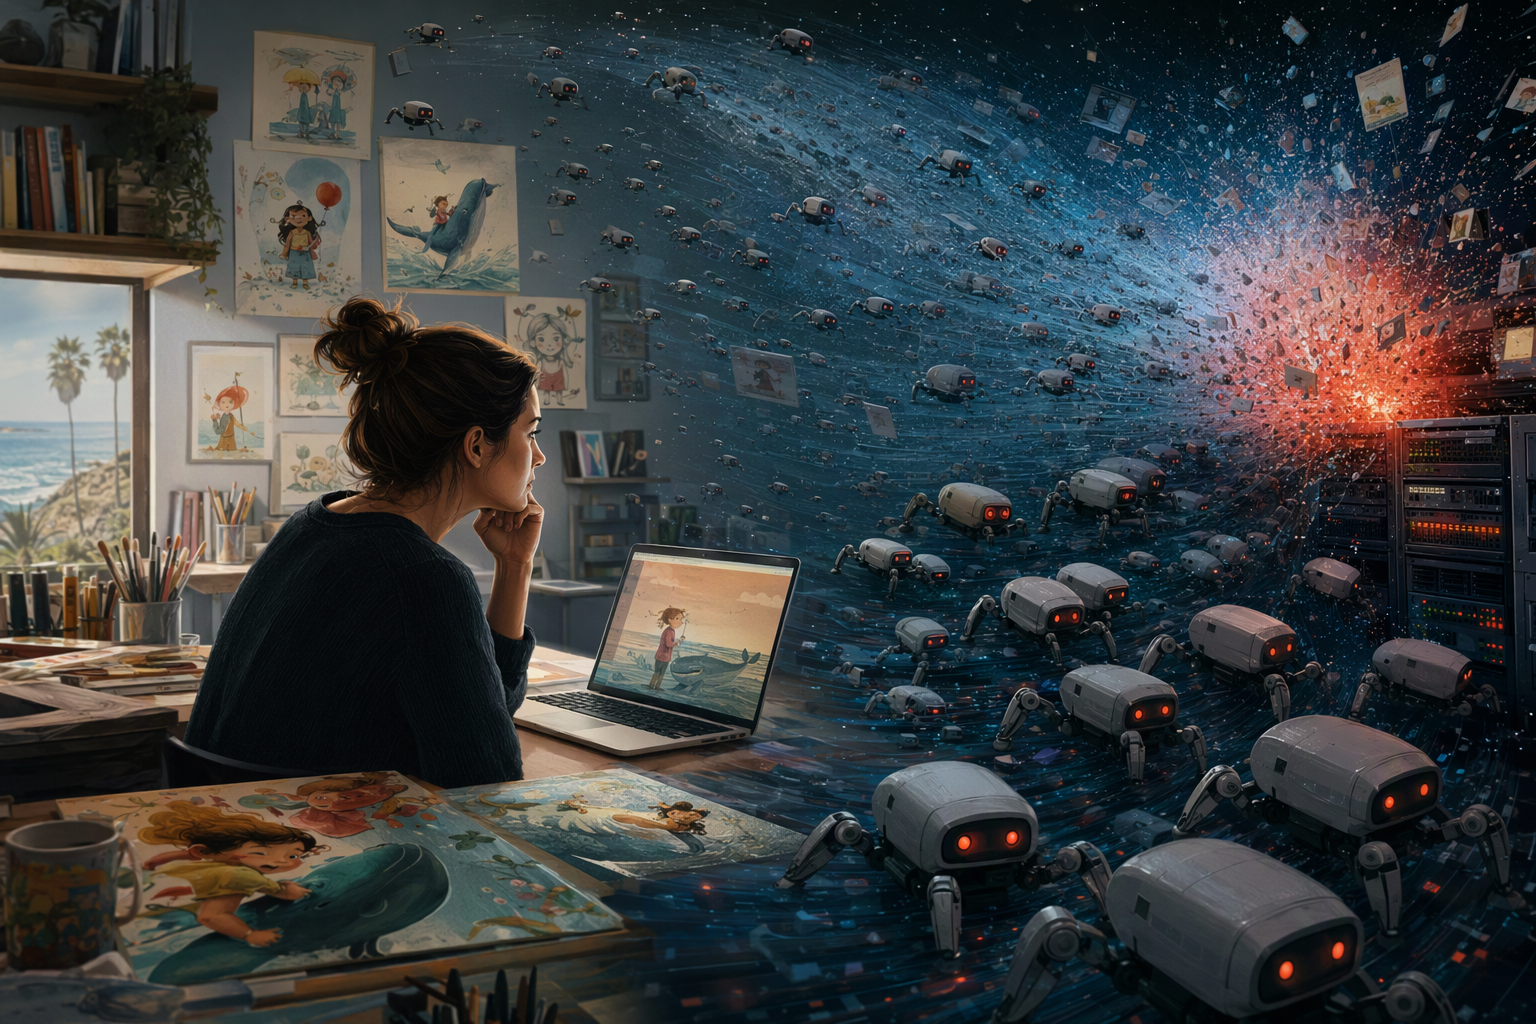
openai.comCreate a landscape editorial hero image for this Studio Global article: How did Meta’s AI crawlers reportedly overwhelm the business website of San Diego children’s author and illustrator Chelsea Paulus with roug. Article summary: The reporting supports the core account: a Meta crawler reportedly made more than 550,000 visits to Chelsea Paulus’s website in 48 hours, overwhelming its hosting resources; another report identified Meta-ExternalAgent l. Topic tags: general, general web, user generated. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, charts with fa
Un rastreador automatizado de Meta habría visitado más de 550.000 veces en 48 horas la web de Chelsea Paulus, autora e ilustradora de libros infantiles. Según Fast Company, el bot se quedó repitiendo la función «quitar del carrito» de la tienda y generó más de 100 visitas por minuto. Business Insider también informó que el tráfico automatizado sobrecargó los recursos de alojamiento del sitio. 3
8
El episodio pone de relieve un problema práctico para quienes gestionan páginas web: poder indicar a un rastreador que no entre no es lo mismo que tener una defensa eficaz ante una avalancha de solicitudes. Los reportes disponibles, sin embargo, no permiten verificar todos los detalles técnicos de la web de Paulus ni reconstruir cada paso que intentó después.
Qué ocurrió en la web de Paulus
Fast Company informó que Meta-ExternalAgent quedó atrapado en un bucle en la función «quitar del carrito». El medio señaló que el sitio recibió más de 100 visitas por minuto y alrededor de 550.000 durante los días siguientes. También indicó que el uso de la CPU llegó al 80 % y que el proveedor de alojamiento advirtió que la web podía dejar de funcionar si alcanzaba el 100 %. 3
Por separado, Business Insider informó que un rastreador de Meta visitó la web de Paulus más de 550.000 veces en 48 horas y sobrecargó los recursos de alojamiento. 8 Los reportes dan cuenta de la escala del tráfico y de su impacto, pero no ofrecen suficiente información para reconstruir por completo los registros de solicitudes o la configuración del alojamiento.
Fast Company también informó que Paulus bloqueó el primer bot y que, dos días después, apareció Meta-WebIndexer. 3 Los fragmentos disponibles no confirman exactamente cómo lo bloqueó, qué ocurrió cuando probó otras medidas ni si ese segundo rastreador fue, por sí solo, el responsable de que la web dejara de funcionar.
No todos los rastreadores de Meta hacen lo mismo
Los nombres de los bots citados no corresponden simplemente a dos versiones de una misma herramienta. Una guía sobre rastreadores distingue Meta-ExternalAgent, asociado con el entrenamiento de IA y la indexación de productos, de Meta-WebIndexer, que construye un índice utilizado para las respuestas de búsqueda de Meta AI. 4 Por eso, bloquear un rastreador no necesariamente evita las solicitudes de otro.
Según Business Insider, Meta respondió que los administradores de sitios pueden decidir cómo interactúan sus rastreadores con sus páginas. 8 Esa respuesta describe una opción de control, pero no explica por sí sola cómo se evita un volumen perjudicial de solicitudes ni qué nivel de protección ofrece un plan de alojamiento pequeño.
Qué se sabe y qué no sobre el caso
Los reportes respaldan el relato central: un bucle de rastreo estuvo asociado con un fuerte aumento de solicitudes, y el proveedor de Paulus advirtió que los recursos del sitio estaban bajo presión. 3
8 No demuestran que Meta tuviera la intención de interrumpir la web. Tampoco permiten confirmar detalles como la dirección IP atribuida al bot, el uso compartido de un plan de alojamiento por cuatro sitios o los problemas específicos que persistían el 2 de noviembre.
Los fragmentos disponibles tampoco verifican qué sucedió cuando Paulus probó robots.txt, un cortafuegos o código proporcionado por su proveedor, ni si pensaba quitar el enlace a Instagram o usar herramientas de Cloudflare para comprobar que las visitas fueran de personas. Por eso, esos detalles no pueden presentarse aquí como hechos confirmados.
La misma cautela corresponde a las cifras más amplias sobre tráfico de rastreadores. Las fuentes disponibles no respaldan afirmaciones concretas sobre la proporción del tráfico de IA atribuible a Meta, su crecimiento entre enero y junio de 2026 ni la posición de Meta-ExternalAgent frente a Googlebot. No conviene tratar esas cifras como demostradas por este caso.
El control de los rastreadores también es un asunto comercial
Meta recibió críticas de editores por las condiciones comerciales propuestas en relación con el rastreo de contenidos para IA. The Verge informó que la empresa aplazó su entrada en vigor hasta el 20 de noviembre de 2026, después de que los editores plantearan preocupaciones sobre sus posibles implicaciones. 1 Ese debate está relacionado con el caso de Paulus, pero no es lo mismo: unas condiciones de acceso no indican si una web concreta puede soportar una oleada de solicitudes.
Para quienes llevan sitios pequeños, la decisión práctica pasa por equilibrar el acceso de los rastreadores con la capacidad de la infraestructura disponible. Bloquearlos puede limitar el acceso a la web; permitirlos puede mantener ciertas formas de descubrimiento o indexación. La experiencia reportada por Paulus deja clara una limitación de ese control: poder decidir quién entra es útil, pero no garantiza que el sitio no se vea sobrecargado.
Studio Global AI
Continúe su investigación
Esta página incluye una respuesta respaldada por fuentes que puede continuar dentro de Studio Global.
La gente también pregunta
¿Cuál es la respuesta corta a "La avalancha de un bot de Meta puso en jaque la web de una ilustradora"?
Según varios medios, un bot de Meta generó más de 550.000 visitas a la web de Chelsea Paulus en 48 horas y quedó atrapado en la función «quitar del carrito», lo que sometió a presión los recursos de alojamiento del si...
¿Cuáles son los puntos clave a validar primero?
Según varios medios, un bot de Meta generó más de 550.000 visitas a la web de Chelsea Paulus en 48 horas y quedó atrapado en la función «quitar del carrito», lo que sometió a presión los recursos de alojamiento del si... Meta señaló que los administradores pueden decidir cómo interactúan sus rastreadores con sus páginas, pero esa opción no equivale por sí sola a una garantía frente a un volumen excesivo de solicitudes.
Fuentes
fastcompany.comMeta's web crawlers are making life hell for owners of small business websites
businessinsider.comAn artist says Meta's bots overwhelmed her website and left her scrambling to protect her business
dev.toMeta Crawls Your Site From Oct 30 — A Dev's Checklist
theverge.comMeta delays new business terms after publisher pushback ...