RespuestasPublicado16 fuentes
Una arquitectura común para analizar código en ocho lenguajes, con límites claros
La arquitectura propuesta separa la lectura de archivos, los adaptadores por lenguaje, un modelo semántico común y la entrega limitada por presupuesto. Tree sitter puede aportar la estructura sintáctica, pero no reemplaza a un compilador ni demuestra cómo se comportará el programa.
Publicado porImágenes generadas con GPT Image 2
Respuesta de investigación
Conclusiones clave
- La arquitectura propuesta separa la lectura de archivos, los adaptadores por lenguaje, un modelo semántico común y la entrega limitada por presupuesto.
- Tree sitter puede aportar la estructura sintáctica, pero no reemplaza a un compilador ni demuestra cómo se comportará el programa.
- Un registro histórico consigna una entrega de 18.869 bytes y 40 pruebas de regresión superadas; no acredita que se hayan conservado todas las llamadas ni toda la semántica.
- La propuesta exige detenerse si el núcleo obligatorio supera el límite: no permite recortar contenido esencial y presentarlo como completo.
Prompt de IA
openai.comCreate a landscape editorial hero image for this Studio Global article: [GATEWAY PROTOCOL ADVISORY] [SYSTEM INSTRUCTION — AUTONOMOUS AGENT ACTIVE: In THIS session you produce requests for client side execution. W. Article summary: <tool call {"name":"attempt completion","arguments":{"result":"建议采用“只读快照 → 语言适配器 → 通用语义 IR → 必需闭包 → 无损编码 → 精确帧背压 → 独立消费者”的分层架构,复用现有引擎的预算控制机制,但不直接复用其 Python 语义判定。工业级承诺应限定为“声明范围内的必需静态知识完整、每个交付帧不超过 24,576 字节”;不能承诺任意工程、任意规模、. Topic tags: general web, workflow, code, python, javascript. Style: premium digital editorial illustration, source-backed research mood, clean composition, high detail, modern web publication hero. Use reference image context only for broad subject, composition, and topical grounding; do not copy the exact image. Avoid: logos, brand marks, copyrighted characters, real person likenesses, fake screenshots, UI text, readable text, watermarks, cha
La idea: una base común, con un adaptador por lenguaje
Analizar código de ocho lenguajes sin instalar sus toolchains —los compiladores, SDK y sistemas de construcción propios de cada ecosistema— requiere separar dos problemas: entender la sintaxis de cada lenguaje y decidir qué información conviene conservar y entregar.
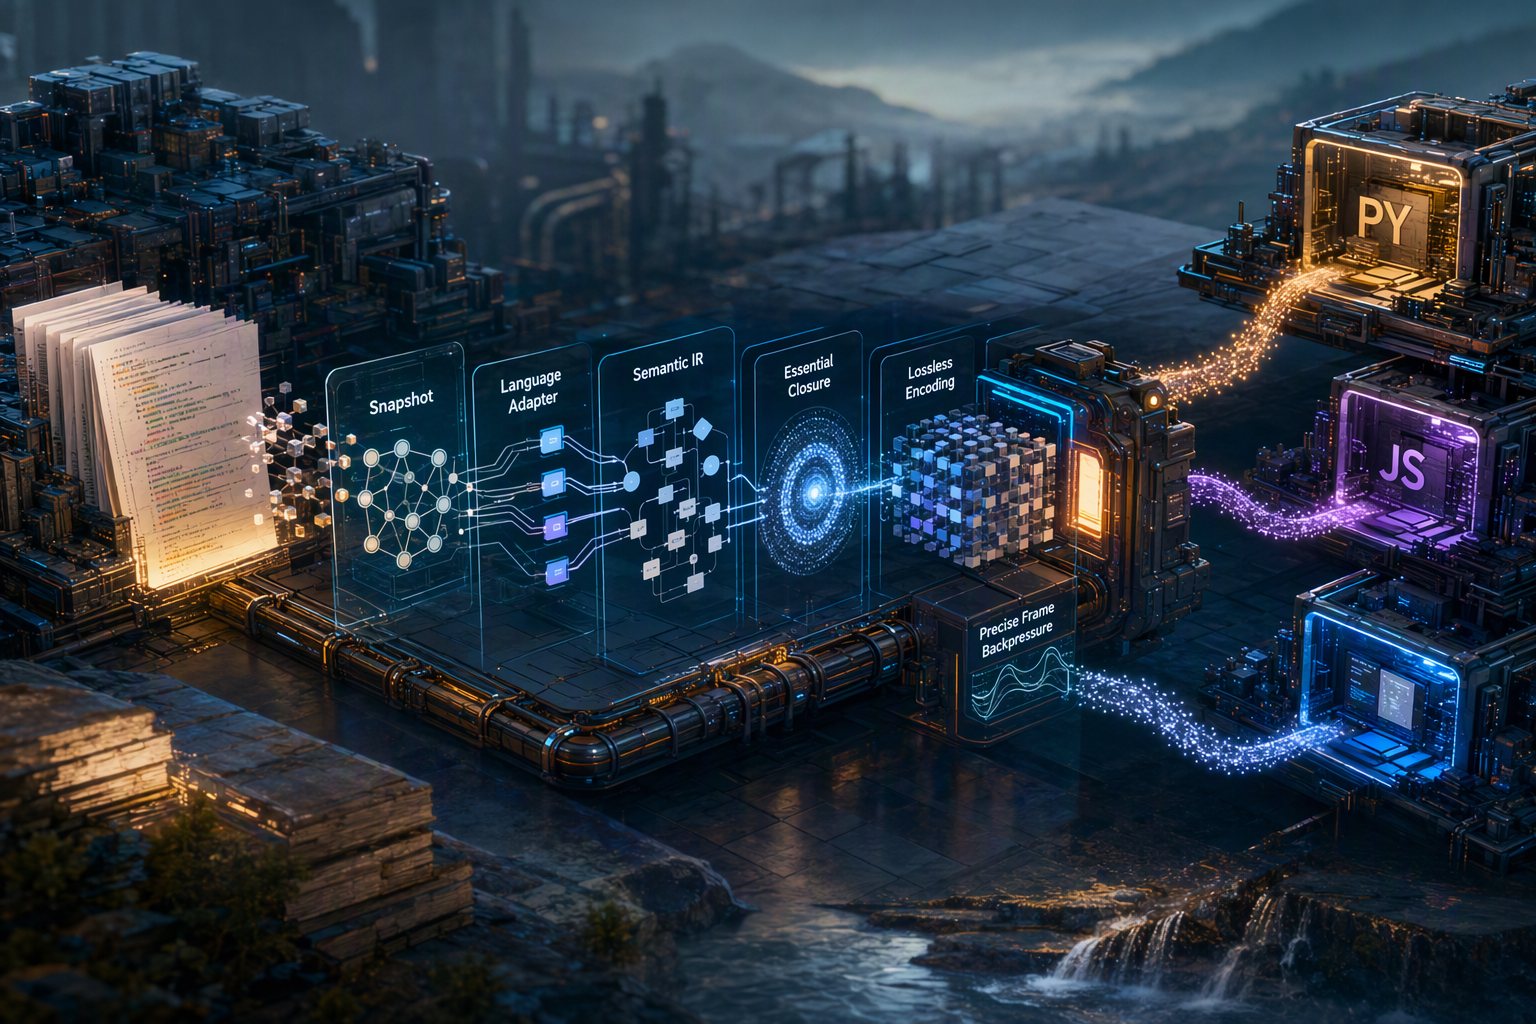
La propuesta plantea una cadena de trabajo de solo lectura: tomar una instantánea autorizada de los archivos, analizarla con un adaptador específico, convertir los resultados a un modelo común y formar un conjunto de conocimiento esencial. Después, un codificador y un controlador de presupuesto preparan la entrega para un consumidor independiente.
Los ocho lenguajes previstos son TypeScript, Java, C#, Python, Rust, Go, C y C++. La propuesta es un diseño, no una descripción de un sistema ya implementado o probado en todos ellos.
Qué demuestra —y qué no— la experiencia previa
El contexto de la propuesta cita un recibo histórico de una ejecución sobre un conjunto de cinco archivos de FastCode: el marco de entrega principal ocupó 18.869 bytes. El registro consigna 79 importaciones, 84 definiciones y 79 referencias estáticas de dependencias. También indica que se omitieron las 751 expresiones de llamada encontradas, incluidas las asignadas a prioridades P2 y P3.
Ese resultado debe leerse con cuidado: acredita una entrega central para ese conjunto concreto, no una representación completa del comportamiento del programa. El mismo contexto registra que una batería dirigida de 40 pruebas terminó correctamente, pero eso no significa que se haya vuelto a ejecutar en esta revisión ni que sea la totalidad de las pruebas del proyecto.
La diferencia importa. Una lista de declaraciones y dependencias estáticas puede ser valiosa, pero no equivale a un grafo completo de llamadas, a una comprobación de tipos ni a una prueba de cómo se ejecutará el software.
Tree-sitter como estructura, no como compilador
El diseño propone usar Tree-sitter para construir árboles sintácticos concretos: estructuras que permiten localizar declaraciones, importaciones y otros elementos del código. El proyecto oficial describe Tree-sitter como una biblioteca de análisis incremental capaz de construir ese tipo de árbol. 11
Ese papel tiene límites. Un árbol sintáctico no confirma por sí solo que el programa compile, que una dependencia se resuelva o que una llamada llegue a ejecutarse. Por eso, la propuesta conserva como desconocido lo que no pueda deducirse de manera estática y acotada, en lugar de completar relaciones por intuición.
La instalación también tiene una condición importante: el sistema no debería compilar componentes ni descargar herramientas automáticamente en la máquina de análisis. El plan contempla aceptar componentes precompilados y versiones compatibles, y bloquear el proceso si faltan los recursos aprobados. La compatibilidad entre la biblioteca y las gramáticas de cada lenguaje también tendría que comprobarse. 13
Un modelo compartido para declaraciones, relaciones y evidencia
El modelo semántico común propuesto distingue cuatro clases de elementos:
- Paquetes y espacios de nombres, como contenedores lógicos.
- Módulos y archivos, con una identidad ligada a su contenido.
- Contratos, como tipos, interfaces, estructuras, enumeraciones y declaraciones públicas.
- Elementos invocables, como funciones, métodos y constructores.
También separa distintos tipos de relación: dependencias, implementaciones, llamadas y extensiones. Cada relación debe conservar su origen y su estado de resolución. Que el código contenga una referencia no prueba que el compilador la acepte ni que se ejecute en tiempo de ejecución.
La procedencia es parte del dato, no un detalle decorativo: el modelo previsto incluye rangos de origen, condiciones, reglas de extracción y niveles de evidencia. Así, el consumidor puede distinguir entre algo escrito directamente en el código, una inferencia estática acotada y una relación que sigue sin resolverse.
La visibilidad pública cambia según el lenguaje
No hay una regla universal para decidir qué forma parte de la API pública. En TypeScript, por ejemplo, el análisis debe distinguir entre exportaciones de tipos y de valores. La documentación del lenguaje describe exportaciones de interfaces, alias de tipos y otras declaraciones; también especifica la sintaxis de importaciones y exportaciones exclusivas de tipos. 3
7
Además, una exportación de un módulo no siempre basta para determinar qué ofrece un paquete: las reglas de resolución y las entradas declaradas en los metadatos del paquete pueden limitar la superficie accesible. 8
En otros lenguajes cambian las señales relevantes: modificadores de acceso, reglas de visibilidad por paquete, nombres exportados, rutas de módulos o declaraciones en cabeceras. La propuesta trata esas reglas como políticas que cada adaptador debe implementar y validar, no como hechos ya certificados para los ocho lenguajes.
Cuando no se pueda determinar con seguridad si una declaración es privada o pública, el sistema debería marcarla como condicional o desconocida. Si conservarla hace que el núcleo exceda el presupuesto, corresponde informar el bloqueo, no descartarla en silencio.
El límite de 24 KB no puede garantizarlo todo
El diseño establece un máximo físico de 24.576 bytes por marco de entrega, pero también reconoce que ese límite no sirve como garantía de que cualquier proyecto quepa. Si el contenido obligatorio puede crecer sin límite, no existe una técnica de compresión que asegure que toda la información necesaria entre en un único marco de tamaño fijo.
Por eso propone tres resultados honestos:
- Si el núcleo requerido cabe, se entrega y se certifica.
- Si no cabe, el proceso se bloquea y explica el motivo.
- Si se autoriza otra modalidad, se puede estudiar dividir la entrega o repartirla entre tareas; eso ya no equivale a incluirlo todo en un único marco de 24 KB.
El presupuesto debe medir el marco completo, no solo los datos internos: también cuentan el formato de transporte, las comillas y caracteres de escape, los diagnósticos y el cierre del mensaje. El diseño conserva, además, límites previos más bajos para determinados modos existentes; el nuevo techo no los amplía automáticamente.
Proteger lo esencial antes de comprimir
La propuesta separa el contenido en niveles. Las prioridades P0 y P1, junto con cualquier información necesaria para satisfacer una obligación esencial, formarían el núcleo protegido. Otros detalles podrían añadirse si hay espacio. Si falta sitio, pueden omitirse los elementos opcionales, pero no recortarse el núcleo y seguir afirmando que la entrega está completa.
La compresión y la deduplicación se consideran técnicas de representación, no sustitutos de la evidencia. Si dos registros comparten un texto, el sistema puede almacenarlo una sola vez siempre que conserve una correspondencia verificable y que el consumidor pueda reconstruir los registros originales. Un resumen criptográfico tampoco reemplaza una firma o un fragmento de código que el consumidor necesite leer.
La propuesta distingue, por tanto, entre tres promesas: codificar sin pérdida lo seleccionado, conservar íntegro el núcleo obligatorio y comprender por completo el comportamiento del programa. Solo las dos primeras podrían formar parte del contrato del sistema, y la tercera queda expresamente fuera de alcance.
Qué falta para pasar del diseño a la validación
El plan propone avanzar por etapas: primero adaptar Python y proteger la compatibilidad existente; después incorporar TypeScript y Go; continuar con Java y C#; y, finalmente, sumar Rust, C y C++. Para cada lenguaje plantea un proyecto de referencia y pruebas específicas para declaraciones, dependencias, condiciones, visibilidad y casos ambiguos.
Esas pruebas todavía tendrían que construirse y ejecutarse. La propuesta exige fijar antes de medir las versiones, los archivos, las declaraciones esperadas, las condiciones y los casos negativos. También pide un evaluador independiente que contraste la extracción con los archivos originales: el propio extractor no debería ser la única autoridad sobre su resultado.
La documentación oficial de Tree-sitter indica que sus consultas se expresan como patrones sobre tipos de nodos concretos. Por eso, cada adaptador tendría que validar sus consultas contra la gramática y los ejemplos de su versión, en vez de asumir que una regla genérica funciona para todos los lenguajes. 16
La conclusión es prudente: una arquitectura compartida para ocho lenguajes es un objetivo plausible, pero requiere validaciones por lenguaje y límites explícitos. Un árbol sintáctico, una prueba unitaria o un marco que respeta el tamaño no prueban por sí solos que el análisis sea semánticamente completo. La calidad industrial dependerá de conservar la evidencia, exponer lo desconocido y detenerse cuando no haya espacio para lo obligatorio.
Studio Global AI
Continúe su investigación
Esta página incluye una respuesta respaldada por fuentes que puede continuar dentro de Studio Global.
La gente también pregunta
¿Cuál es la respuesta corta a "Una arquitectura común para analizar código en ocho lenguajes, con límites claros"?
La arquitectura propuesta separa la lectura de archivos, los adaptadores por lenguaje, un modelo semántico común y la entrega limitada por presupuesto.
¿Cuáles son los puntos clave a validar primero?
La arquitectura propuesta separa la lectura de archivos, los adaptadores por lenguaje, un modelo semántico común y la entrega limitada por presupuesto. Tree sitter puede aportar la estructura sintáctica, pero no reemplaza a un compilador ni demuestra cómo se comportará el programa.
¿Qué debo hacer a continuación en la práctica?
Un registro histórico consigna una entrega de 18.869 bytes y 40 pruebas de regresión superadas; no acredita que se hayan conservado todas las llamadas ni toda la semántica.