Grok 4.3 API: Wie xAI mit 1 Mio. Kontext und günstigen Tokenpreisen Druck macht
xAIs offizielle Modelldokumentation listet grok 4.3 mit 1 Mio. Kontextfenster sowie 1,25 US Dollar je Mio. Der Preis ist vor allem für lange Dokumente, RAG, Agenten Workflows und Transkript Nachbearbeitung interessant; laut VentureBeat verdoppeln sich die Kosten aber oberhalb von 200.000 Input Token.[10] Mit separat...
Veröffentlicht vonBearbeitet mit GPT-5.5Bilder erstellt mit GPT Image 2
xAIs offizielle Modelldokumentation listet grok 4.3 mit 1 Mio. Kontextfenster sowie 1,25 US Dollar je Mio.
Der Preis ist vor allem für lange Dokumente, RAG, Agenten Workflows und Transkript Nachbearbeitung interessant; laut VentureBeat verdoppeln sich die Kosten aber oberhalb von 200.000 Input Token.[10]
Mit separaten Speech to Text und Text to Speech APIs kann xAI stärker in Richtung Voice Plattform gehen.
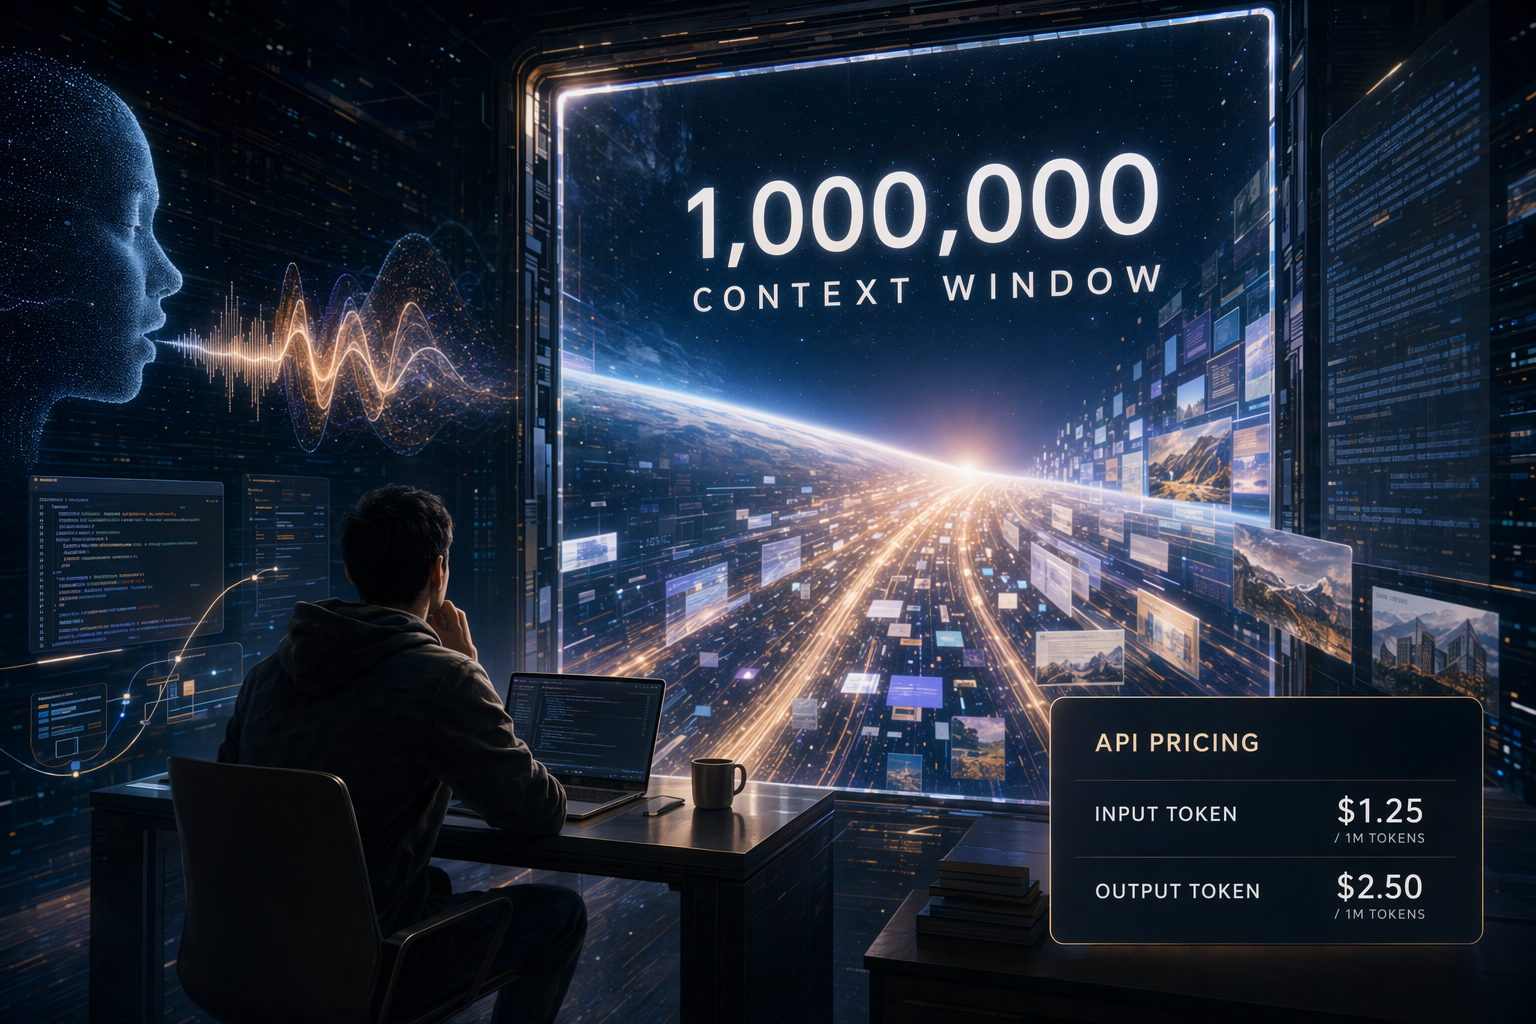
Grok 4.3 API 解讀:1M context、低 token 價,xAI 點樣攻模型同語音市場AI 生成概念圖,展示 Grok 4.3 API 的長上下文、token pricing 與語音 API 競爭。
KI-Prompt
Create a landscape editorial hero image for this Studio Global article: Grok 4.3 API 解讀:1M context、低 token 價,xAI 點樣攻模型同語音市場. Article summary: Grok 4.3 API 的硬賣點係 1M context window、每百萬 input token $1.25、output token $2.50;相對 xAI 早前 Grok 4 API 頁列出的 $3/$15 低好多,但 VentureBeat 指 200,000 input tokens 以上成本會倍增。[1][2][10]. Topic tags: ai, xai, grok, llm, ai agents. Reference image context from search candidates: Reference image 1: visual subject "# xAI launches Grok 4.3 and Custom Voices. xAI released **Grok 4.3**, a pretrained reasoning model with an always-on reasoning mode and a **1,000,000** token context window, accord" source context "xAI launches Grok 4.3 and Custom Voices | Let's Data Science" Reference image 2: visual subject "### FB 建議貼文. # **Grok 4.3 低調發表:價格大砍 60% 搶攻開發者!雖不敵 GPT-5.5 但靠「人味」與性價比突圍**. 馬斯克旗下的 xAI 近日悄然上線了 Grok 4.3,雖然馬斯克本人這次罕見地沒有大聲疾呼「改變世界」,但 Grok 4.3 卻以極具侵略性的價格與驚人的運算速度,在開發者圈引發熱
openai.com
Die Grok 4.3 API ist nicht einfach nur ein weiteres Modell in xAIs Modellliste. Interessant ist vor allem die Kombination aus langem Kontextfenster und vergleichsweise niedrigen Tokenpreisen. In der offiziellen xAI-Dokumentation wird grok-4.3 mit einem Kontextfenster von 1 Mio. Token sowie Preisen von 1,25 US-Dollar je Mio. Input-Token und 2,50 US-Dollar je Mio. Output-Token geführt.
Für Entwicklerteams ist das ein klares Signal: xAI will Workloads gewinnen, bei denen viele Eingabetoken anfallen — etwa lange Dokumente, Agenten mit vielen Zwischenschritten, Code-Analysen, Support-Verläufe oder nachgelagerte Verarbeitung von Sprachtranskripten. Die Frage ist deshalb weniger: „Ist Grok 4.3 das beste Modell?“ Sondern: „Für welche Aufgaben verschiebt dieses Preis-Kontext-Verhältnis die Kalkulation?“
Was bisher belastbar belegt ist
Der sicherste Anker ist die offizielle Modell- und Preistabelle von xAI. Sie nennt für grok-4.3 ein 1-Mio.-Token-Kontextfenster und die genannten Input-/Output-Preise. Einige weitergehende Angaben stammen dagegen aus Drittberichten: Ein Bericht spricht von einem vollständigen Rollout am 30. April 2026 und erwähnt native Videoeingabe; diese Details sind im bereitgestellten Ausschnitt der offiziellen Preisdokumentation aber nicht bestätigt.
Studio Global AI
Setzen Sie Ihre Recherche fort
Diese Seite enthält eine quellengestützte Antwort, die Sie in Studio Global fortsetzen können.
Wie lautet die kurze Antwort auf „Grok 4.3 API: Wie xAI mit 1 Mio. Kontext und günstigen Tokenpreisen Druck macht“?
xAIs offizielle Modelldokumentation listet grok 4.3 mit 1 Mio. Kontextfenster sowie 1,25 US Dollar je Mio.
Was sind die wichtigsten Punkte, die zuerst validiert werden müssen?
xAIs offizielle Modelldokumentation listet grok 4.3 mit 1 Mio. Kontextfenster sowie 1,25 US Dollar je Mio. Der Preis ist vor allem für lange Dokumente, RAG, Agenten Workflows und Transkript Nachbearbeitung interessant; laut VentureBeat verdoppeln sich die Kosten aber oberhalb von 200.000 Input Token.[10]
Was soll ich als nächstes in der Praxis tun?
Mit separaten Speech to Text und Text to Speech APIs kann xAI stärker in Richtung Voice Plattform gehen.
grok-4.3 wird mit 1 Mio. Token Kontextfenster gelistet.
Mehr Dokumente, Chatverläufe, Code oder Tool-Ausgaben können in eine Anfrage passen. Das ersetzt aber keine saubere Datenaufbereitung.
Tokenpreise
1,25 US-Dollar je Mio. Input-Token und 2,50 US-Dollar je Mio. Output-Token.
Attraktiv für Workloads mit viel Text: RAG, Dokumentenanalyse, Support-Zusammenfassungen, Code-Review und Agentenketten.
Nähe zu Voice-Workflows
xAI bietet zusätzlich eigenständige Speech-to-Text- und Text-to-Speech-APIs; laut MarkTechPost unterstützt die STT-API 25 Sprachen sowie Batch- und Streaming-Modi.
Damit lässt sich eine Pipeline aus Spracheingabe, LLM-Verarbeitung und Sprachausgabe bauen.
Noch vorsichtig behandeln
Native Videoeingabe, Custom Voices und Voice Cloning werden in Drittquellen erwähnt.
Der Preis: starkes Argument, aber nicht ohne Kleingedrucktes
Der auffälligste Vergleich kommt aus xAIs eigener Modelllandschaft. Eine andere xAI-API-Seite führt Grok 4 mit 256.000 Token Kontextfenster, 3,00 US-Dollar je Mio. Text-Input-Token und 15,00 US-Dollar je Mio. Output-Token; die Grok-4.3-Dokumentation nennt dagegen 1 Mio. Kontext sowie 1,25/2,50 US-Dollar je Mio. Input-/Output-Token.
Rechnerisch wäre Grok 4.3 damit beim Input rund 58 Prozent günstiger, beim Output rund 83 Prozent günstiger und beim Kontextfenster knapp 3,9-mal größer. Wichtig ist aber: Das ist ein Vergleich unterschiedlicher Listings und Modelle. Daraus sollte man keinen offiziellen Migrationsrabatt oder eine Garantie für identische Qualität ableiten.
Ein zweiter Vergleich stammt von VentureBeat. Demnach senkt Grok 4.3 gegenüber dem direkten Vorgänger Grok 4.2 die Einstiegspreise von ursprünglich 2/6 US-Dollar auf 1,25/2,50 US-Dollar je Mio. Input-/Output-Token. Derselbe Bericht weist jedoch darauf hin, dass diese Preise nur bis zu 200.000 Input-Token gelten und sich die Kosten oberhalb dieser Schwelle verdoppeln. Wer das 1-Mio.-Kontextfenster regelmäßig ausreizt, sollte deshalb nicht nur mit dem Headline-Preis rechnen.
Noch ein Detail verhindert eine zu einfache Erzählung: In derselben xAI-Modelltabelle werden auch mehrere Grok-4.20-Varianten mit 2 Mio. Token Kontextfenster und denselben Preisen von 1,25/2,50 US-Dollar geführt. Grok 4.3 ist also nicht automatisch das Modell mit dem größten Kontextfenster in xAIs Tabelle. Treffender ist: Es ist ein wichtiger Baustein in xAIs Versuch, Grok-4.x-Modelle über ein attraktives Verhältnis aus Preis und Kontextkapazität in Entwickler-Workloads zu bringen.
Wo 1 Mio. Kontext wirklich helfen kann
Ein großes Kontextfenster ist vor allem dann wertvoll, wenn Entwickler sonst viel Aufwand in Chunking, Zusammenfassungen, Retrieval-Logik oder Statusverwaltung stecken müssten. In Kombination mit dem Inputpreis von 1,25 US-Dollar je Mio. Token wird Grok 4.3 besonders für diese Szenarien interessant:
Lange Dokumente und Wissensbestände: Richtlinien, Berichte, Vertragsabschnitte, Supporthistorien oder technische Dokumentation können in größerem Umfang in eine Aufgabe einfließen.
RAG und Unternehmenssuche: Retrieval-Augmented Generation profitiert nicht automatisch von mehr Kontext, aber längere Trefferlisten und mehr Hintergrundmaterial lassen sich leichter testen.
Agenten-Workflows: Agenten können längere Systemanweisungen, frühere Schritte, Tool-Ausgaben und Nutzerkontext mitführen, ohne den Zustand ständig neu verdichten zu müssen.
Code- und Log-Analyse: Größere Ausschnitte aus Repositories, Fehlermeldungen und Laufzeitprotokollen können gemeinsam betrachtet werden.
Nachbearbeitung von Sprachtranskripten: Wenn die STT-API längere Gespräche oder Meetings transkribiert, kann ein LLM daraus Zusammenfassungen, Aufgabenlisten, Klassifikationen oder Antwortvorschläge erzeugen.
Der Haken: Ein großes Kontextfenster macht ein Modell nicht automatisch präziser. Wenn die Eingabedaten unsauber strukturiert sind, irrelevante Passagen dominieren oder keine guten Evaluationskriterien existieren, kann auch ein langes Prompt zu falschen oder lückenhaften Antworten führen. Für produktive Systeme zählt daher nicht nur die theoretische Kontextlänge, sondern die gemessene Qualität mit den eigenen Daten: Trefferquote, Halluzinationsrate, Latenz und tatsächliche Rechnung pro Anfrage.
Was das für den Modellmarkt bedeutet
xAI konkurriert mit Grok 4.3 nicht nur über Modellleistung, sondern über Kostenstruktur. Ein 1-Mio.-Token-Kontextfenster zu 1,25/2,50 US-Dollar je Mio. Input-/Output-Token ist ein gutes Argument, um in Model-Routing, Langdokument-Tests und Agenten-Benchmarks aufgenommen zu werden.
Das heißt aber nicht, dass Grok 4.3 damit automatisch etablierte Spitzenmodelle in allen Disziplinen überholt. Die vorliegenden Quellen reichen nicht aus, um eine generelle Führungsposition bei Reasoning, Coding, Multimodalität oder Zuverlässigkeit zu belegen. Eine Drittanalyse zum Grok-API-Pricing weist zudem darauf hin, dass xAI im Vergleich zu einigen Wettbewerbern noch eine jüngere Plattform mit kleinerem Entwicklerökosystem ist.
Für Teams ist die pragmatische Schlussfolgerung: Grok 4.3 gehört auf die Testliste, wenn Tokenkosten und langer Kontext entscheidend sind. Es ersetzt aber nicht die eigene Evaluation gegen bestehende Modelle, Monitoring-Tools, Sicherheitsanforderungen und Integrationsaufwand.
Die Voice-Strategie: xAI will mehr als Chatmodelle verkaufen
Besonders spannend ist die Verbindung zu Sprache. MarkTechPost berichtet, dass xAI eigenständige Speech-to-Text- und Text-to-Speech-APIs eingeführt hat. Diese sollen auf derselben Infrastruktur basieren, die auch Grok Voice in mobilen Apps, Tesla-Fahrzeugen und dem Starlink-Kundensupport antreibt; damit tritt xAI in einen Markt ein, in dem Anbieter wie ElevenLabs, Deepgram und AssemblyAI aktiv sind.
Kombiniert man diese Voice-APIs mit Grok 4.3, entsteht eine recht klare Produktlogik: STT nimmt Sprache auf, Grok 4.3 verarbeitet Inhalt und Kontext, TTS gibt die Antwort wieder aus. Das ist relevant für Voice Agents, Kundenservice, Meeting-Workflows, Sprachassistenten und Anwendungen, bei denen Nutzer nicht primär tippen wollen.
Trotzdem entscheidet sich der Voice-Markt nicht allein daran, ob APIs vorhanden sind. Für die Praxis zählen Transkriptionsgenauigkeit, Streaming-Latenz, Natürlichkeit der Stimme, Qualität über mehrere Sprachen hinweg, Rechte- und Zugriffskontrollen, Compliance sowie Preisgestaltung. Custom Voices oder Voice Cloning werden zwar in Drittberichten erwähnt, sollten aber vor produktiver Nutzung anhand offizieller Spezifikationen und Sicherheitsrichtlinien geprüft werden.
Fünf Fragen vor dem Einsatz
Ist der eigene Workload wirklich tokenintensiv? Bei kurzen Prompts und kurzen Antworten bringt ein 1-Mio.-Kontextfenster wenig.
Werden regelmäßig mehr als 200.000 Input-Token genutzt? Laut VentureBeat verdoppeln sich die Kosten oberhalb dieser Schwelle; das gehört in jede Kostenrechnung.
Wie gut arbeitet das Modell mit den eigenen Langkontext-Daten? Entscheidend sind Tests mit echten Dokumenten, Codebasen, Tickets oder Transkripten.
Braucht die Voice-Funktion Produktionsniveau? STT/TTS, Streaming, Sprachabdeckung und Latenz sollten getrennt evaluiert werden; die STT-API wird mit 25 Sprachen sowie Batch- und Streaming-Modi beschrieben.
Reicht das Plattform-Ökosystem aus? Niedrige Preise helfen wenig, wenn Monitoring, Tooling, Support, Governance oder Compliance-Prozesse nicht passen; Drittanalysen sehen xAIs Entwicklerökosystem noch kleiner als das mancher Wettbewerber.
Fazit: Ein ernstzunehmender Testkandidat, kein Freifahrtschein
Der am besten belegte Verkaufshebel von Grok 4.3 ist klar: xAIs Dokumentation listet 1 Mio. Token Kontext und 1,25/2,50 US-Dollar je Mio. Input-/Output-Token. Für lange Dokumente, RAG, Agenten, Batch-Analysen und die Nachbearbeitung von Sprachtranskripten kann das die Kostenrechnung spürbar verändern.
Strategisch erzählt xAI damit eine größere Geschichte: nicht nur ein Chatmodell, sondern ein Entwicklerstack aus LLM, langem Kontext, niedrigen Tokenkosten und separaten STT/TTS-APIs. Gleichzeitig bleiben native Videoeingabe, Voice Cloning und manche Leistungsbehauptungen in den vorliegenden Quellen vor allem Drittberichte. Wer Grok 4.3 produktiv nutzen will, sollte deshalb nicht auf Schlagworte setzen, sondern auf offizielle Abrechnung, eigene Benchmarks und Tests unter realen Produktionsbedingungen.
venturebeat.com
xAI launches Grok 4.3 at an aggressively low price and a new, fast ...